Das KI-Bereitschafts-Audit: Datenarchitektur für agentische Automatisierung vorbereiten
Agentische Automatisierung scheitert selten zuerst am Modell. Dieser Leitfaden zeigt, wie KMU einen realen Workflow auf Quellen, Datenklassen, Berechtigungen, Review-Gates und Nachweise prüfen.
Inhalt
Agentische Automatisierung scheitert selten zuerst am Modell. Dieser Leitfaden zeigt, wie KMU einen realen Workflow auf Quellen, Datenklassen, Berechtigungen, Review-Gates und Nachweise prüfen.
Artikel teilen
Der KI-Agent fragt nach Daten, die niemand besitzt
Nora führt eine technische Dienstleistungsfirma mit 42 Mitarbeitenden. Der Vertrieb möchte eingehende Anfragen schneller sortieren: Welche Leads sind dringend? Welche brauchen technische Rückfragen? Welche passen nicht zum Angebot? Ein KI-Assistent soll die Nachrichten lesen, priorisieren und Elena, der Vertriebsleiterin, einen nächsten Schritt vorschlagen.
Im ersten Workshop klingt das Projekt klein. Die Firma verarbeitet rund 140 Anfragen pro Woche, 650 Support-E-Mails pro Monat und hat etwa 2.400 CRM-Kontakte. Es gibt drei SaaS-Systeme, zwei gemeinsame Postfächer, zwölf wiederkehrende Tabellen und einen ersten n8n-Testworkflow. Dann beginnt das eigentliche Audit. Das CRM enthält Dubletten. E-Mail-Anhänge sind neuer als CRM-Notizen. Die Preistabelle gehört Finance. Support-Ausnahmen stehen in einer internen Runbook-Seite, aber nicht im Help Center. Niemand kann sagen, welche Quelle gewinnt, wenn diese Informationen widersprechen.
Dieses Beispiel ist illustrativ, kein Planfold-Kundenfall und kein Benchmark. Es zeigt aber den praktischen Punkt: Ein KI-Agent braucht nicht zuerst mehr Autonomie. Er braucht eine verlässliche Betriebsgrundlage. Wenn der Workflow nicht weiß, welche Quelle gilt, welche Datenklasse erlaubt ist, wer prüft und welcher Nachweis bleibt, beschleunigt der Agent nicht den Vertrieb. Er beschleunigt die Unklarheit.
KI-Bereitschaft beginnt nicht beim Modell
Viele KI-Diskussionen starten mit der falschen Frage: Welches Modell nehmen wir? Für einen echten Unternehmensworkflow kommt diese Frage später. Vorher muss klar sein, was der Workflow überhaupt tun darf. Darf er nur lesen? Darf er einen Entwurf schreiben? Darf er priorisieren? Darf er ein CRM-Update vorbereiten? Darf er etwas senden? Oder muss er stoppen, weil Finanz-, Vertrags-, Mitarbeiter- oder unklare Kundendaten betroffen sind?
Der NIST AI RMF Playbook Map unterstützt genau diese Vorarbeit. Die Map-Funktion fragt nach Kontext, Zweck, Einsatzumgebung, Annahmen, Rollen, Anforderungen, menschlicher Beteiligung und laufender Überwachung. Für ein KMU lässt sich das pragmatisch übersetzen: Bevor ein Agent Teil des Betriebs wird, braucht ein konkreter Workflow einen Aufgabenvertrag, eine Quellenkarte, klare Review-Rollen und einen Lebenszyklus-Owner.
Gute Prompts reparieren keine widersprüchlichen Quellen. Ein größerer Kontext ersetzt keine Datenklassifizierung. Ein besseres Modell weiß nicht automatisch, ob die E-Mail von gestern die CRM-Notiz von letzter Woche überschreibt. KI-Bereitschaft ist deshalb weniger ein Tool-Vergleich als ein Datenarchitektur-Audit für einen bestimmten Arbeitsablauf.
Der Unterschied zum Chatbot ist entscheidend. Ein Chatbot beantwortet eine Frage in einer Oberfläche. Ein agentischer Workflow liest Quellen, ruft Systeme auf, erzeugt Vorschläge, routet Aufgaben oder bereitet Änderungen vor. Je näher dieser Workflow an Kundenkommunikation, Angebot, Support, CRM oder Finance kommt, desto mehr zählt die Architektur um das Modell herum.
Die fünf Datenlücken, die agentische Automatisierung brechen
Ein KI-Bereitschafts-Audit sucht nicht nach abstrakter Perfektion. Es sucht die fünf Lücken, die aus einem nützlichen Assistenten einen unsicheren Betriebsweg machen.
Silo-Lücke: Relevante Daten liegen in mehreren Systemen. CRM, Postfach, Help Center, Tabellen, Tickets und Teamwissen enthalten jeweils einen Teil der Wahrheit. Wenn der Workflow nicht weiß, welche Quelle für welchen Fall zuständig ist, entsteht ein plausibler, aber falscher Kontext.
Qualitäts-Lücke: Veraltete oder doppelte Einträge wirken maschinenlesbar. Ein CRM-Datensatz kann formal vollständig und fachlich falsch sein. Eine Support-Antwort kann aus einer alten Ausnahme entstehen, die heute nicht mehr gilt. Der Agent sieht Struktur, aber nicht automatisch Aktualität.
Semantik-Lücke: Teams nutzen dieselben Felder für unterschiedliche Bedeutungen. "Priorität hoch" kann im Vertrieb Umsatzchance heißen, im Support Eskalation und in Operations Liefertermin. Ohne semantische Regeln erzeugt der Workflow scheinbar einheitliche Kategorien, die intern etwas anderes bedeuten.
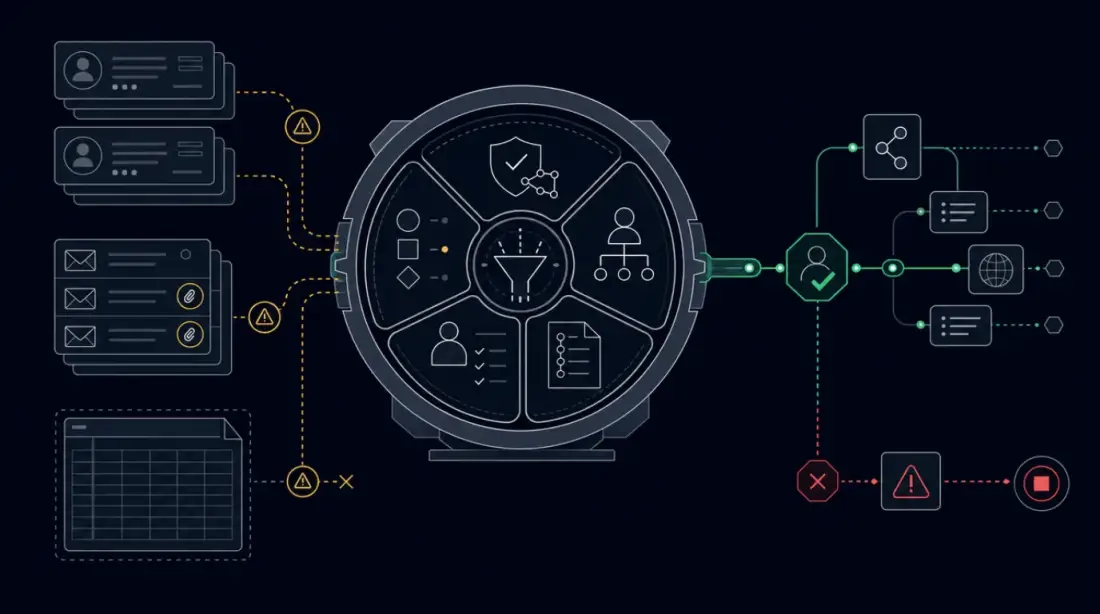
Berechtigungs-Lücke: Der Workflow kann mehr lesen, als er sollte. Kundennotizen, Finanzfelder, Vertragsinformationen und Mitarbeiterdaten landen oft in denselben Exporten. Wenn der technische Zugriff breiter ist als der fachliche Zweck, entsteht ein Datenrisiko, bevor Automatisierung überhaupt nützlich wird.
Nachweis-Lücke: Niemand kann später rekonstruieren, was entschieden wurde. Welche Quelle wurde gelesen? Welche Workflow-Version lief? Was hat die KI vorgeschlagen? Wer hat korrigiert, freigegeben, abgelehnt oder gestoppt? Ohne diese Spur wird jede Fehlersuche zur Erinnerungssitzung.
Die OWASP Top 10 for Large Language Model Applications geben dafür nützliche Risikobegriffe: Prompt Injection, sensitive Informationspreisgabe, übermäßige Handlungsmacht und zu großes Vertrauen in KI-Ausgaben. Für KMU heißt das nicht, jedes KI-Projekt mit Angst zu behandeln. Es heißt: Quellen, Rechte, Handlungsspielraum und Review müssen vor der Automatisierung enger gebaut werden als bei einem gewöhnlichen Textassistenten.
Wenn Sie diese fünf Lücken ignorieren, wird der erste produktive Agent zur Detektivarbeit. War das Ergebnis falsch, weil das Modell schwach war? Weil die Quelle alt war? Weil ein Feld doppelt gepflegt wurde? Weil ein Mitarbeiterdatenfeld in den Prompt geraten ist? Oder weil der Mensch im Review keine ausreichende Entscheidungsgrundlage hatte? Ein Audit reduziert diese Mehrdeutigkeit, bevor sie im Betrieb teuer wird.
Das Readiness-Audit für einen echten Workflow
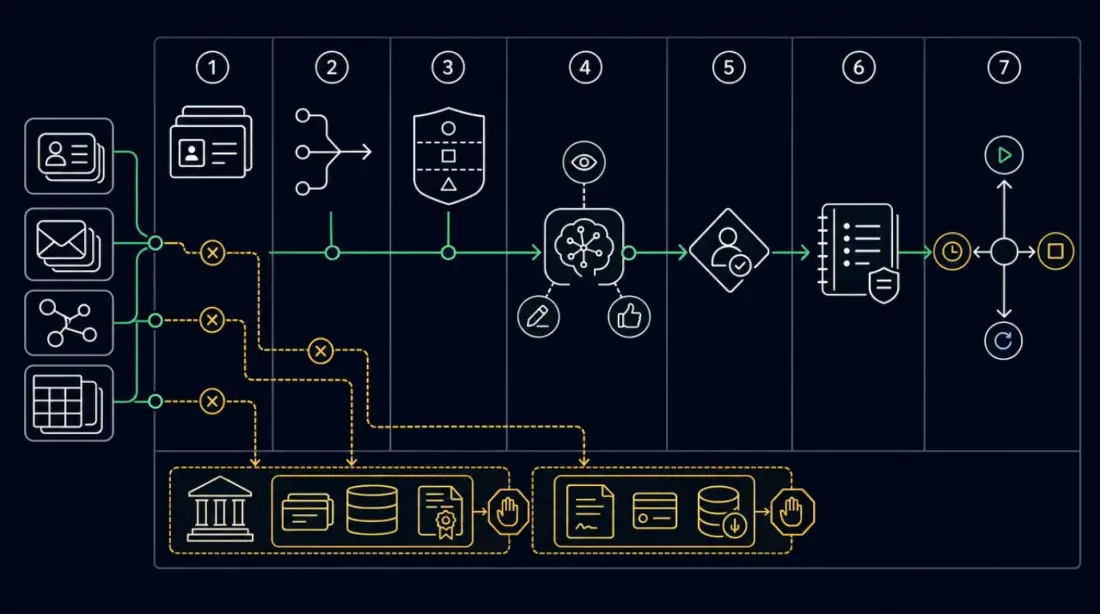
Das Audit bleibt klein, wenn es sich auf einen Workflow konzentriert. Nicht "KI im Unternehmen". Nicht "Agentenstrategie". Wählen Sie eine konkrete Strecke: Anfrage-Triage, Support-Entwurf, Angebotsvorbereitung, Meeting-to-Task oder interne Wissenssuche. Danach füllen Sie sieben Felder aus: Quelle, Owner, Datenklasse, erlaubte KI-Aktion, menschliche Freigabe, Nachweis und Entscheidung.
| Audit-Feld | Leitfrage | Gutes Startsignal | Warnsignal |
|---|---|---|---|
| Quelle | Welche Systeme braucht der Workflow? | Quelle und Zweck sind benannt | CRM, E-Mail und Tabelle widersprechen sich |
| Wahrheitsquelle | Welche Quelle gewinnt bei Konflikt? | Fachliche Regel ist dokumentiert | "Das weiß normalerweise Elena" |
| Datenklasse | Welche Daten dürfen in den KI-Schritt? | öffentlich, intern, Kunde oder blockiert ist klar | Finanz-, Vertrags- oder Mitarbeiterdaten liegen im selben Export |
| Erlaubte Aktion | Darf die KI beobachten, entwerfen, empfehlen, ein Update vorbereiten oder stoppen? | Aktion ist eng und reversibel | Workflow darf senden oder schreiben, bevor Review existiert |
| Review-Gate | Wer prüft mit Kontext und Autorität? | Reviewer hat Entscheidungsspielraum | Freigabe ist nur ein Klick ohne Quellen |
| Nachweis | Was bleibt im Log? | Quelle, Version, Entscheidung und Korrektur sind sichtbar | Fehler werden aus Chatverläufen rekonstruiert |
| Entscheidung | Starten, begrenzen, umbauen oder verschieben? | kleinster sicherer Startpunkt ist erkennbar | alles soll sofort autonom laufen |
Die Entscheidungsstufen sollten einfach bleiben. Observe heißt: lesen, zusammenfassen, klassifizieren. Draft heißt: Text oder Aufgabe vorbereiten, nicht senden. Recommend heißt: priorisieren oder nächsten Schritt vorschlagen, Mensch entscheidet. Prepare update heißt: Systemänderung vorbereiten, Owner gibt frei. Stop heißt: an einen Menschen routen, weil Datenklasse, Quelle oder Verantwortung nicht geklärt sind.
Dieses Modell ist bewusst enger als viele KI-Versprechen. Es verhindert, dass aus einem hilfreichen Assistenten unbemerkt ein Produktionsagent wird. Gleichzeitig macht es den Start leichter: Wenn ein Workflow nur lesen und priorisieren darf, kann er früher getestet werden als ein Workflow, der Kundennachrichten sendet oder CRM-Felder schreibt.
Praxisbeispiel: Anfrage-Triage mit menschlicher Freigabe
Zurück zu Nora, Elena, Marie und Jonas bei einem DACH-basierten B2B-Technikdienstleister mit 42 Mitarbeitenden. Das Szenario ist ein illustratives DACH-Szenario: 42 Mitarbeitende, kein dediziertes Plattformteam, aber genug digitale Werkzeuge, um echte Reibung zu erzeugen. Nora will einen sichtbaren ersten Automatisierungsfall. Elena möchte Leads schneller sortieren. Marie will Support-Entwürfe, die nicht an altem Wissen hängen. Jonas kann APIs, n8n-Workflows, Credentials und Logs betreuen, aber nur neben anderen Aufgaben.
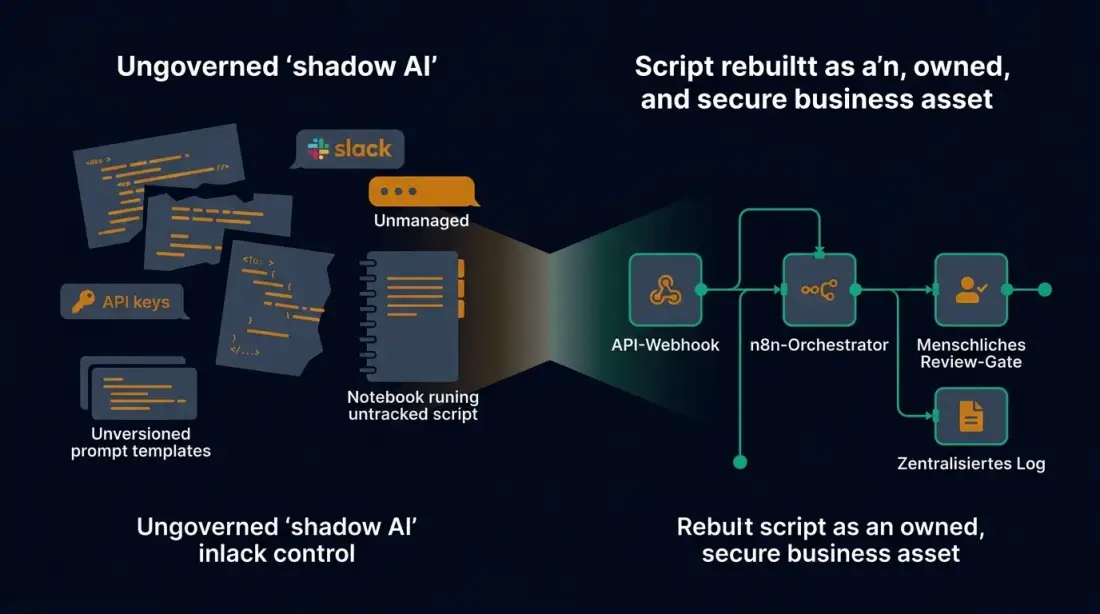
Vor dem Audit ist die Anfrage-Triage personenabhängig. Elena liest E-Mails, prüft CRM-Kontext, sucht Serviceinformationen, fragt bei Operations nach und schreibt manuell nächste Schritte. Manche Anfragen werden schnell beantwortet. Andere hängen, weil die Preisinformation aus Finance nicht mit der alten CRM-Notiz zusammenpasst. Der KI-Testlauf könnte Nachrichten zusammenfassen, aber er weiß nicht, welche Daten er nicht anfassen darf.
Nach dem Audit wird der Workflow enger. Öffentliche und interne Serviceinformationen sind erlaubt. Definierte CRM-Felder dürfen gelesen werden. Finanz- und Vertragsdaten sind zunächst blockiert. Der Agent klassifiziert Anfrageart, fehlende Informationen und grobe Priorität. Er bereitet eine interne Zusammenfassung und einen Antwortentwurf vor. Elena bestätigt Priorität und nächsten Schritt. Keine Kundenmail wird automatisch gesendet. Kein CRM-Feld wird geschrieben, bis Jonas Feldmapping, Rollback und Fehlerpfad geprüft hat.
n8n kann hier die kontrollierte Workflow-Schicht sein. Die Dokumentation beschreibt Execution History, Error Handling und Muster für Human Fallback in AI Workflows. Das ist keine Governance-Automatik und keine Compliance-Garantie. Es ist eine technische Grundlage, um Ausführung, Fehler, menschliche Übergaben und Review-Kontext nicht aus Erinnerung rekonstruieren zu müssen.
Das Ergebnis ist kein autonomer Vertriebsagent. Es ist ein operierbarer erster Schritt: bessere Sortierung, klarere Datenränder, nachvollziehbare Review-Entscheidungen und ein Muster, das später auf Support-Entwürfe oder Angebotsvorbereitung übertragen werden kann. Der Wert entsteht durch Begrenzung.
Wie Planfold die Datenarchitektur für Automatisierung baut
Planfold behandelt KI-Automatisierung als Betriebsarchitektur, nicht als Modell-Einkauf. Der erste Schritt ist deshalb nicht ein Prompt-Workshop, sondern eine Karte: Welche technische Schuld steckt im Workflow? Welche Quellen existieren? Welche Datenflüsse sind offiziell, welche nur Gewohnheit? Wer besitzt die Entscheidung? Welche Credentials werden gebraucht? Wo muss der Workflow stoppen?
Plan heißt: Datenflüsse, technische Schuld, Datenklassen, Owner, Systemgrenzen, Review-Punkte und Stopppfade auditieren. Bei einem kleinen Unternehmen muss das kein Konzernprogramm sein. Eine Quellenkarte, ein Aufgabenvertrag und eine Entscheidungstabelle reichen oft, um zu sehen, ob ein Workflow beobachtet, entworfen, empfohlen oder verschoben werden sollte.
Unfold heißt: die kontrollierte Workflow-Schicht bauen. Dazu gehören APIs statt manueller Exporte, n8n-Orchestrierung statt privater Shortcuts, dedizierte Credentials statt persönlicher Konten, Freigabeschritte statt stiller Aktionen und Logs statt Chat-Screenshots. Wenn Datenkontrolle, Isolation, Portabilität oder laufender Betrieb wichtiger werden, kann die Infrastruktur DACH-gehostet, selbst betrieben oder cloud-nativ aufgebaut werden. Kubernetes, CKA/CKAD-Kompetenz und Linux-Betrieb sind dann Fähigkeitssignale für den Betrieb, keine Compliance-Abzeichen.
Resonate heißt: Betriebssignale auswerten. Wie viele Vorschläge wurden akzeptiert, korrigiert, abgelehnt oder eskaliert? Welche Quellen fehlen häufig? Wo klicken Menschen zu schnell auf Freigabe? Welche Fehler treten wiederholt auf? Diese Signale entscheiden, ob der Agent enger, breiter oder gar nicht weiter automatisiert wird.
Regulatorische Themen bleiben dabei sauber begrenzt. Die Europäische Kommission beschreibt den AI Act als risikobasierten Rahmen mit Anforderungen rund um Datenqualität, Logging, Dokumentation, menschliche Aufsicht, Robustheit und Sicherheit für bestimmte Rollen und Systeme. Dieser Artikel ist keine Rechtsberatung, keine Systemklassifizierung und kein Compliance-Check. Er beschreibt die Architekturarbeit, die Gespräche mit Recht, Datenschutz, Kunden oder Auditoren belastbarer macht: Zweck, Daten, Owner, Review, Nachweis und Stoppweg.
Der erste Schritt: ein 30-Tage-Datenarchitektur-Audit
Ein gutes KI-Bereitschafts-Audit muss klein genug sein, um wirklich stattzufinden. Vier Wochen reichen, um einen Workflow aus Bauchgefühl in eine belastbare Startentscheidung zu bringen.
Woche 1: Quellenkarte. Sammeln Sie alle Quellen, die der Workflow heute nutzt oder nutzen müsste: CRM, Postfach, Help Center, Tabellen, Ticketverlauf, interne Runbooks, Dokumente und Teamwissen. Markieren Sie Konflikte. Schreiben Sie für jeden Konflikt auf, welche Quelle in welchem Fall gewinnt.
Woche 2: Datenklassen und Owner. Ordnen Sie Felder und Dokumente in Datenklassen: öffentlich, intern, Kunde, Mitarbeiter, Finance, Vertrag oder blockiert. Benennen Sie fachliche Owner, technische Owner, Reviewer und Eskalationswege. Wenn niemand Owner sein will, ist der Workflow nicht bereit.
Woche 3: Review-Gate und Stopppfad. Definieren Sie, welche KI-Aktion erlaubt ist und wann ein Mensch entscheiden muss. Legen Sie Stopppfade für unklare Quellen, sensible Daten und fehlende Freigaben fest. Ein guter Stopppfad ist kein Scheitern. Er verhindert, dass ein unklarer Fall als automatisierter Normalfall behandelt wird.
Woche 4: erster kontrollierter Automatisierungsfall. Wählen Sie den kleinsten sicheren Startpunkt. Oft ist das ein read-only oder draft-only Workflow: klassifizieren, zusammenfassen, Entwurf vorbereiten, Mensch entscheidet. Erst wenn Quellen, Review und Nachweis stabil sind, wird über vorbereitete Updates oder mehr Autonomie gesprochen.
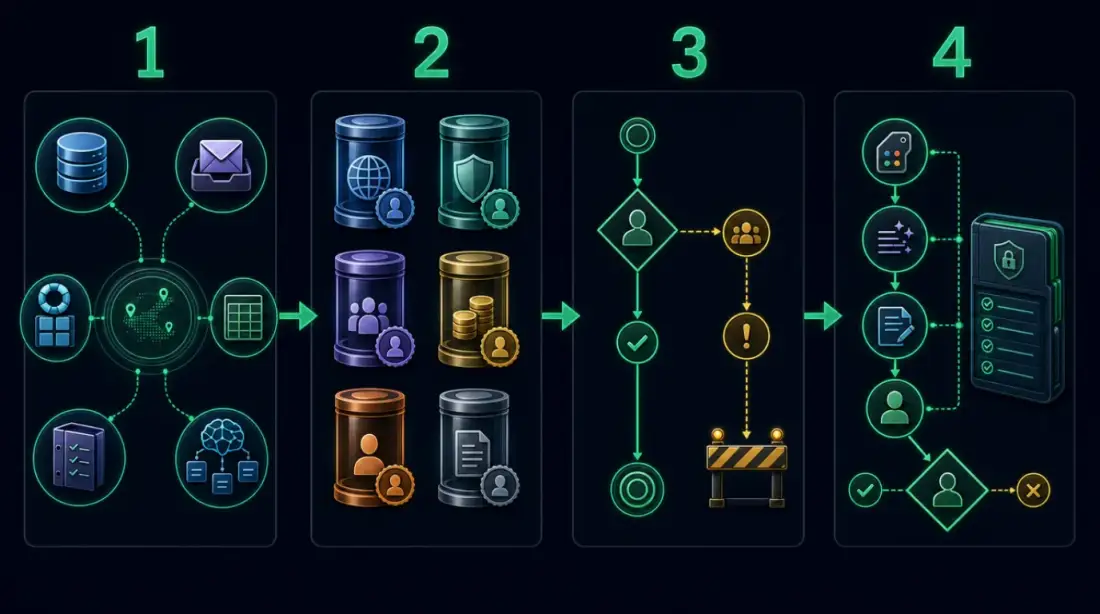
Der praktische nächste Schritt ist nicht "mehr KI". Es ist ein Workflow, eine Quellenkarte, ein Review-Gate und ein Logmodell. Wenn diese vier Dinge fehlen, ist der Agent zu früh im Betrieb. Wenn sie klar sind, kann Planfold daraus eine Roadmap und eine kontrollierte Automatisierung bauen, die Ihr Team versteht, betreibt und wieder stoppen kann.
Planen. Entfalten. Souverän bleiben.
Verwandte Artikel
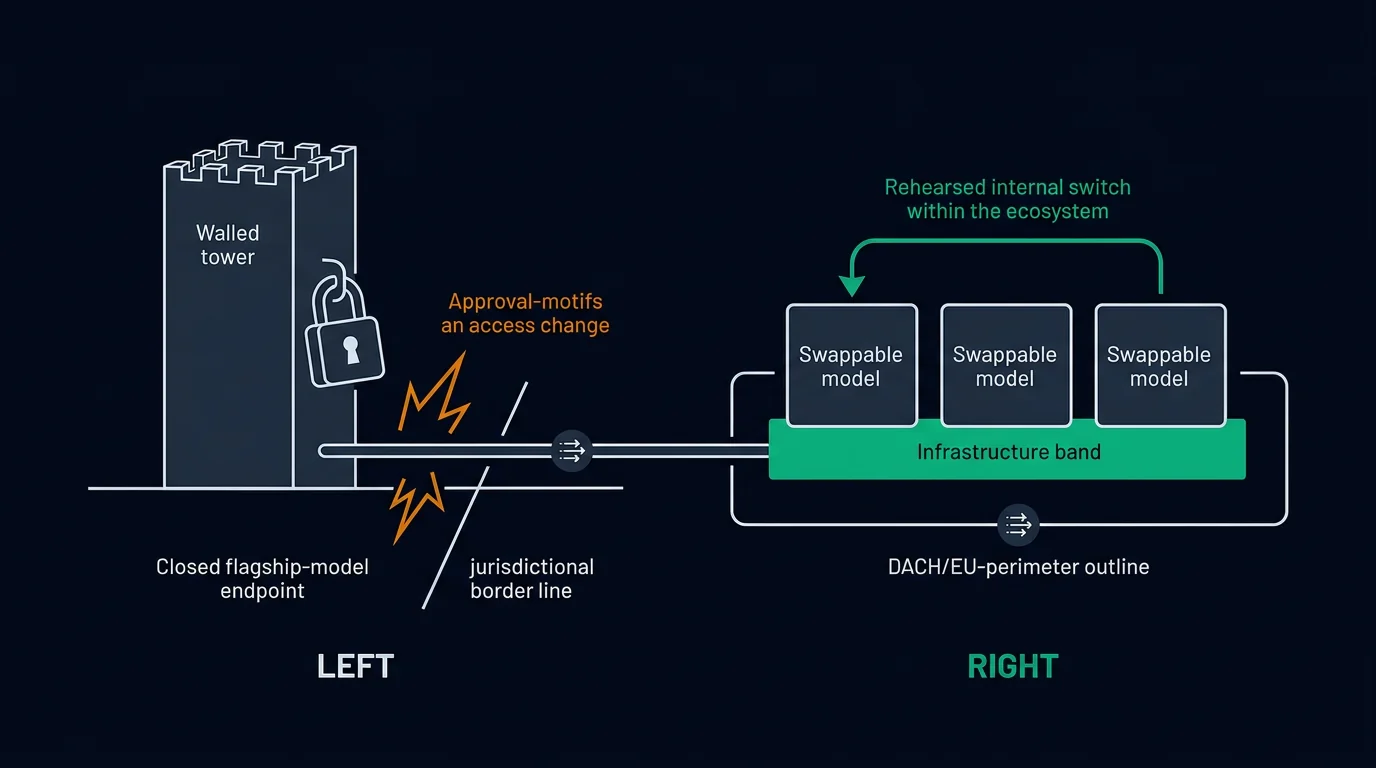
Wenn ein fremder Staat Ihren KI-Zugang kontrolliert: Souveräne KI-Beschaffung als Risikoentscheidung für KMU
Die Ökonomie offener KI-Modelle: Wann sich Self-Hosting für KMU wirtschaftlich rechnet