Die Ökonomie offener KI-Modelle: Wann sich Self-Hosting für KMU wirtschaftlich rechnet
API oder Self-Hosting: Wie KMU Qualität, Auslastung, Betriebskosten und Datenverarbeitung für einen konkreten KI-Workflow vergleichen.
Inhalt
API oder Self-Hosting: Wie KMU Qualität, Auslastung, Betriebskosten und Datenverarbeitung für einen konkreten KI-Workflow vergleichen.
Artikel teilen
Die Token-Rechnung, die niemand kommen sah
Ein mittelständischer DACH-Beratungsbetrieb mit rund 30 Mitarbeitenden hatte eine erste Assistenzlösung im Backend erprobt: ein Assistenzfeature, das aus internen Recherche-Notizen fertige Kundenzusammenfassungen entwarf. Auf der geschlossenen API eines großen Modellanbieters lief das Feature drei Monate stabil – bis die Monatsrechnung plötzlich um ein Vielfaches über dem erwarteten Rahmen lag. Ein fehlerhafter Prompt-Loop hatte still im Hintergrund Millionen zusätzlicher Token erzeugt. Der Anbieter bot keine harte Kostenobergrenze, sondern nur ein Dashboard, das niemand regelmäßig beobachtete.
Dieses Szenario ist illustrativ, kein gemessener Kundenfall und kein Benchmark. Es beschreibt aber den Moment, in dem KI für ein KMU von einem Werkzeug zum finanziellen Risiko wird. Das Feature wurde nicht abgeschaltet, weil es inhaltlich scheiterte. Es wurde reduziert, weil sein Preis unberechenbar geworden war. Genau hier beginnt die eigentliche Frage der KI-Ökonomie: Nicht „welches Modell ist am besten?", sondern „wer kontrolliert Kosten, Datenort und Ausstieg?".
Viele KMU sind über 2024 und 2025 genau diesen einfachen Weg gegangen: gemietete APIs mit nutzungsabhängiger Abrechnung und sitzbasierte KI-Bündel in bestehenden Softwareverträgen. Das verschafft schnell Fähigkeit. Es baut aber keine Betriebsgrundlage auf. Wenn die nächste Rechnung steigt oder der nächste Vertrag die Bedingungen ändert, fehlt der Ausstiegspfad. Die KI-Fähigkeit existiert – die Kontrolle über Kosten, Datenlage, Audit-Trail und Exit fehlt.
Was die KI-Ökonomie für ein KMU bedeutet
KI-Ökonomie ist für ein KMU kein Benchmark-Vergleich. Sie ist die Frage, wie AI finanziell und rechtlich im Unternehmen steht: als gemietete Fähigkeit mit nutzungsabhängiger Abrechnung oder als eigene, selbst betriebene Fähigkeit mit planbaren Kosten. Drei Begriffe bestimmen diese Entscheidung.
Nutzungsabhängige Abrechnung koppelt Kosten an verbrauchte Eingabe- und Ausgabetoken oder andere Einheiten. Preis, Caching und Werkzeugaufrufe hängen vom Anbieter ab. Ein Fehler im Workflow kann Mehrverbrauch auslösen; deshalb braucht der Betrieb Budgetkontrollen, begrenzte Wiederholungen und geprüfte Stopps. Ob der Anbieter eine harte Grenze anbietet, muss konkret geprüft werden.
Sitzbasierte Bündel bedeuten: KI-Funktionen werden in bestehende Softwarepakete integriert und über die Laufzeit auf alle Nutzenden umgelegt – auch auf die, die die Funktion kaum nutzen. Das senkt die Einstiegshürde, verteuert aber die gesamte Suite und macht es schwer, auf einen kleineren Tarif zurückzufallen.
Selbst betriebene KI führt herunterladbare Modellgewichte auf gewählter Infrastruktur aus. Zur Kalkulation gehören Hardware oder GPU-Miete, Auslastung, Energie, Wartung und Bereitschaft. Gewichte werden unter ihrer jeweiligen Lizenz genutzt; sie werden durch das Herunterladen nicht automatisch Eigentum des Unternehmens. Datenkontrolle hängt außerdem von Hosting, Zugängen, Telemetrie und weiteren angebundenen Diensten ab.
Ein nüchterner Punkt bleibt über alle drei Wege hinweg gültig: Die KI-Fähigkeit allein ist kein Geschäftswert. Erst eine Betriebsschicht – wer darf was lesen, wer prüft, wo stehen die Daten, was bleibt im Log, wie wird ausgestiegen – macht aus einer günstigen oder starken API eine kontrollierte, wiederholbare, verantwortbare Fähigkeit. Den meisten KMU fehlt genau diese Schicht.
Die versteckten Kosten gemieteter KI
Die offensichtliche Rechnung ist die Token-Rechnung. Die teureren Kosten sind die, die nicht monatlich auf dem Dashboard stehen. Sie zeigen sich erst, wenn ein Vertrag erneuert oder ein Datenfluss geprüft wird.
Token-Volatilität: Nutzungsabhängige Abrechnung bedeutet, dass Spitzenlasten direkt durchschlagen. Ein beliebtes internes Feature, ein neues Team oder ein fehlerhafter Loop vervielfachen den Verbrauch, ohne Vorwarnung. Das Budget für KI wird so zur Schätzung statt zur Planzahl.
Vertragsänderungen zur Laufzeit: Anbieter ändern Nutzungsbedingungen und Datenverarbeitungswege auch innerhalb einer Laufzeit. Ein DACH-Dienstleister – illustrativ – stellt fest, dass sein KI-Assistent kundennahe Anfragen an einen Endpunkt außerhalb der vereinbarten Datenregion gesendet hat und damit die eigene Datenverarbeitungsvereinbarung verletzt. Ein selbst betriebener Fallback war nie konfiguriert.
Paketänderungen bei der Verlängerung: Microsofts offizielle FAQ nennt den 1. Juli 2026 als Beginn bestimmter Preisänderungen; Bestandsverträge wechseln bei der nächsten Verlängerung. Betroffene Produkte, Funktionen und lokale Preise unterscheiden sich. Daraus folgt keine allgemeine Aussage, dass jede Suite teurer oder ein kleinerer Tarif ausgeschlossen wäre.
Regionale Verarbeitung: Die OpenAI-Preisseite nennt am 14. Oktober 2026 einen Aufschlag von zehn Prozent für regionale Verarbeitung bei dafür geeigneten Modellen ab dem 5. März 2026. Speicherung, Verarbeitung und verfügbare Regionen sind getrennt zu prüfen. Ein solcher Tarifpunkt belegt weder eine allgemeine Branchenregel noch, dass Self-Hosting insgesamt günstiger wäre.
Abhängigkeiten beim Wechsel: Eine geschlossene API liefert normalerweise keine herunterladbaren Gewichte. Eigene Prompts, Daten, Tests und Orchestrierung können trotzdem exportierbar und weiter nutzbar sein. Entscheidend ist, ob das Unternehmen diese Artefakte kontrolliert und einen Modellwechsel fachlich geprüft hat. Auch ein selbst betriebenes Modell benötigt passende Hardware und eine tragfähige Lizenz.
Fünf Warnsignale, dass Ihre KI Sie vermietet
Bevor ein KMU teure Architekturentscheidungen trifft, helfen praktische Signale, die sich im eigenen Betrieb wiedererkennen lassen. Fünf Warnsignale zeigen, dass die KI das Unternehmen eher vermietet als befähigt.
- Nutzungsabhängige Abrechnung ohne harte Obergrenze. Es gibt ein Dashboard, aber keinen Stop-Mechanismus, der bei einer bestimmten Kostenmarke verbindlich anhält.
- Daten verlassen die vereinbarte Region. Weder ist dokumentiert, wo die Inferenz läuft, noch wohin Anfragedaten fließen – und der Vertrag deckt den tatsächlichen Datenweg nicht ab.
- KI-Sitze, die niemand bewusst gewählt hat. Die Suite ist teurer geworden, weil KI-Funktionen hinzugebündelt wurden, nicht weil das Team sie angefordert hat.
- Kein Audit-Trail. Niemand kann später rekonstruieren, welche Modellversion lief, was vorgeschlagen wurde, wer freigegeben oder korrigiert hat und warum.
- Kein Ausstiegspfad. Es existiert kein Plan, wie die Fähigkeit auf anderer Infrastruktur, mit einem anderen Modell oder ohne den aktuellen Anbieter weiterlaufen könnte.
Wer diese Signale ignoriert, erlebt das gleiche Muster wie bei ungeprüfter SaaS-Ausbreitung, nur auf der sensibleren KI-Ebene: Die Fähigkeit wächst, die Beherrschbarkeit schrumpft. Genau dieses unkontrollierte KI ist es, was ein regulierter, selbst betriebener Pfad ersetzen soll.
Modellqualität und Kosten getrennt prüfen
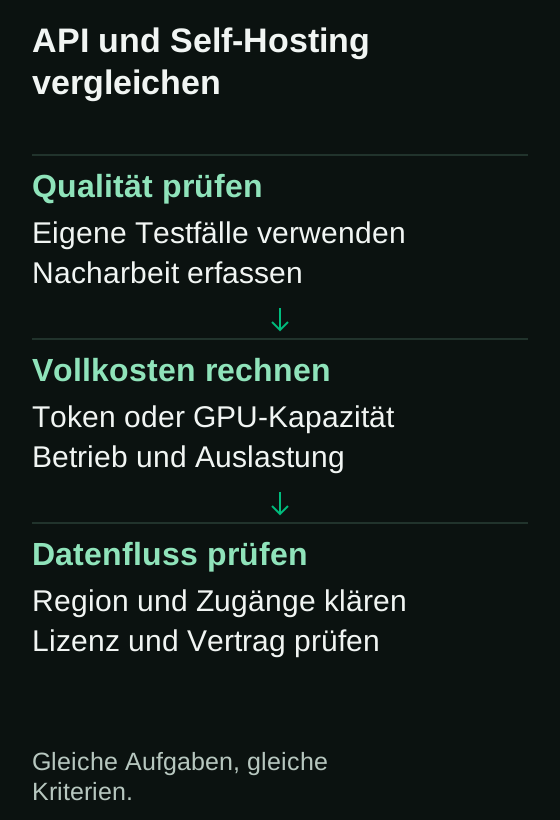
Ob ein offenes Modell für einen Betrieb genügt, entscheidet der konkrete Anwendungsfall. Erstellen Sie repräsentative Testfälle mit schwierigen Eingaben, vertraulichen Datenklassen und klaren Qualitätskriterien. Vergleichen Sie mindestens eine API und ein tatsächlich herunterladbares Modell. Halten Sie Modellversion, Lizenz, Quantisierung und verwendete Hardware fest.
Eine Rangliste kann Kandidaten liefern, ersetzt aber keinen eigenen Test. Ein API-only-Modell ist auch bei einem Anbieter offener Modelle nicht automatisch selbst betreibbar. Elo-Werte beschreiben relative Bewertungen im jeweiligen Vergleich; ein Abstand von 21 Punkten lässt sich nicht als „1,4 Prozent Qualitätsrückstand“ interpretieren. Prüfen Sie die Eignung anhand derselben Aufgaben und Freigabekriterien.
Messen Sie neben fachlicher Richtigkeit auch Nacharbeit, Antwortzeit und Fehlverhalten. Ein Modell, das viele manuelle Korrekturen benötigt, kann trotz günstiger Tokenpreise teuer sein. Ein größeres Modell kann dagegen für einen eng begrenzten Prozess unnötige Ressourcen binden. Die Auswahl braucht messbare Kriterien statt einer pauschalen Behauptung über Parität.
Vergleichen Sie Kosten für denselben erfolgreichen Vorgang. Bei APIs zählen Eingabe, Ausgabe, Caching, Werkzeugaufrufe und Wiederholungen. Bei Self-Hosting zählen Kapazitätskosten, Auslastung und Betrieb. Ein Verhältnis zwischen zwei API-Listenpreisen ist kein Nachweis der Wirtschaftlichkeit eigener GPU-Infrastruktur. Dokumentieren Sie Preise mit Datum und rechnen Sie mit der gemessenen Tokenmenge.
Auch eine gemietete API kann regionale Verarbeitung anbieten. Umgekehrt garantiert ein DACH-Server nicht, dass Telemetrie, Support oder angebundene Werkzeuge innerhalb derselben Grenze bleiben. Prüfen Sie den vollständigen Datenfluss und den Vertrag. Selbstbetrieb erweitert die Gestaltungsmöglichkeiten, übernimmt aber auch die Verantwortung für deren Umsetzung.
Mieten, kaufen oder selbst betreiben: Ein Entscheidungsraster für KMU
Drei Betriebsformen lassen sich vergleichen. Keine davon garantiert allein niedrige Kosten, Datenschutz oder einen einfachen Wechsel. Entscheidend sind konkrete Anbieterbedingungen, benötigte Qualität, Sensitivität, Volumen und Auslastung.
1. Geschlossene API mieten. Wenig eigener Infrastrukturbetrieb, verbrauchsabhängige Kosten und Abhängigkeit vom Modellangebot. Regionale Verarbeitung kann verfügbar sein. Geeignet, wenn Qualität, Vertrag und Datenfluss passen.
2. Offene Gewichte über eine API nutzen. Der Anbieter übernimmt das Serving. Region, Preise und Verarbeitung hängen vom gewählten Dienst ab. Ein eigener Wechselpfad setzt voraus, dass passende Gewichte und eine geeignete Lizenz tatsächlich verfügbar sind.
3. Offene Gewichte selbst betreiben. Hardware, Lizenz, Kapazität, Sicherheit und Wartung liegen im eigenen Verantwortungsbereich oder bei einem beauftragten Betreiber. Das kann bei geeigneter Auslastung sinnvoll sein; geringe oder stark schwankende Nutzung kann eine API wirtschaftlicher machen.
| Kriterium | Geschlossene API | Offene API | Selbst betrieben (DACH) |
|---|---|---|---|
| Kosten je Vorgang | Modell- und tarifabhängig | Modell- und tarifabhängig | Kapazität, Auslastung und Betrieb |
| Datenverarbeitung | Vertrag und Region prüfen | Vertrag und Region prüfen | Vollständigen Datenfluss prüfen |
| Kostenplanung | Volumen und Budgetgrenzen | Volumen und Budgetgrenzen | Kapazität, Wartung und Reserven |
| Wechselpfad | Eigene Daten, Prompts und Tests | Gewichte, Lizenz und eigene Tests | Gewichte, Lizenz, Hardware und Tests |
| Betrieblicher Aufwand | minimal | minimal | erheblich (GPU, K8s, Ops) |
| Beste für | Frontier, geringes Volumen | Experiment, niedriges Volumen | sensibel, hochvolumig, wiederkehrend |
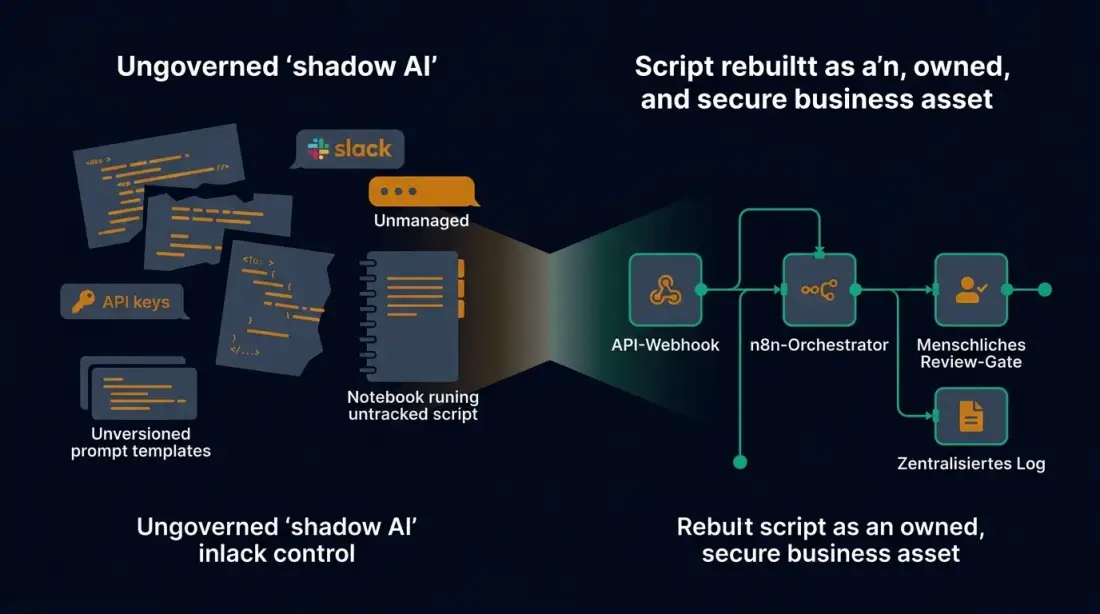
Was Self-Hosting tatsächlich verlangt, ist nicht herunterladbares Diffusionswissen, sondern eine Betriebsschicht. Offene Gewichte müssen serviert werden: ein Inference-Layer, GPU-Kapazität dimensioniert auf die Spitzenlast, Kubernetes als portable Laufzeitumgebung, eine Orchestrierung – typischerweise n8n – die Workflow, menschliche Freigaben und Logging verbindet, sowie eine Resident- und Kostenkontrolle. Wichtig sind auch die realistischen Grenzen: Patching, Modell-Updates, GPU-Ökonomie und die Frage, wann Mieten schlauer ist – bei niedrigem oder unvorhersehbarem Volumen oder wenn die absolute Frontier gebraucht wird. Ein KMU muss nicht eine ganze KI-Plattform betreiben; es kann einen einzigen Workload auf die eigene Schicht heben.
Die These lautet daher nicht „offene Gewichte sind umsonst". Sie lautet: Offene Gewichte machen Self-Hosting für die richtigen Workloads wirtschaftlich rational evaluierbar – und erst Self-Hosting wandelt ein günstiges Modell in eine souveräne, geprüfte, eigene Fähigkeit um.
Ein realistischer KMU-Fall: Ein Workload auf die eigene Schicht
Ein illustrativer DACH-Fall zeigt, wie ein einzelner Workload verschoben wird. Eine inhabergeführte DACH-Beratung mit rund 35 Mitarbeitenden, ohne dediziertes KI- oder Plattformteam, betreut wiederkehrende Kundenprojekte. Der relevante Workload: automatisierte Erstellung kundenfertiger Zusammenfassungen aus internen Recherche-Notizen – sensibel, hochvolumig und wiederkehrend, also ein idealer Kandidat für Self-Hosting.
Beteiligte Rollen: Lena, Head of Operations und Entscheidungseigentümerin (Budget und Datenverarbeitungsvereinbarung); Marco, IT-Leitung nebenberuflich ohne ML-Hintergrund; Daniela, Senior-Beraterin und fachliche Qualitätsfreigabe.
Für ein konsistentes Rechenbeispiel nehmen wir 120 Notizen pro Woche und genau eine Zusammenfassung pro Notiz an. Bei vier Wochen sind das 480 Zusammenfassungen pro Monat. Eingabe- und Ausgabetoken werden im Pilot separat gemessen. Ohne Modell, Tokenverteilung und Tarif lässt sich daraus keine belastbare Monatsrechnung ableiten.
Die Entscheidungspunkte folgen dem Plan/Unfold/Resonate-Rhythmus. In der Plan-Phase wird der Workload bewertet: hohe Sensitivität (Kundendaten) kombiniert mit hohem Volumen macht ihn zum Top-Kandidaten für die Verlagerung. Niedrigvolumige, ad-hoc Aufgaben bleiben bewusst auf einer günstigen API. In der Unfold-Phase wird ein anhand der eigenen Testfälle ausgewähltes, passend lizenziertes Modell mit verfügbaren Gewichten auf DACH-Kubernetes mit GPU-Kapazität dimensioniert auf die Spitze deployt und über n8n orchestriert. Menschliche Freigaben sind eingebaut: Jede Zusammenfassung läuft über Daniela zur Freigabe, bevor sie einen Kunden erreicht; eine Zweipersonenregel gilt für Modell- und Prompt-Änderungen, jede Änderung wird mit Begründung und Prüfendem geloggt; eine harte monatliche Kostenobergrenze mit Alerting schützt das Band, und ein Resident-Check läuft bei jeder Ausführung.
Der Ausstiegsschlüssel ist kein Marketingwort, sondern ein Artefakt: Eigene Prompts und Konfigurationen bleiben zugänglich; Modellgewichte werden unter ihrer jeweiligen Lizenz genutzt. Die Firma kann auf anderer Hardware neu hosten oder das Modell tauschen, ohne Anbieter-Abhängigkeit.
Das Ergebnis ist – ausdrücklich illustrativ, nicht gemessen – eine Verschiebung von einer volatilen Token-Rechnung in ein geplantes, fixes Infrastruktur-Band. Kundendaten bleiben im DACH-Raum. Jede erzeugte Zusammenfassung hat eine Eigentümerin und einen Audit-Trail. Planfold gibt dafür keinen konkreten Euro-Betrag als Ersparnis an – denn der echte Gewinn ist Kostenkontrolle, Datenhoheit und ein belastbarer Exit, keine garantierte Reduktion.
Die Planfold-Perspektive: KI als eigene, geprüfte Fähigkeit
Planfold rahmt KI-Adoption als Infrastruktur plus Governance, nicht als Modellauswahl. Die Argumentationslinie folgt einem klaren Betriebsschema: Plan heißt, KI-Ausgaben, Datenflüsse, Sensitivitätsklassen und Resident-Anforderungen zu auditieren und Workloads nach Volumen und Risiko zu bewerten. Unfold heißt, frontier-klasse offene Gewichte auf souveräner oder selbst betriebener Infrastruktur – Kubernetes, GPU-Kapazität wo der Workload es rechtfertigt – bereitzustellen, orchestriert über n8n mit Mensch-in-der-Schleife-Freigaben und geloggten Entscheidungen. Resonate heißt, mit planbaren Kosten, Datenresident-Nachweisen, einem Audit-Trail und einem Ausstiegsschlüssel zu operieren.
Die Behauptung ist betrieblich und nüchtern, nicht magisch: Offene Gewichte machen Ownership wirtschaftlich rational zu evaluieren – sie garantieren keine Ersparnis und brauchen weiterhin eine Betriebsschicht, die den meisten KMU fehlt. Planfold liefert diese Schicht (souveränes Hosting, Kubernetes-Betrieb, n8n-Orchestrierung, dokumentierte Freigabestandards); Planfold verkauft kein Modell, zertifiziert keine Compliance und gibt keine Rechtsberatung. Regulatorische Themen wie der EU AI Act werden als risikobasierter Rahmen mit Erwartungen an Dokumentation, Logging und menschliche Aufsicht behandelt – als „Architektur für Compliance-Bereitschaft", nicht als Rechts- oder Zertifizierungsversprechen.
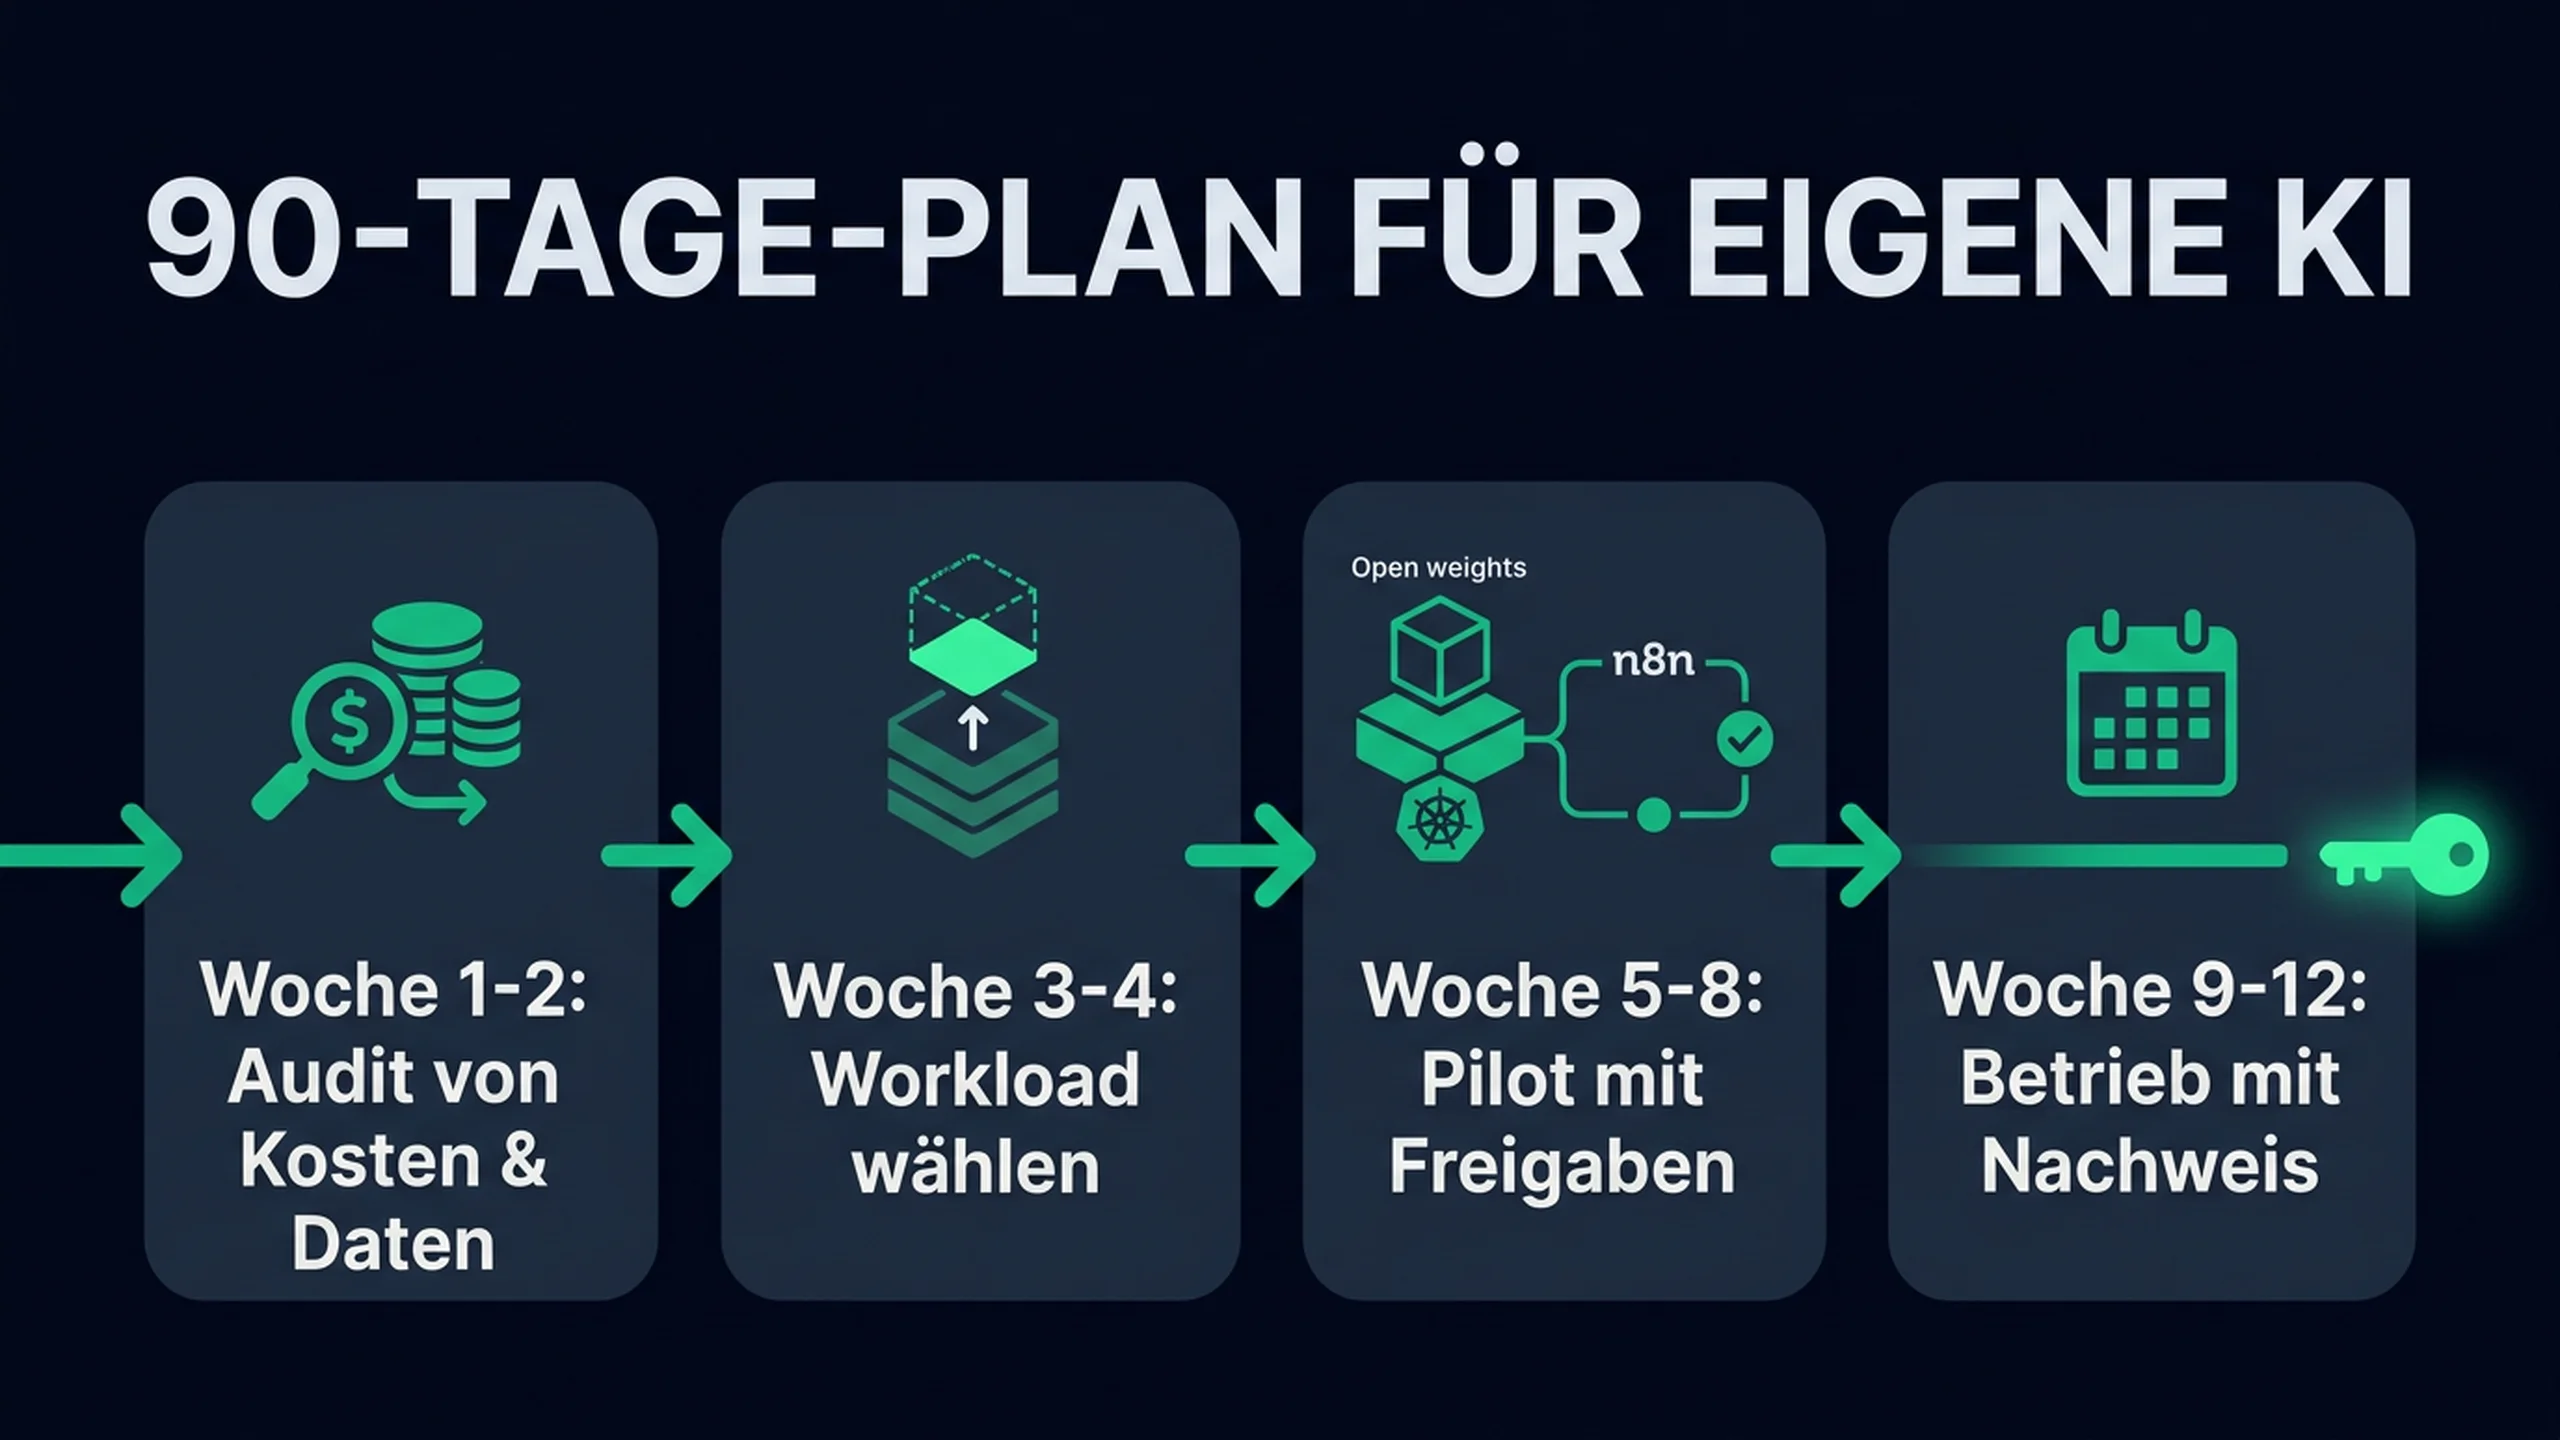
Ein begrenzter 90-Tage-Startplan macht das konkret. Woche 1 bis 2: Audit. KI-Ausgaben und Datenflüsse kartieren, Workloads nach Sensitivität und Volumen bewerten, Datenklassen und Review-Rollen benennen. Woche 3 bis 4: Workload wählen. Einen sensiblen, hochvolumigen, wiederkehrenden Workload als ersten Self-Hosting-Kandidaten festlegen – nicht die ganze KI-Strategie auf einmal. Woche 5 bis 8: Pilot. Ein offenes Gewichtsmodell auf DACH-Kubernetes deployen, über n8n orchestrieren, mit harten Kostenobergrenzen, Resident-Check und menschlicher Freigabe. Woche 9 bis 12: Operieren. Kosten-, Resident- und Exit-Nachweise im laufenden Betrieb aufbauen und prüfen, ob der Pfad auf einen zweiten Workload skaliert.
Der nächste Schritt ist ein begrenzter Vergleich: ein Workflow, dieselben Testfälle und eine vollständige Kostenrechnung. Erst wenn Qualität, Datenfluss und Betriebsaufwand zusammenpassen, lohnt sich eine Verlagerung. Planfold kann diesen Vergleich und den vereinbarten technischen Betrieb begleiten.
Planen. Entfalten. Souverän bleiben.
Verwandte Artikel
Wenn ein fremder Staat Ihren KI-Zugang kontrolliert: Souveräne KI-Beschaffung als Risikoentscheidung für KMU
Das KI-Bereitschafts-Audit: Datenarchitektur für agentische Automatisierung vorbereiten