Runbook-gesteuerte Abläufe für KMU: Wissen dokumentieren statt behalten
Wenn kritische Betriebsabläufe nur im Kopf einer Person leben, ist jeder Vorfall ein Glücksspiel. So bauen KMU mit Runbooks operative Klarheit — bevor sie automatisieren.
Inhalt
Wenn kritische Betriebsabläufe nur im Kopf einer Person leben, ist jeder Vorfall ein Glücksspiel. So bauen KMU mit Runbooks operative Klarheit — bevor sie automatisieren.
Artikel teilen
Der Sonntagabend, an dem niemand wusste, was zu tun war
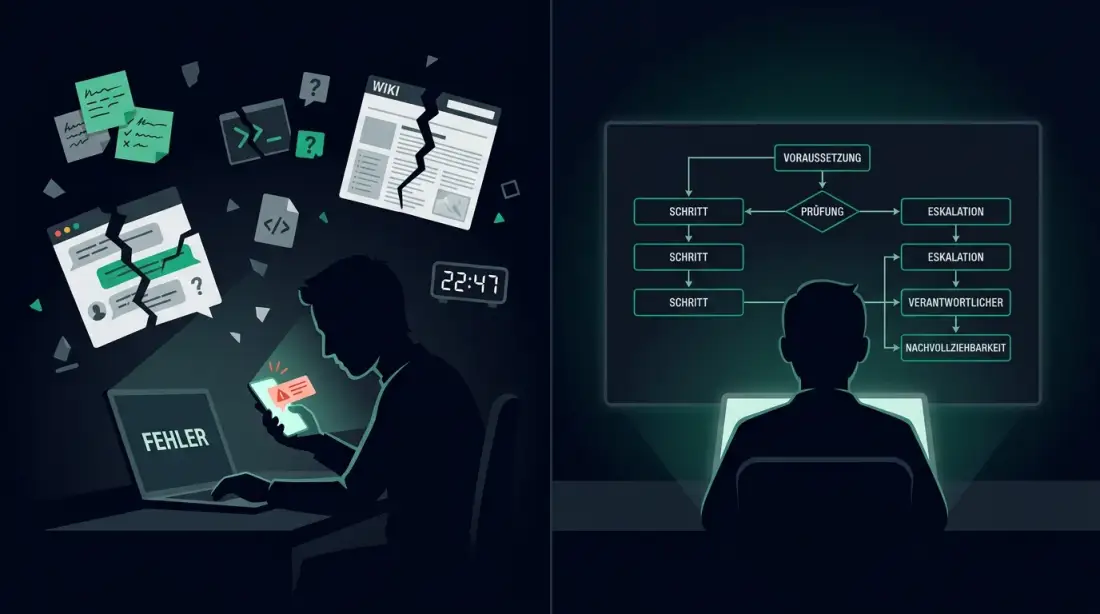
Es ist 22:47 Uhr an einem Sonntag im November. Sarah, Operations-Mitarbeiterin bei einem Mediendienstleister mit 22 Mitarbeitenden, erhält eine PagerDuty-Benachrichtigung: Das nächtliche Backup für 34 Kundenwebsites ist fehlgeschlagen. Die Backup-Software meldet einen Konsistenzfehler beim Kunden mit eigenem CDN-Setup. Sarah kennt die Routineaufgaben — sie führt sie täglich aus. Aber diesen spezifischen Fehler hat sie noch nie gesehen.
Sie öffnet den internen Wiki-Ordner. Ein 40-seitiges Handbuch zur Backup-Infrastruktur liegt dort, das Klaus, der Technische Leiter, vor zwei Jahren angelegt hat. Es beschreibt die Architektur auf abstrakter Ebene. Nichts darin hilft Sarah bei der Entscheidung, ob sie das Backup für den CDN-Kunden isoliert neu starten darf oder ob das die bestehenden Wiederherstellungspunkte der anderen 33 Kunden invalidiert.
Sarah ruft Klaus an. Er ist im Kino und nicht erreichbar. Sie versucht es mit Jonas, dem Praktikanten, der vor drei Wochen angefangen hat. Jonas hat keine Ahnung. Um 1:15 Uhr findet Sarah schließlich einen Slack-Thread aus dem März, in dem Klaus eine ähnliche Situation besprochen hat. Die Nachrichtenkette ist 47 Einträge lang, durchsetzt mit halbgar ausgedrückten Ausnahmeregeln und einem Link zu einem Shell-Skript, das auf einem Server liegt, den Sarah nicht kannte.
Drei Stunden später läuft das Backup wieder. Die Kundendaten waren für vier Stunden ungeschützt. Niemand hat geschlafen. Niemand hat dokumentiert, welche Schritte tatsächlich zum Erfolg geführt haben.
Google berichtet in der Einführung des SRE-Buchs von einer ungefähr dreifachen Verbesserung der Reparaturzeit durch vorbereitete Playbooks gegenüber improvisiertem Vorgehen. Das ist eine Beobachtung aus Googles Betrieb, kein allgemeiner KMU-Benchmark. Ob ein Runbook bei Ihnen hilft, lässt sich durch eine Übung mit einer nicht eingeweihten Person und einem dokumentierten Vorher-Nachher-Vergleich prüfen.
Wenn Abläufe im Kopf statt im System leben
Der Fehler beginnt nicht mit der Incident-Nacht. Er beginnt am Montagmorgen, wenn Klaus seinen Kaffee trinkt und die Backup-Überwachung im Blick behält — ohne je etwas aufzuschreiben. Das Wissen um Ausnahmeregeln, Eskalationsgrenzen und manuelle Korrekturen wächst organisch in seinen Erfahrungen, nicht in einem Dokument, das ein anderer lesen könnte.
Die drei Formen operativen Gedächtnisses
In den meisten KMU mit 10–100 Mitarbeitern existieren operative Abläufe in drei unsicheren Formen:
-
Persönliches Wissen: Klaus weiß, welcher Kunde ein eigenes CDN hat, welche Backup-Wiederherstellung für diesen Fall gilt und unter welchen Bedingungen ein manueller Eingriff erlaubt ist. Dieses Wissen verlässt das Unternehmen, wenn Klaus krank wird, Urlaub macht oder das Unternehmen verlässt.
-
Chat-Archäologie: Slack-Threads, E-Mail-Ketten und private Notizen enthalten Fragmente der Wahrheit. Sie sind aber nicht durchsuchbar, nicht versioniert und nicht für Menschen geschrieben, die die ursprüngliche Diskussion nicht mitverfolgt haben. Ein Slack-Thread aus dem März ist für Sarah im November keine Dokumentation — er ist ein Grabungsprojekt.
-
Statische Handbücher: Das 40-seitige Wiki-Handbuch ist theoretisch korrekt, praktisch nutzlos. Es beschreibt die ideale Welt, nicht die reale. Es enthält keine Entscheidungsbäume, keine Eskalationspfade und keine Verifikations-Checks. Es ist ein Monument, kein Werkzeug.
Warum Chatverläufe keine Dokumentation sind
Ein Chat-Thread dokumentiert, was einmal gesagt wurde. Er dokumentiert nicht, was gültig ist. Er dokumentiert keine Voraussetzungen, keine Fehlschläge, keine alternativen Pfade. Wenn Sarah im November auf einen Thread aus dem März stößt, kann sie nicht wissen, ob die darin enthaltene Lösung noch gilt, ob sie für ihren spezifischen Fall anwendbar ist oder ob Klaus inzwischen eine bessere Vorgehensweise etabliert hat, die nirgendwo erwähnt ist.
Die PagerDuty Incident Response Documentation, ein offen zugängliches Referenzwerk für Incident Management, formuliert das so: Runbooks müssen aktionsorientiert, zugänglich, akkurat, autoritativ und anpassungsfähig sein — die sogenannten "Five A's". Ein Slack-Thread erfüllt keine davon. Er ist nicht aktionsorientiert (er ist diskursiv), nicht akkurat (er enthält Spekulation und Umwege), nicht autoritativ (niemand hat ihn als gültige Vorgehensweise bestätigt) und nicht anpassungsfähig (er ist eingefroren in der Zeit).
Der versteckte Preis von Wissen, das nicht geteilt wird
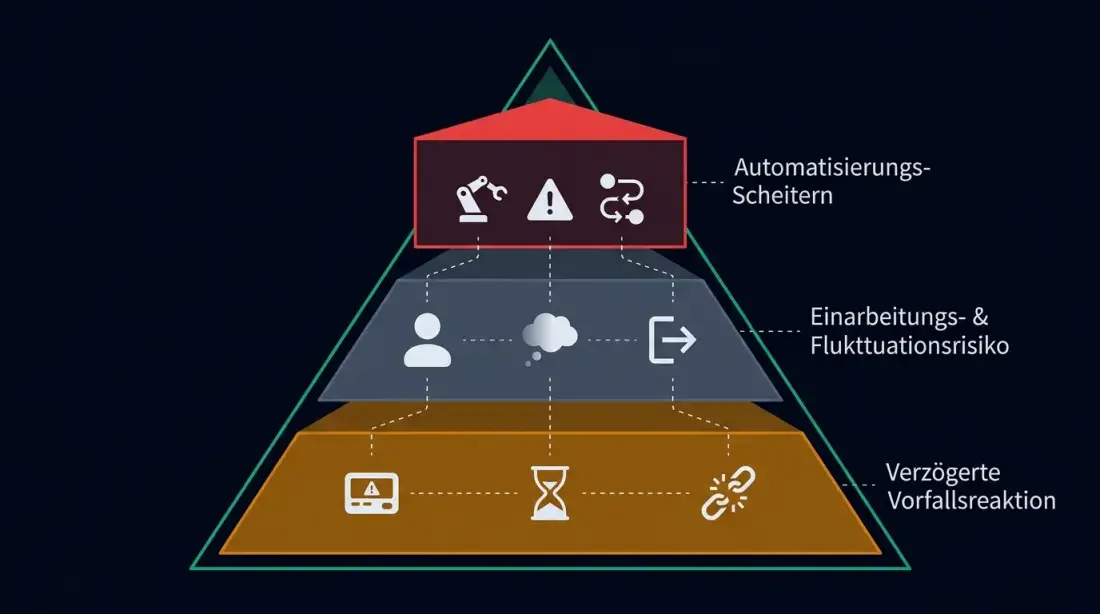
Die Kosten unsichtbarer Abläufe lassen sich nicht in einer einzigen Rechnung zusammenfassen. Sie verteilen sich auf drei operative Bereiche, die jeder für sich das Wachstum und die Stabilität eines KMU gefährden.
Reaktionszeit bei Vorfällen
Atlassian, ein führender Anbieter von Collaboration- und Incident-Management-Tools, betont in seiner Dokumentation zu Incident Management KPIs, dass Time to Detect (TTD) und Time to Recovery (TTR) die entscheidenden Indikatoren für die Reife eines Incident-Response-Prozesses sind. Ohne Messung des Beginns, der Erkennung und des Endes eines Vorfalls lernen Teams wenig und wiederholen die gleichen blinden Flecken.
Für diesen Mediendienstleister bedeutet das: Jeder Vorfall, bei dem der Fix nur Klaus bekannt ist, kostet das Team geschätzt vier bis fünf Stunden an Kontextsuche und Eskalation (illustratives Szenario). Bei zwei bis drei solchen Vorfällen pro Quartal summiert sich das auf 32–60 Stunden pro Jahr — Zeit, die nicht für Verbesserungen, sondern für Wiederholungen aufgewendet wird.
Einarbeitungsdauer und Fluktuationsrisiko
Jonas, der Praktikant, soll Kunden-Onboarding übernehmen. Er hat aber keine schriftliche Anleitung. Jeder Onboarding-Schritt muss ihm von Klaus oder Sarah mündlich erklärt werden. Nach drei Monaten versteht Jonas die Routine, nicht aber die Ausnahmen. Wenn er das Unternehmen verlässt, verliert der Mediendienstleister nicht nur einen Mitarbeiter — das Team verliert den halbfertigen Prozess, den niemand vollständig dokumentiert hat.
Die Abhängigkeit von Schlüsselpersonen ist kein rein personelles Thema. Sie ist ein strukturelles Geschäftskontinuitätsrisiko. Laut dem NIST Special Publication 800-34 Rev. 1, dem US-Standard für IT-Notfallplanung, ist ein dokumentierter Plan nur so gut wie seine jüngste Validierung. Tests, Übungen und regelmäßige Wartung von Wiederherstellungsplänen sind zwingend erforderlich. Ein Plan, der nicht geprüft wird, ist eine Illusion — und ein Mitarbeiter, der nicht ersetzbar ist, ist ein Single Point of Failure.
Automatisierung, die scheitert, bevor sie beginnt
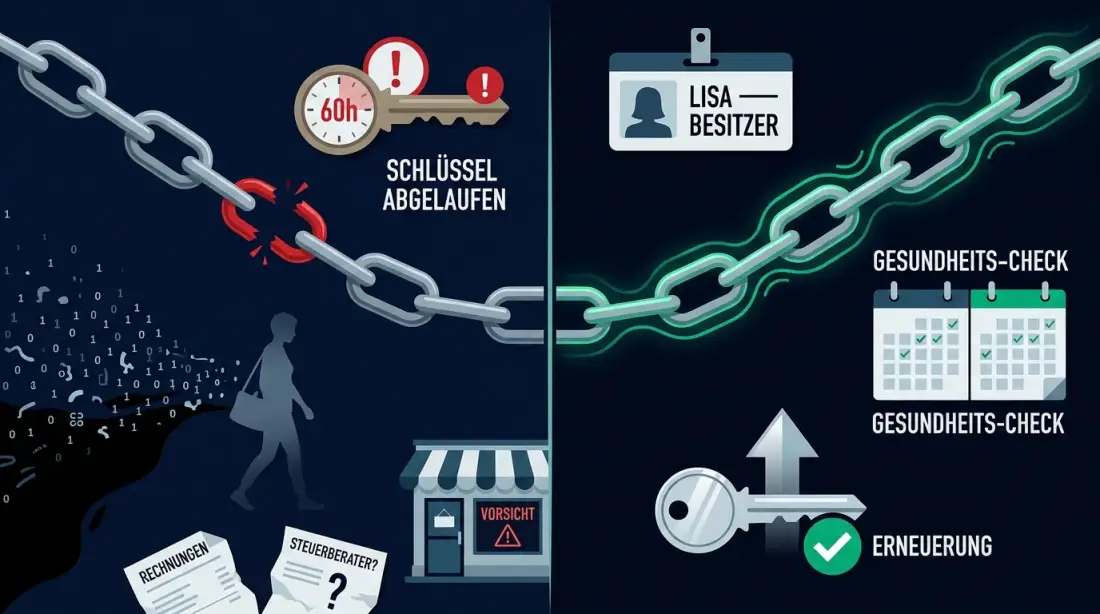
Die Geschäftsleitung beschließt, das wiederkehrende SSL-Zertifikats-Renewal zu automatisieren. Der Entwickler fragt: "Welche Zertifikate laufen wann ab? Was passiert, wenn der Automatismus fehlschlägt? Wer darf manuell eingreifen, und unter welchen Bedingungen?" Niemand kann diese Fragen präzise beantworten, weil der Prozess bisher immer ad-hoc angepasst wurde. Das Automatisierungsprojekt stockt — oder schlimmer: Es kodiert einen missverstandenen Prozess, der in Produktion fehlschlägt.
Das ist der Automatisierungs-Trap: Automatisierung setzt voraus, dass ein Prozess verstanden ist. Ein Prozess, der nur in Köpfen existiert, ist nicht verstanden — er ist nur gewohnt. Und Gewohnheit lässt sich nicht kodieren.
Was ein Runbook wirklich ist — und was nicht
Ein Runbook ist kein Handbuch. Ein Handbuch erklärt, wie ein System funktioniert. Ein Runbook sagt, was zu tun ist, wenn etwas nicht funktioniert — und wer es tut, wie es überprüft wird und wann es eskaliert wird.
Kein Handbuch, sondern eine Entscheidungskette
Die Google SRE Workbook definiert Playbooks (das Google-Äquivalent zu Runbooks) als schriftliche, schrittweise Anweisungen für den Umgang mit Vorfällen. Der entscheidende Unterschied zu herkömmlicher Dokumentation liegt in der Struktur: Ein Runbook ist ein Entscheidungsbaum, kein Prosa-Essay.
Ein gutes Runbook für den Backup-Fall dieses Mediendienstleisters sähe nicht so aus:
"Bei Backup-Problemen prüfen Sie die Logs und starten Sie gegebenenfalls neu."
Es sähe so aus:
1. Voraussetzung prüfen: Sind alle 34 Kundenwebsites im Backup-Set erfasst? → Ja: Weiter zu Schritt 2. → Nein: Liste der fehlenden Kunden notieren und zu Schritt 5 springen.
2. Fehlertyp identifizieren: Handelt es sich um einen CDN-Kunden? → Ja: Spezifischen Wiederherstellungspfad für CDN-Setups verwenden (siehe Anhang B). → Nein: Standard-Wiederherstellungspfad verwenden.
3. Verifikation nach Ausführung: Backup-Protokoll auf Konsistenz prüfen. Wiederherstellungspunkte der letzten 7 Tage verifizieren.
4. Eskalation: Wenn die Wiederherstellung nicht innerhalb von 30 Minuten gelingt → Eskalation an Klaus (Technischer Leiter) via PagerDuty, Priorität hoch.
Voraussetzungen, Schritte, Prüfpunkte, Eskalationspfad
Jeder Runbook-Schritt enthält vier Elemente:
- Voraussetzung: Was muss wahr sein, bevor dieser Schritt ausgeführt wird? (z. B. "Admin-Zugang zum Backup-Portal ist verfügbar.")
- Schritt: Die konkrete Handlung. (z. B. "Isolieren Sie den CDN-Kunden-Job und starten Sie ihn mit dem Flag
--force-consistency-checkneu.") - Prüfpunkt (Verifikation): Wie weiß der Ausführende, dass der Schritt erfolgreich war? (z. B. "Das Backup-Protokoll zeigt
Consistency check passedfür alle 34 Jobs.") - Eskalationspfad: Was passiert, wenn der Schritt fehlschlägt oder die Verifikation negativ ausfällt? (z. B. "Eskalation an Klaus innerhalb von 30 Minuten; bis dahin Kundenbenachrichtigung über verzögertes Backup.")
Diese Struktur verwandelt ein Dokument in ein Werkzeug. Sie macht den Unterschied zwischen einer Person, die improvisiert, und einem Team, das nachvollziehbar handelt.
Der Unterschied zwischen statischem Dokument und lebendem Workflow
Ein statisches Dokument wird geschrieben und vergessen. Ein lebendiger Runbook hat einen Besitzer, ein Überprüfungsdatum und eine Änderungshistorie. PagerDuty betont in seiner Dokumentation ausdrücklich: Runbooks degenerieren ohne Wartung und Besitz. Post-Mortem-Action-Items müssen Runbook-Updates enthalten. Runbooks, die nie auf Basis von Incident-Learnings aktualisiert werden, driften in die Nutzlosigkeit.
Das bedeutet für KMU: Ein Runbook ist nicht einmalig zu erstellen. Es ist ein lebendes Artefakt, das nach jedem signifikanten Vorfall geprüft und angepasst wird. Der Besitzer — nicht der Autor — ist derjenige, der dafür sorgt, dass es aktuell bleibt. Bei diesem Mediendienstleister könnte Sarah der Besitzer des Backup-Runbooks sein, auch wenn Klaus der ursprüngliche Autor war.
Vom Kopf-im-Betrieb zum dokumentierten Ablauf
Das Szenario bei dem Mediendienstleister ist illustrativ: 22 Mitarbeiter, 120 Kundenwebsites, tägliche Backups, wöchentliche Zertifikatsprüfungen, fünf bis zehn Kunden-Onboardings pro Monat, zwei bis drei Vorfälle pro Quartal bei denen der Fix nur Klaus bekannt ist. Die Zahlen sind beispielhaft, aber die Struktur ist typisch für den Mittelstand.
Vorher: Ein Vorgang, den nur Maria kennt
Nehmen wir an, Klaus erkrankt plötzlich für zwei Wochen. Ein Kunde mit eigenem CDN meldet einen teilweisen Ausfall. Sarah versucht, die Wiederherstellung auszuführen, wie sie es von Klaus mündlich gelernt hat. Sie übersieht einen Zwischenschritt, der für CDN-Setups notwendig ist. Die Wiederherstellung scheint erfolgreich, aber die CDN-Zwischenspeicherung liefert weiterhin veraltete Inhalte aus. Der Kunde bemerkt den Fehler erst am nächsten Tag. Die Eskalation läuft über drei Hierarchieebenen, weil niemand weiß, wer außerhalb der Geschäftszeiten für diesen Kundentyp zuständig ist.
Die Auswirkungen sind nicht nur technisch. Sie sind vertrauensbasiert. Ein Kunde, der 24 Stunden lang veraltete Inhalte sieht, fragt sich, ob sein Anbieter die Kontrolle über seine eigene Infrastruktur hat.
Nachher: Ein Runbook, das jeder ausführen kann
Nach der Einführung von Runbooks sieht der gleiche Vorfall so aus:
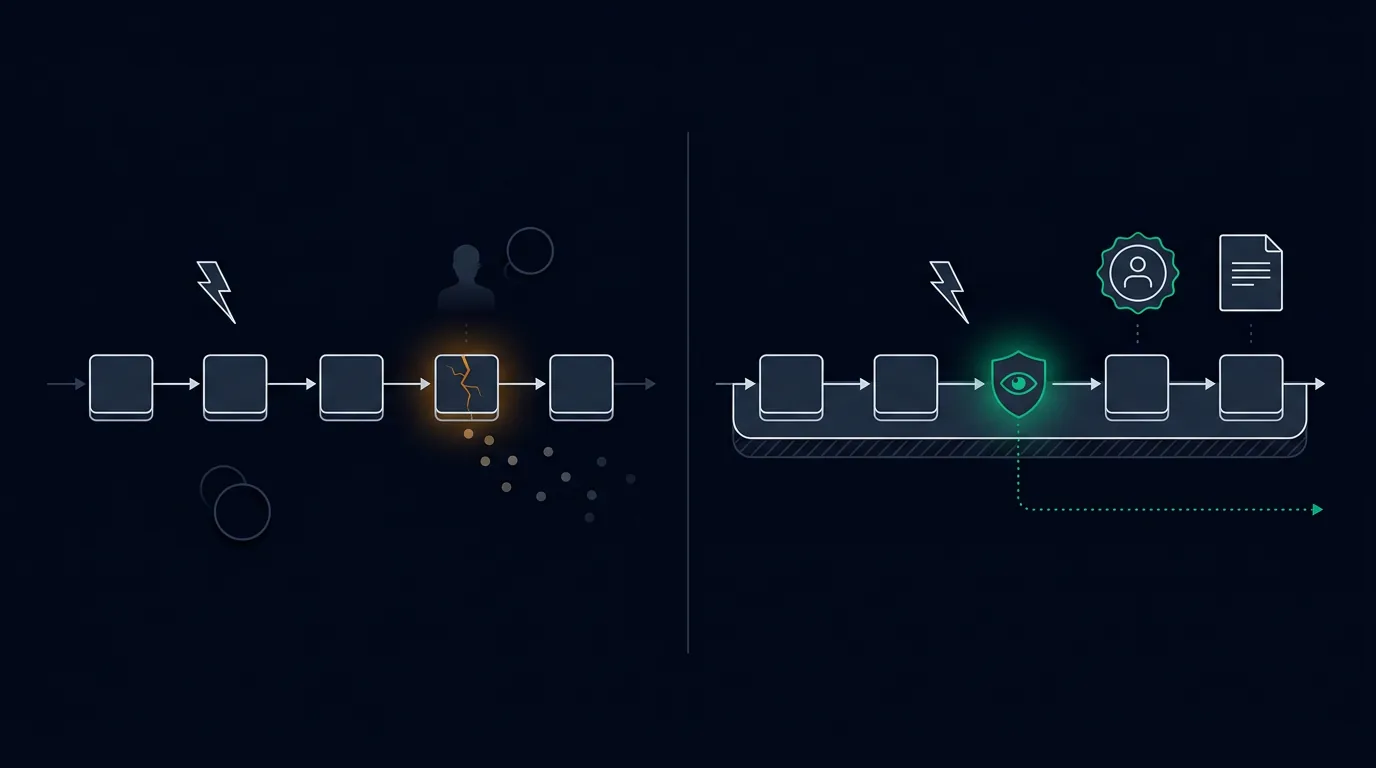
Sarah öffnet das Backup-Runbook. Sie identifiziert in 90 Sekunden, dass der Kunde ein CDN-Setup hat. Der Entscheidungsbaum führt sie zum spezifischen Wiederherstellungspfad. Sie führt die Schritte aus, verifiziert das Ergebnis anhand des definierten Prüfpunkts und dokumentiert die Ausführung im Audit-Trail. Die Gesamtzeit von Alarm bis Verifikation liegt unter 20 Minuten. Der Kunde bemerkt nichts.
Die drei menschlichen Review-Gates, die Planfold für Runbook-gesteuerte Abläufe empfiehlt, sind dabei eingehalten:
- Verifikation auf Schrittebene: Jeder Runbook-Schritt enthält einen definierten Prüfpunkt, den der Ausführende bestätigen muss, bevor er fortfährt.
- Ausnahmefreigabe: Abweichungen vom Standardpfad erfordern eine explizite Freigabe durch den technischen Leiter oder einen autorisierten Stellvertreter.
- Audit-Trail: Jede Incident-Ausführung schreibt einen zeitgestempelten Eintrag mit Ausführendem, Schritten, Ergebnissen und Eskalationsentscheidungen.
Wie Planfold Betriebswissen in operative Klarheit übersetzt
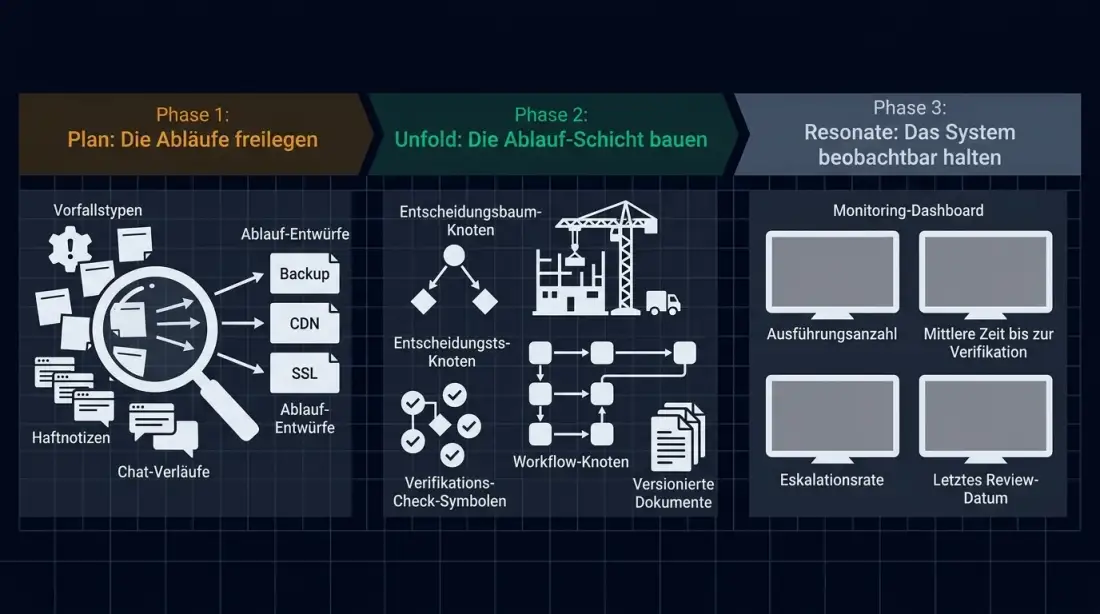
Planfold behandelt runbook-gesteuerte Abläufe als Grundlage operativer Reife. Die Methodik folgt drei Phasen, die technisch definiert sind — nicht als Marketing-Labels, sondern als ausführbare Arbeitsschritte.
Plan: Die Abläufe freilegen
In der Plan-Phase werden die bestehenden, im Kopf verankerten Abläufe sichtbar gemacht. Das bedeutet nicht, ein 200-seitiges Handbuch zu schreiben. Es bedeutet, mit den kostspieligsten Vorfällen zu beginnen und für jeden davon zu dokumentieren: Was ist der Auslöser? Welche Schritte führen zur Lösung? Welche Ausnahmen gibt es? Wer entscheidet, wenn der Standardpfad nicht greift?
Für diesen Mediendienstleister würde das bedeuten: Die drei häufigsten Incident-Typen (Backup-Fehler, CDN-Ausfall, SSL-Zertifikatsprobleme) werden in jeweils einem Runbook mit Entscheidungsbaum, Verifikations-Checks und Eskalationspfaden abgebildet. Nicht mehr. Nicht weniger.
Unfold: Die Runbook-Schicht bauen
In der Unfold-Phase werden die dokumentierten Abläufe in betreibbare Systeme überführt. Das kann bedeuten, die Runbooks in einem zentralen, durchsuchbaren Repository zu versionieren — etwa in Git, wo jede Änderung nachvollziehbar ist. Es kann bedeuten, Verifikations-Checks durch Monitoring-Systeme zu unterstützen, die automatisch alarmieren, wenn ein Prüfpunkt nicht erfüllt wird. Und es kann bedeuten, Teilschritte durch n8n-basierte Workflows zu automatisieren, wobei der Runbook weiterhin die Entscheidungskette und die menschlichen Freigaben definiert.
Der Unterschied ist entscheidend: Der Runbook bleibt das autoritative Dokument. Die Automatisierung ist ein Werkzeug, das ihn ausführt — nicht ein Ersatz, der ihn überflüssig macht.
Resonate: Das System beobachtbar halten
In der Resonate-Phase wird die operative Klarheit gemessen und aufrechterhalten. Das bedeutet: Wie oft wurde ein Runbook im letzten Quartal ausgeführt? Wie lange dauerte die Durchführung? Welche Schritte führten regelmäßig zu Eskalationen? Welche Runbooks wurden seit der letzten Überprüfung nicht mehr aktualisiert?
Diese Metriken sind nicht akademisch. Sie zeigen, welche Runbooks lebendig sind und welche veralten. Ein Runbook, das seit zwölf Monaten nicht mehr geändert wurde, ist entweder perfekt — oder vergessen. Die Daten unterscheiden die beiden Fälle.
Ein praktischer Start — ein Vorgang, den jeder ausführen kann
Runbooks klingen nach einem großen Projekt. Sie sind es nicht. Sie sind eine kleine Disziplin, die sich akkumuliert. Der richtige Einstieg ist entscheidend — und er ist kleiner, als viele befürchten.
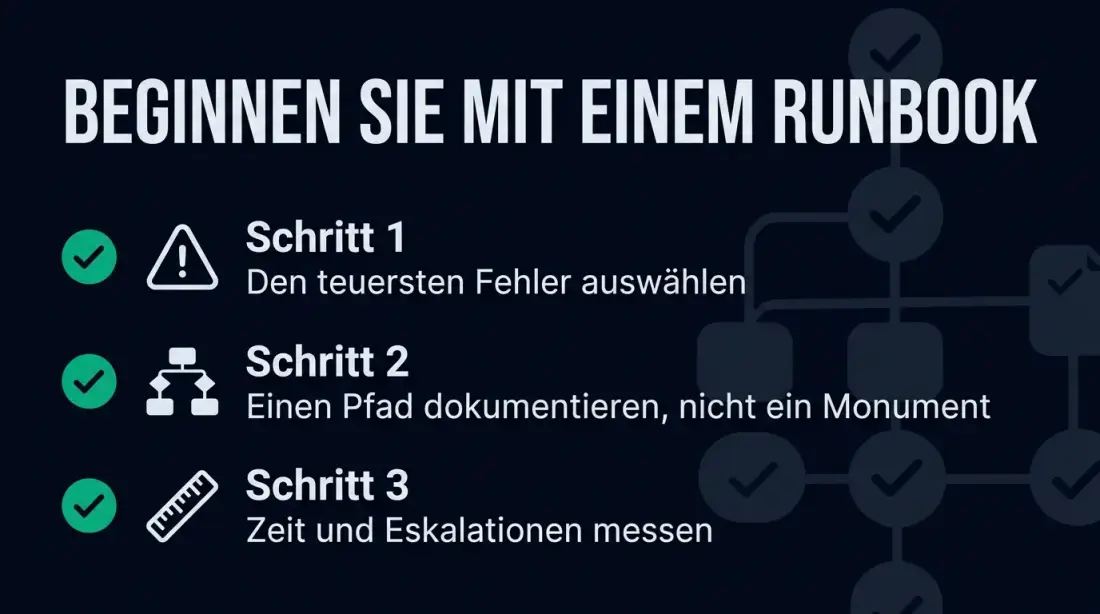
Den teuersten Fehler auswählen
Beginnen Sie nicht mit dem größten System. Beginnen Sie mit dem teuersten Fehler. Das ist der Vorfall, der in den letzten zwölf Monaten die meisten Nachtstunden, die meisten Eskalationen oder den größten Kundenvertrauensverlust verursacht hat. Dokumentieren Sie diesen einen Pfad — nicht alle Pfade, nicht das gesamte System, nur diesen einen.
Für diesen Mediendienstleister wäre das der Backup-Fehler mit CDN-Kunden. Ein Runbook mit acht bis zwölf Schritten, drei Entscheidungsknoten, zwei Verifikations-Checks und einem definierten Eskalationspfad. Das ist in einem Nachmittag geschrieben und in einer Woche getestet.
Einen Pfad dokumentieren, nicht ein Monument
Der größte Fehler bei der Runbook-Einführung ist der Versuch, alles auf einmal zu dokumentieren. Ein 40-seitiges Handbuch, das niemand liest, ist schlimmer als kein Handbuch — weil es die Illusion von Dokumentation erzeugt, während die Realität chaotisch bleibt.
Ein guter Runbook ist kurz genug, um in einem Incident gelesen zu werden, während der Pager piept. Er enthält keine Architekturbeschreibungen, keine historischen Hintergründe, keine allgemeinen Ratschläge. Er enthält: Voraussetzung, Schritt, Prüfpunkt, Eskalation. Punkt.
Messen, was sich ändert
Nach Einführung des ersten Runbooks messen Sie zwei Zahlen: Die durchschnittliche Zeit von Alarm bis Verifikation für diesen Vorfallstyp — und die Anzahl der Eskalationen, bei denen der Experte eingreifen musste. Wenn der Runbook funktioniert, sinkt die erste Zahl und die zweite ebenfalls. Wenn beide Zahlen gleich bleiben, ist der Runbook nicht präzise genug oder die Verifikations-Checks sind nicht eindeutig.
NIST SP 800-34 Rev. 1 betont: Ein dokumentierter Plan ist nur so gut wie seine jüngste Validierung. Tests und Übungen sind nicht optional — sie sind die einzige Methode, um zu beweisen, dass ein Runbook im Ernstfall funktioniert. Führen Sie mindestens vierteljährlich einen gezielten Drill mit dem Runbook durch, bei dem eine Person den Vorfall simuliert und eine andere den Runbook ausführt. Die Ergebnisse fließen direkt in die Aktualisierung ein.
Der Übergang von betriebswissenabhängigen Abläufen zu runbook-gesteuerten Prozessen ist kein Technologieprojekt. Er ist eine Betriebsentscheidung. Die Frage ist nicht, ob Ihr Unternehmen groß genug für Runbooks ist. Die Frage ist, ob Ihr Unternehmen klein genug ist, um den Ausfall einer einzelnen Person zu verkraften — ohne dass Kunden es merken.
Planen. Entfalten. Resonanz erzeugen.