Workflow-Automatisierung im Rückblick: Was KMU aus gescheiterten Rollouts lernen
Automatisierungs-Rollouts scheitern im KMU vorhersehbar – Pilot Purgatory, spröde Integrationen, ungesteuerte Schatten-Automatisierung und Over-Automation. Dieser Rückblick benennt die Fehlermuster und einen disziplinierten, eigentümergeführten Rollout.
Inhalt
Automatisierungs-Rollouts scheitern im KMU vorhersehbar – Pilot Purgatory, spröde Integrationen, ungesteuerte Schatten-Automatisierung und Over-Automation. Dieser Rückblick benennt die Fehlermuster und einen disziplinierten, eigentümergeführten Rollout.
Artikel teilen
Die Eröffnungsszene: ein Workflow, der in der Demo funktionierte und in Produktion verstummte
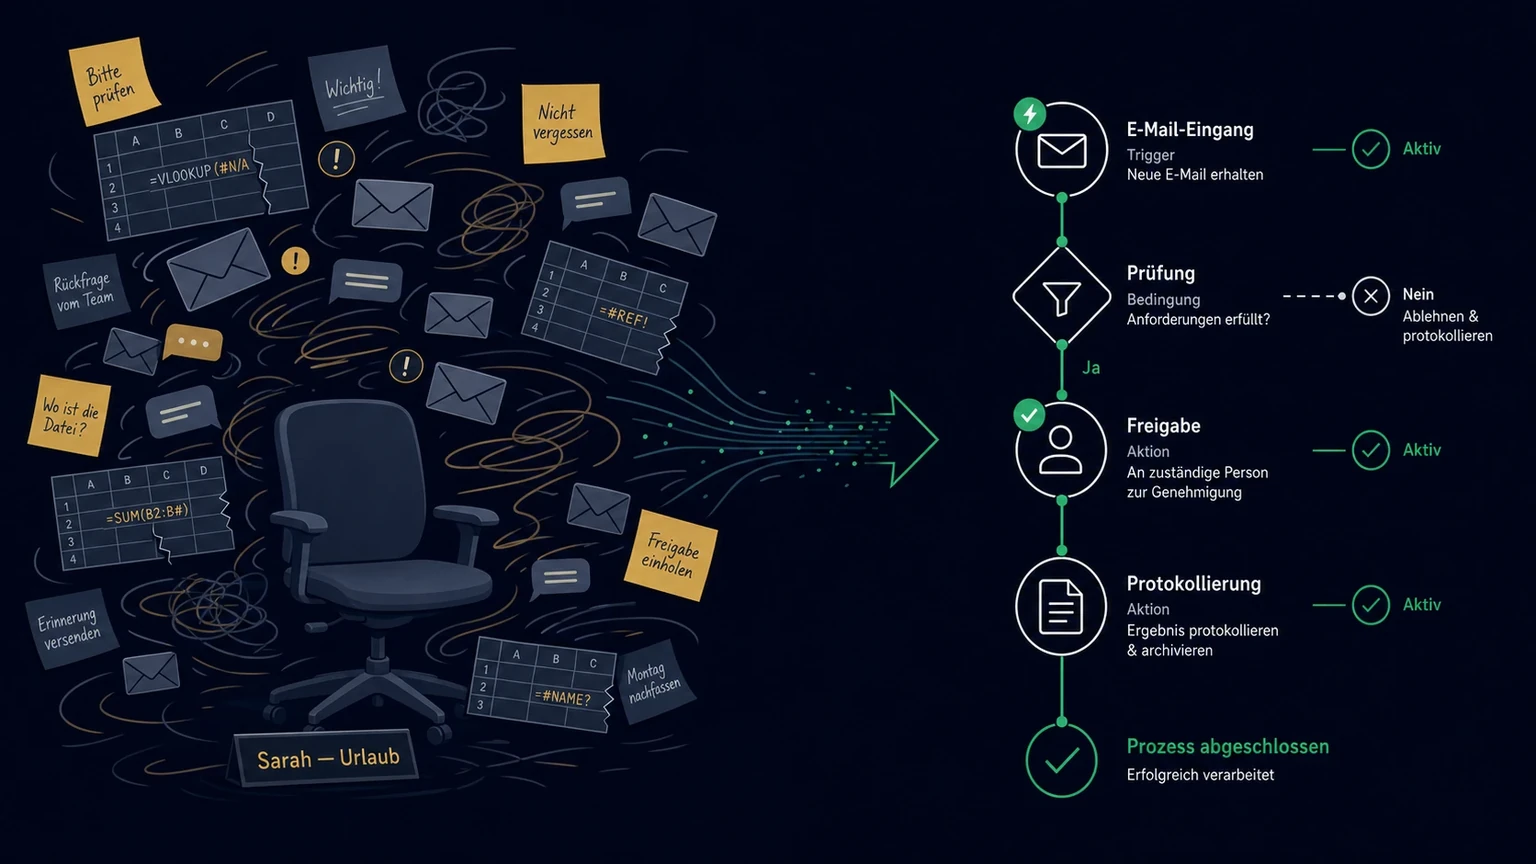
Es ist ein ganz gewöhnlicher Donnerstagvormittag, als der Sales-Onboarding-Workflow verstummt. Das Unternehmen ist ein 45-köpfiger B2B-Dienstleister aus der DACH-Region, der vor sechs Monaten begonnen hat, wiederkehrende Prozesse zu automatisieren – Neukunden-Onboarding, Rechnungsprüfung und Kunden-Triage. In der Demo lief der Onboarding-Workflow fehlerfrei. Jetzt, nach einer kleineren API-Änderung des CRM-Anbieters, bricht er still: Er wirft keine Fehlermeldung, er liefert schlicht veraltete Felder an nachgelagerte Systeme. Niemand bekommt einen Alarm.
Herr Bauer, Operations Manager, merkt es erst, wenn eine Kundin den fehlenden Begrüßungsworkflow reklamiert. Herr Köhler, IT-Leiter, findet die Ursache erst nach einem halben Tag Suche – ein Auth-Endpunkt hatte sich geändert, und der Workflow war punktweise direkt an die alte Schnittstelle geklebt. Es ist nicht der einzigeWorkflow mit diesem Problem: Im selben Zeitraum sind parallel zwei Schatten-Automatisierungen aus einzelnen Abteilungen entstanden, die niemandem gehören, kein Protokoll haben und deren Ergebnisse niemand abnimmt.
Dieses Szenario ist ein illustratives Beispiel, kein dokumentierter Planfold-Kundenfall. Es steht hier stellvertretend, weil es ein Muster verdichtet, das sich über Unternehmen und Werkzeuge hinweg wiederholt. Die Frage ist nicht, ob irgendein Workflow irgendwann bricht. Die Frage ist, wie Ihr Rollout reagiert, wenn es passiert – und ob überhaupt jemand bemerkt, dass er gebrochen ist.
Warum Automatisierungs-Rollouts scheitern: das Muster, nicht das Werkzeug
Die naheliegende Reaktion auf eine solche Szene lautet: falsches Werkzeug, falscher Anbieter, müssen wir wechseln. Der Rückblick zeigt etwas anderes. Das wiederkehrende Scheitern von Automatisierungs-Rollouts ist selten ein Werkzeugproblem. Es ist ein Problem des Betriebsmodells rund um das Werkzeug – und dieses Problem ist branchenweit belegt.
Die Zahlen sind eindeutig. IDC meldet, dass 88 Prozent der KI- und Automatisierungs-Proof-of-Concepts nie die Produktion erreichen (IDC-Befund, zitiert über das Lenovo CIO Playbook 2025). Das ist die Größenordnung dessen, was als Pilot Purgatory bekannt geworden ist: vielversprechende Experimente, die nie den Schritt in den produktiven Betrieb schaffen, weil niemand das Substrat aus Governance, Eigentümerschaft und stabiler Integration gebaut hat, das ein Workflow braucht, um dauerhaft zu laufen. Die BCG-Forschung zum AI Value Gap aus September 2025 unterstreicht dieselbe Diagnose: 60 Prozent der Unternehmen erzeugen keinen nennenswerten KI-Wert („Laggards“), 35 Prozent haben Erfolge in einzelnen Taschen („Scaler“), und nur 5 Prozent haben KI strukturell in die Organisation eingebettet („Future-built“). Die Lücke ist nach diesen Befunden eine Governance- und Betriebsmodell-Lücke, keine Werkzeuglücke – und das ist genau die These dieses Rückblicks.
Ein strukturiertes Referenzmodell hilft, die Diagnose zu ordnen. Das AI-Maturity-Modell von n8n beschreibt fünf Reifegrade, gemessen entlang der Dimensionen Nutzung, Komplexität, Governance und Infrastruktur. Zwei Beobachtungen daraus prägen diesen Artikel: Pilot Purgatory sitzt auf der experimentellen Stufe (L1), und der kritische Architektursprung ist eine eigene Orchestrierungsschicht samt verpflichtender menschlicher Freigaben (Human-in-the-Loop, HITL) ab der Integrationsstufe (L2). Das Rahmenwerk ist KI-geprägt; die Lektion gilt aber für Workflow-Automatisierung allgemein – auch für klassische, nicht-KI-gestützte Integrationen. Das Werkzeug macht einen Rollout nicht zuverlässig. Das Betriebsmodell rundherum macht ihn zuverlässig.
Die fünf wiederkehrenden Fehlermuster: eine Diagnose
Wer genug gescheiterte Rollouts gesehen hat, erkennt dieselben fünf Muster wieder. Sie treten einzeln auf, verstärken sich aber gegenseitig.
1. Pilot Purgatory – das Experiment, das nie in Produktion geht
Ein Prozess wird als Proof of Concept gebaut, funktioniert in der Demo und kommt nie in den produktiven Betrieb. Der IDC-Befund von 88 Prozent scheiternder POCs ist die harte Kennzahl für genau dieses Muster. Die Ursache ist nicht die Technologie, sondern das Fehlen von Eigentümerschaft, Integrationsdisziplin und dem Plan, wie der Workflow im Betrieb gehalten wird, sobald er live ist.
2. Spröde Punkt-zu-Punkt-Integrationen
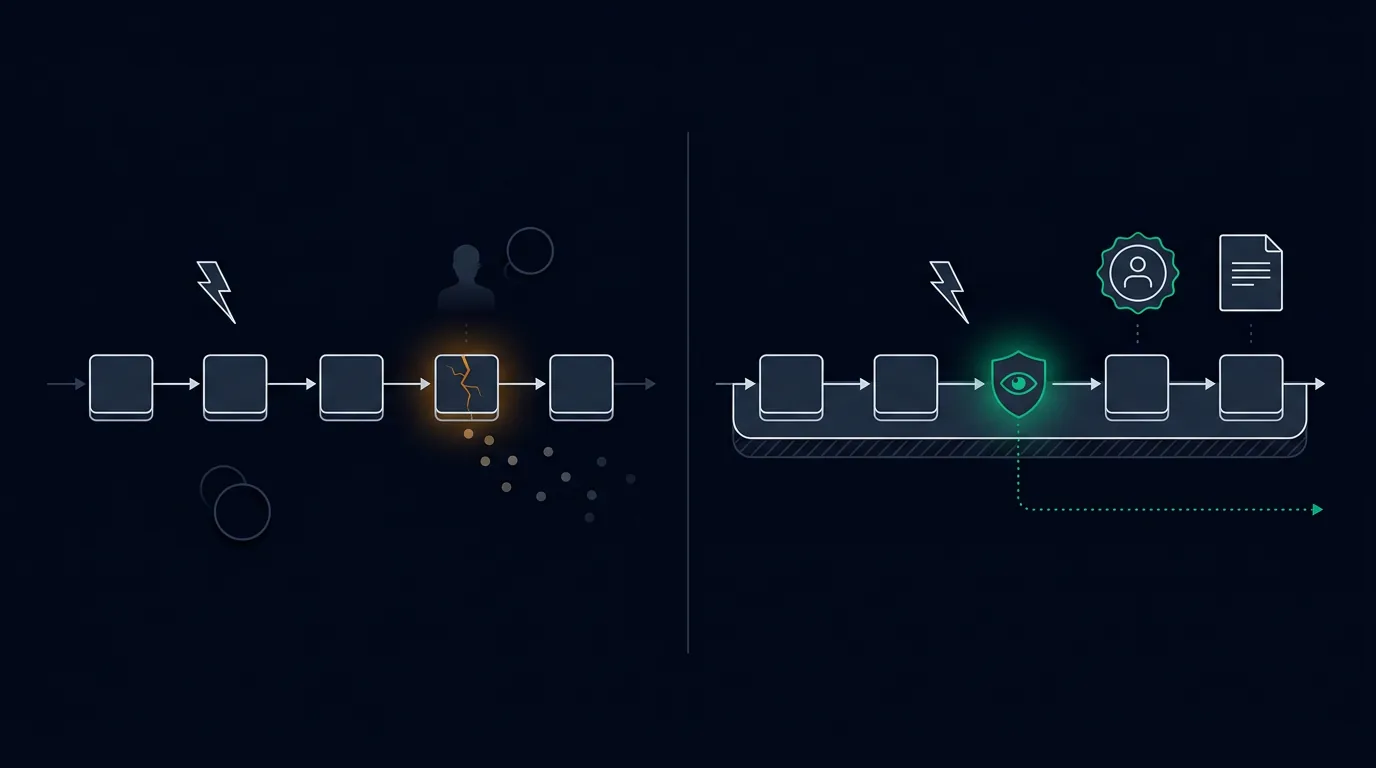
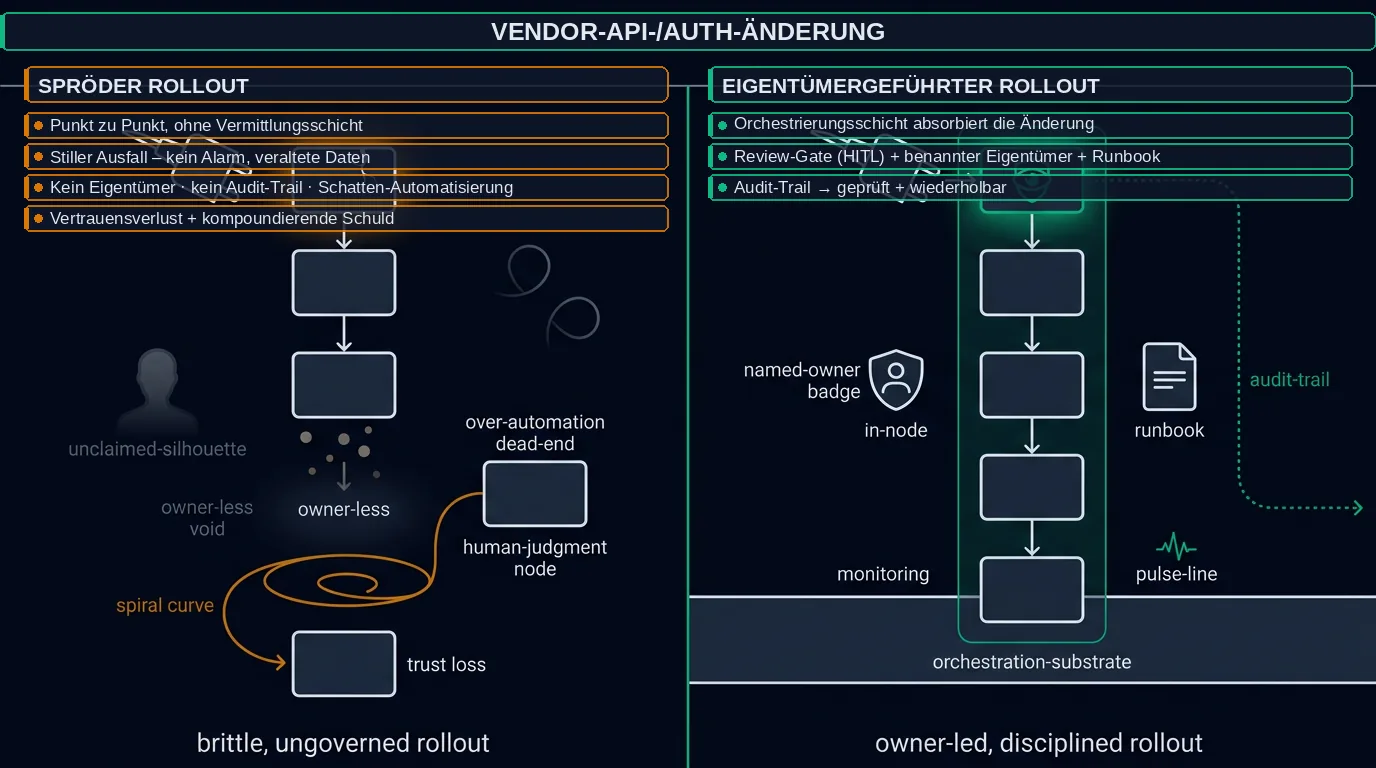
Workflows, die direkt von einem System zum nächsten geklebt sind, ohne Vermittlungsschicht, brechen bei der ersten Änderung einer API, eines Feldnamens oder eines Auth-Modells. Das ist eine dokumentierte betriebliche Realität, keine Behauptung über eine spezifische Ausfallquote. Das Problem: Es gibt keinen Eigentümer, der die Abhängigkeit kennt, und keinen Test, der den Bruch früh signalisiert. Stattdessen läuft der Workflow still weiter und liefert veraltete oder falsche Daten nachgelagert.
3. Ungesteuerte Schatten-Automatisierung
Mitarbeitende automatisieren, weil es schnell gehen muss – in persönlichen Konten, mit eigenen Zugängen, ohne geteiltes Protokoll. Das n8n-Rahmenwerk nennt diese Stufe Shadow AI: Die Organisation trägt das gesamte Risiko (Datenexposition, stille Fehlfunktionen, fehlender Audit-Trail), erntet aber keinen der strategischen Vorteile, weil niemand Bescheid weiß. Die Automatisierung läuft, aber niemand besitzt sie.
4. Over-Automation und fehlende Review-Gates
Ein Prozess, der menschliche Urteilskraft brauchte, wird vollständig automatisiert. Qualitätslücken erscheinen, und das Unternehmen muss menschliche Kontrolle reintroduzieren – nachdem der Vertrauensschaden bereits entstanden ist. Das Lehrbeispiel dafür ist ein benannter Rückblick aus der Praxis: Klarnas KI-Kundenservice lieferte im Q1-2025-Quartalsbericht messbare Skalierung und Ersparnis – die Transaktionskosten im Kundenservice fielen um 40 Prozent gegenüber Q1 2023, bei gehaltenen Kundenzufriedenheitswerten, und das System verarbeitete ein Volumen, das in der Größenordnung von rund 853 Vollzeitkräften lag (Quelle: Klarna-Quartalsbericht, zitiert über das n8n-Rahmenwerk). Die spätere Rücknahme – Klarna reintroduzierte nach Berichten über generische Antworten menschliche Kontrolle für komplexe Fälle – ist in späteren Klarna-Kommunikationen und Branchenberichten dokumentiert (getragen durch das n8n-Rahmenwerk, nicht durch den Q1-Berichtstext selbst). Die Lektion ist nicht, dass Automatisierung nicht funktioniert. Sie funktionierte, mit messbarer Ersparnis. Die Lektion ist: Skalierung ohne Qualitäts- und Freigabeplan für die Komplexität, die das System nicht abdecken kann, erzwingt eine reaktive Rücknahme, nachdem das Vertrauen bereits beschädigt ist. Das n8n-Rahmenwerk macht HITL-Prüfungen ab der Integrationsstufe (L2) zur Regel für jede Entscheidung mit spürbarem Geschäftseinfluss.
5. Fehlendes Ownership-Modell
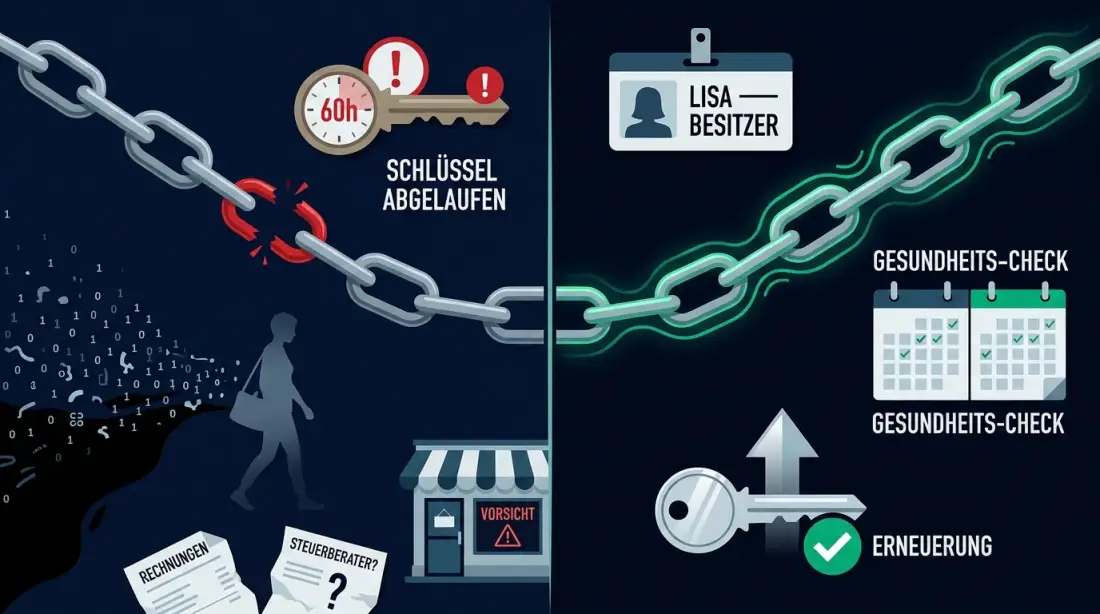
Workflows gehen live, ohne dass jemand ihre Datenformate, ihre Integration und ihren Audit-Trail besitzt. Wenn etwas bricht, ist unklar, wer entscheidet, wer den Rollout pflegt und wer die Freigabe für eine Änderung erteilt. Ohne Eigentümerschaft verkommt Automatisierung zu einer lastigen Immobilie, die niemand unterhält.
Die Kosten des Scheiterns: Business Impact
Die fünf Muster übersetzen sich in konkrete betriebliche Kosten – und diese Kosten sind kumulativ, nicht additiv. Jedes gescheiterte Rollout hinterlässt technische Schuld und Vertrauensverlust, der das nächste Rollout schwerer macht.
Am greifbarsten sind die unmittelbaren Rework-Kosten. Im illustrativen Szenario des 45-köpfigen B2B-Dienstleisters sind im Lauf von sechs Monaten grob die Hälfte der drei automatisierten Workflows an API- oder Auth-Änderungen gebrochen, etwa ein stiller Ausfall pro Woche, ohne dass es dafür einen Budgetposten oder einen benannten Eigentümer gab. Diese Zahlen sind ein exemplarisches Planungsmodell zur Veranschaulichung, keine harte Gewährleistung; die Annahmen sind offengelegt, damit Sie sie an Ihre eigene Lage anpassen. Die Aussagekraft liegt nicht im Euro-Betrag, sondern im Muster: Rework, das niemand budgetiert hat, fällt neben dem Tagesgeschäft an.
Teurer als das Rework ist der Vertrauensschaden. Der Klarna-Fall zeigt die Größenordnung der Exposition, wenn Automatisierung skaliert wird, bevor ein Plan für die Komplexität existiert, die sie nicht abdeckt: messbare Effizienzgewinne in der Breite, aber eine reaktive Rücknahme, nachdem Kundinnen generische Antworten erhalten hatten. Für ein KMU ohne die Reserven eines Konzerns wiegt der Vertrauensverlust bei Kundinnen schwerer, weil es weniger Puffer hat, um Reputation zu absorbieren.
Am nachhaltigsten wirkt die kompoundierende technische Schuld. Jeder Workflow, der punktweise geklebt und ohne Audit-Trail live ging, wird beim nächsten Mal schwerer zu ändern sein – nicht, weil das Werkzeug schlechter geworden wäre, sondern weil niemand mehr weiß, welche Abhängigkeiten existieren. Aus einem misslungenen Rollout wird so ein wiederkehrender Kostenblock, der die Schwelle für das nächste Automatisierungsvorhaben höher legt.
Warnsignale: diagnostische Signale für ein scheiterndes Rollout
Die meisten KMU spüren ein scheiterndes Rollout lange, bevor sie es benennen. Vier Signale deuten darauf hin, dass nicht ein einzelner Workflow, sondern das Betriebsmodell das Problem ist.
„Workflows brechen, ohne dass es einen Alarm gibt“
Wenn ein Workflow still veraltete Daten liefert und erst durch eine Kundenreklamation auffällt, fehlt die operative Sichtbarkeit. Retry ist keine Kontrolle: Eine spröde Integration, die still erneut, kann weiterhin falsche Daten nachgelagert ausliefern. Was fehlt, ist Monitoring, Alarmierung, ein Eigentümer und eine definierte Eskalation.
„Niemand besitzt den Audit-Trail“
Wenn niemand sagen kann, wann ein Workflow zuletzt lief, wer eine Änderung freigegeben hat und welche Version in Produktion aktiv ist, existiert die Automatisierung nur als Annahme. Ein Workflow ohne Version, ohne Laufprotokoll und ohne Freigabehistorie lässt sich weder prüfen noch kontrolliert ändern.
„Demos erreichen nie die Produktion“
Wenn jedes Quartal neue POCs entstehen, aber kaum einer den Sprung in den produktiven Betrieb schafft, sitzen Sie mitten in der Pilot Purgatory. Das IDC-Kennzeichen von 88 Prozent ist keine Großunternehmens-Diagnose – KMU sind stärker exponiert, nicht schwächer, weil sie weniger Personal haben, um das Rework zu absorbieren, wenn ein Pilot nie ausgerollt wird.
„Prozesse laufen ohne menschliche Prüfung, wo Urteilskraft nötig wäre“
Wenn kunden- oder finanzseitige Entscheidungen vollständig und ohne Freigabetor automatisiert sind, fehlen die Review-Gates, die das n8n-Rahmenwerk ab der Integrationsstufe zur Regel macht. Over-Automation zeigt sich selten im Normalfall – sie zeigt sich in den Fällen, die der Automatisierung nicht einzuordnen gelingen.
Wer zwei oder mehr dieser Signale bei sich erkennt, hat kein Werkzeugproblem. Sie haben ein Betriebsmodell-Problem: Ihr Rollout ist so gebaut, dass Ausfälle unsichtbar bleiben und Eigentümerschaft undefiniert ist.
Wie disziplinierte Rollouts den Schock absorbieren
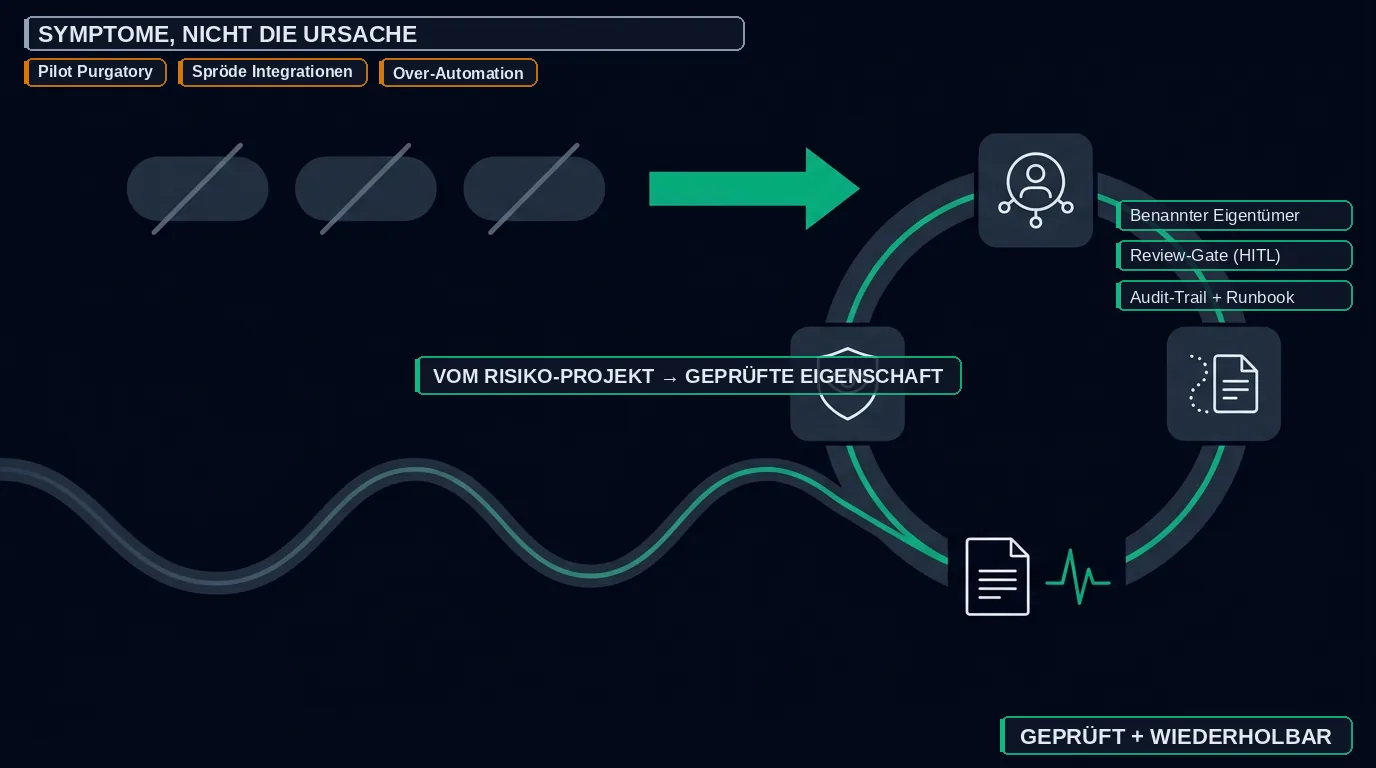
Die technische Antwort auf die fünf Muster ist kein besseres Werkzeug, sondern ein anderes Betriebsmodell – eines, das Automatisierung als geprüfte, eigentümergeführte Eigenschaft anlegt statt als Einmalprojekt. Vier Bausteine tragen das, und jeder zählt einzeln.
Mit einem Prozess starten. Der disziplinierte Rollout beginnt mit genau einem Prozess, der einen hohen, gut verstandenen Wert hat. Das reduziert die Variablen, bevor Sie Orchestrierung und Review-Gates im Betrieb beweisen müssen. Wer mit fünf Prozessen gleichzeitig startet, verteilt die Anstrengung so dünn, dass keiner davon wirklich owned wird.
Datenformate und Integrationsschicht besitzen. Statt punktweise von System zu System zu kleben, bauen Sie eine eigene Orchestrierungsschicht und kontrollieren die Datenformate selbst. Das ist der Architektursprung, den das n8n-Rahmenwerk als kritisch markiert: Die Integrationsschicht ist der Ort, an dem eine Vendor-Änderung abgefangen wird, statt im Workflow zu kaskadieren. Wer die Schemakontrolle besitzt, enteignet das Datenmodell vom Anbieter.
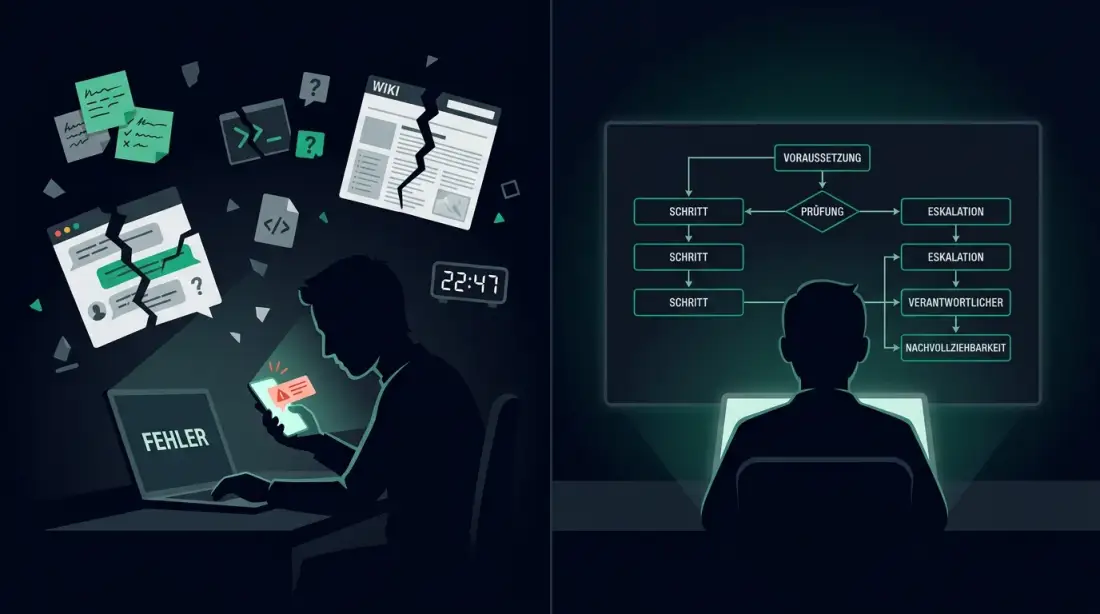
Review-Gates und Audit-Trail ab Tag eins. Jede Entscheidung mit Kunden- oder Finanzwirkung durchläuft ein HITL-Freigabetor. Workflow-Definitionen, Versionen und Änderungshistorie liegen im Code; Laufprotokolle, Fehlerpfade und Freigaben werden pro Ausführung festgehalten. Damit wird aus einer stillen Ausfallstelle ein geprüfter Prozess, den jemand kontrolliert ändern kann, statt ihn heimlich neu zu kleben.
Operative Klarheit als Eigenschaft. Observability, Runbooks und benannte Eigentümer sind keine Start-Checkbox, sondern eine dauerhafte Eigenschaft. Ein Workflow, der läuft, ist nicht fertig. Er braucht eine Person, die seine Gesundheit kontinuierlich sichert, und ein Runbook, das beschreibt, was passiert, wenn ein Anbieter eine API ändert.
Operative Klarheit als dauerhafter Zustand
Viele KMU behandeln einen Automatisierungs-Rollout wie ein Projekt, das man abschließt. Genau diese Annahme hält die Fehlermuster am Leben. Operative Klarheit ist nur dann eine echte Fähigkeit, wenn sie zu einer messbaren, wiederkehrenden Eigenschaft wird – nicht zu einem Pfeiler im Eröffnungs-Slide.
Drei Praktiken machen den Unterschied zwischen „wir könnten theoretisch automatisieren“ und „wir haben in diesem Quartal einen geprüften Rollout bewiesen“. Erstens: Jeder Workflow hat einen benannten Eigentümer und ein definiertes Review-Checkpoint für jede Entscheidung mit Kunden- oder Finanzwirkung. Zweitens: Eine wöchentliche Fehler-Schau fängt stille Ausfälle auf und speist die Erkenntnisse in die Runbooks zurück. Drittens: Wenn ein Anbieter eine API ändert, gibt es einen bekannten, geprobten Pfad – nicht eine Ad-hoc-Reparatur unter Druck.
Diese Disziplin ist leichter als ein Enterprise-Governance-Programm und schwerer als ein set-and-forget. Für den 45-köpfigen B2B-Dienstleister aus der Eröffnung bedeutet das konkret: Herr Bauer hält pro Workflow fest, welche Freigaben kunden- oder finanzseitig nötig sind; Herr Köhler betreibt die Orchestrierungsschicht als Code mit Versions- und Laufprotokoll; eine kurze wöchentliche Schau sortiert stille Ausfälle aus, bevor eine Kundin sie reklamiert. Aus einem riskanten Rollout wird so eine geprüfte, wiederholbare Eigenschaft – und der nächste Rollout beginnt nicht wieder bei null.
Der Planfold-Blick: Automation als geprüfter Zustand statt als Lotterie
Planfold rahmt gescheiterte Automatisierungs-Rollouts als wiederkehrenden operativen Risiko- und Kapitalabfluss – und disziplinierte Eigentümerschaft als den Kostenkontroll-Mechanismus, der aus einer riskanten Automatisierung eine geprüfte, wiederholbare Eigenschaft macht. Unsere Methodik folgt drei technisch definierten Phasen.
Plan bedeutet, Prozesse, technische Schuld, Integrationsfragilität und Ownership-Lücken zu auditieren. Wir kartieren, welche Workflows bereits owned sind, welche punktweise geklebt brechen und welche Schatten-Automatisierung ungesteuert läuft. Das Ergebnis ist eine priorisierte Liste konkreter Expositionen, kein theoretisches Landschaftsbild.
Unfold bedeutet, Systeme zu bauen und zu integrieren: eine eigentümergeführte Orchestrierungsschicht auf selbstgehostetem n8n, eigene Datenformate, Review-Gates und Audit-Trail ab dem ersten Workflow. Die Umsetzung folgt anerkannten Standards; unsere Teams sind CKA- und CKAD-zertifiziert, ergänzt durch LFCS. Festpreisengagements für Automatisierung beginnen bei 1.500 Euro. Das ist ein Planfold-Dienst, kein Headcount, den Sie einstellen müssen.
Resonate bedeutet stabiler Betrieb mit Observability, Runbooks und benannten Eigentümern. Ein Workflow, der läuft, ist nicht fertig – er braucht eine Person, die seine Gesundheit kontrolliert, und ein Runbook, das den Pfad für die nächste Vendor-Änderung beschreibt.
Die ehrliche Grenze: Disziplin eliminiert nicht jede Abhängigkeit und keine Automatisierung läuft ohne Wartung. Planfold garantiert weder spezifische Einsparungen, ROI, Uptime noch feste Rollout-Zeitleisten – konkrete Ergebnisse hängen am Prozess, am Team und an der Betriebssorgfalt. Aber wenn der nächste Anbieter eine API ändert, ist Ihre Antwort ein geprüfter, owned Workflow – kein stiller Ausfall, den eine Kundenreklamation aufdeckt.