Von ad-hoc Deployments zu kontrollierter Multi-Stage-Auslieferung
Wie KMU mit 10–100 Mitarbeitenden eine nachvollziehbare Lieferkette mit GitLab, Nexus3 und ArgoCD aufbauen: immutable Artefakte, Stage-Promotion und klare Freigabeverantwortung.
Inhalt
Wie KMU mit 10–100 Mitarbeitenden eine nachvollziehbare Lieferkette mit GitLab, Nexus3 und ArgoCD aufbauen: immutable Artefakte, Stage-Promotion und klare Freigabeverantwortung.
Artikel teilen
Der Dienstag, an dem drei Teams denselben Auslieferungsfehler hatten
Es ist 8:30 Uhr an einem Dienstag. In einem Produktteam mit zwölf Bereitstellungen im Monat soll ein kleiner Hotfix für eine API-Routing-Änderung in Produktion gehen. In der Entwicklungsumgebung lief die Änderung seit Tagen stabil, in Staging wurde sie mit anderem Flag-Set geprüft und in Produktion gibt es plötzlich einen Request-Mismatch.
Die Ursache liegt nicht an der App – sie liegt an der Lieferkette.
Das Team hatte für jede Umgebung neu gebaut, obwohl die zugrundeliegende Feature-Branch derselbe war. Staging erhielt Tag A als Image, Produktion Tag B, weil ein Skript für den Release-Schritt in einer Abendänderung manuell angepasst wurde. Niemand konnte in 90 Sekunden beantworten, welche Git-Commit-ID tatsächlich im Produktivcluster aktiv war. Die Auswirkung: der Incident-Channel füllt sich, der Kunde meldet Fehlverhalten, die Verantwortlichkeiten sind unklar.
Dieses Bild ist nicht außergewöhnlich. Viele KMU haben genau die Kombination:
- eigenes Produkt mit 10 bis 100 Mitarbeitenden,
- ein bis zwei Engpassrollen im Engineering,
- Containerisierung als Zielplattform,
- und trotzdem noch ein Auslieferungsmodell, das eher aus Skript-Hektik als aus kontrollierter Promotion entsteht.
Wenn ein Team mit wenig operativer Tiefe aus dieser Lage startet, ist die Frage nicht: Sollten wir Kubernetes machen? Die Frage ist: wie organisieren wir Auslieferung, damit jeder Versionssprung nachvollziehbar und rückholbar bleibt.
Warum ad-hoc Auslieferung bei KMU so häufig auftritt
Das Problem beginnt oft mit guter Intention. Man will schnell liefern. Teams wollen nicht mit schweren Plattform-Prozessen belasten. Also entstehen pragmatische Regeln:
- jede Umgebung bekommt ihren eigenen Build, damit Tests sicher bleiben.
- wer es gerade braucht, passt die Release-Schritte im CI-Skript an.
- Promotion bedeutet in der Praxis: manuelles Umkopieren einer Konfiguration.
- Dokumentation bleibt nachgelagert – oft in Chat-Notizen.
Diese Muster senken kurzfristig Friktion, erhöhen aber langfristig das Risiko.
Was hier schiefläuft:
- Versionsspur geht verloren: Commit-ID, Pipeline-ID, Artefakt und Sync-Revision lassen sich nur schwer koppeln.
- Änderungen werden pro Umgebung als Neubau behandelt, obwohl die Auslieferungslogik eigentlich identisch sein sollte.
- Freigaben basieren auf Personenwissen statt auf überprüfbaren Daten.
- Rollbacks dauern länger, weil genau nicht klar ist, welches Artefakt wiederhergestellt wird.
GitLab beschreibt im CI/CD-Modell klar, dass Pipeline-Definitionen, Jobs, Regeln und Umgebungen die zentrale Steuerung liefern. Wenn diese Daten nicht zur Auslieferungsentscheidung genutzt werden, bleibt die Organisation auf implizite Abhängigkeiten angewiesen 1.
Warum das eigentliche Thema nicht Kubernetes ist, sondern Auslieferungsdisziplin
Viele Leser kommen mit der erwarteten Frage: „Jetzt zeigen Sie mir ein Kubernetes-Setup.“ Genau hier liegt die Fehlannahme. Kubernetes ist in vielen Fällen die Ausführungsumgebung – nicht die eigentliche Lösung des Auslieferungsproblems.
Ein kontrolliertes Modell braucht drei Trennlinien:
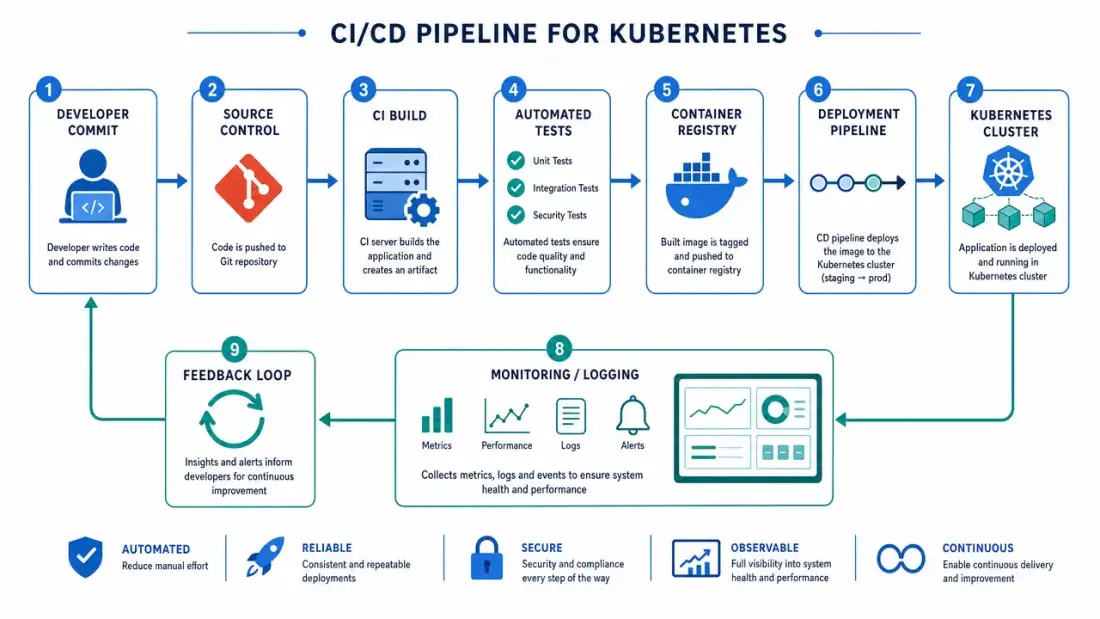
- Build-Zuständigkeit in GitLab CI
- Artefakt-Haftung in Nexus3
- Rekonstruktions- und Sync-Verantwortung in ArgoCD
Das ist das Prinzip: build once, promote deliberately.
Damit entsteht ein entscheidender Unterschied:
- nicht jede Stage baut neu und verändert Semantik,
- stattdessen wird dieselbe unveränderte Artefakt-Version kontrolliert freigegeben, geprüft und anschließend über Stages propagiert.
Zielbild: Von Commit bis zum Cluster mit klarer Kette
Die Architekturidee klingt technisch, ist aber operativ direkt umsetzbar.
1. GitLab als Quelle der Wahrheit
GitLab bleibt hier die Quelle für Code, Merge-Entscheidung, Pipeline-Policy und Release-Kopplung. Für ein Unternehmen ist das wichtig, weil die Verifikation beginnt, wenn Sie genau wissen, welcher Stand zur Freigabe gelangt.
Pragmatischer Standard für KMU:
- Merge-Request-Reviews auf dem eigentlichen Branch, nicht nur auf Ticket-Basis.
- CI-Stage für Build, Tests, Chart-Validierung und Security-Checks (je nach Profil).
- Explizite Umgebungen mit Regeln für Stage-Gates: Entwicklung, Staging, Produktion.
GitLab bietet hierfür nicht nur Build- und Pipeline-Funktionen, sondern auch kontrollierbare Umgebungslogik über Deployment-Approvals und geschützte Environments 2.
2. Nexus3 als Artefakt-Hub, nicht nur Registry „mal schnell“
Das zweite Problem früher ad-hoc Delivery-Modelle ist die Verwechslung von Image und Release.
In vielen Teams wird ein Image je Umgebung neu gebaut und so unterschiedliche Binärstände erzeugt. Im Incident wird dann mit „in einem Tag neu gebaut“ argumentiert, während im Nachhinein niemand die tatsächliche Produktionversion verifizieren kann.
Nexus3 als Artefakt-Depot bringt eine klare Trennung:
- Container-Images und Helm-Charts werden versioniert und zentral verwaltet.
- Build-Resultate werden nicht implizit verworfen oder ersetzt.
- Die Review-Entscheidung kann auf einem gespeicherten Artefakt basieren.
Das Team dokumentiert damit nicht „welcher Commit läuft“, sondern „welches Artefakt mit welcher Digest-Version ist freigegeben“. Sonatype-Repo-Unterstützung für Docker- und Helm-Formate ist dafür ein praktisches Fundament 3.
3. ArgoCD als pull-basiertes Reconciliation-Layer
ArgoCD sorgt dafür, dass der gewünschte Zustand aus Git angewendet und laufend abgeglichen wird. Entscheidend: Das ist kein ad-hoc „Push auf Cluster“ aus CI, sondern ein kontrollierter Synchronisationsprozess aus einem separaten, versionierten Repository/Workflow heraus 4.
Mit diesem Modell entsteht ein sauberer Audit-Trail:
- Wer hat im GitOps-Repo die gewünschte Version freigegeben?
- Welche Sync-Revision wurde angewendet?
- Wann wurde eine Rücknahme (Rollback) dokumentiert?
Für den Betrieb bedeutet das: geringere Überraschung, weil Reconciliation-Status und Drift sichtbar sind.
Multi-Stage Delivery im Alltag: dev, staging, production
Die meisten Teams stolpern nicht bei Helm, sondern bei dem Moment, an dem Stage-Gates verwässert werden. Eine „kontrollierte“ Umgebung bedeutet nicht, dass staging oder production langsamer werden müssen; es bedeutet, dass Entscheidungen nicht mehr nach Bauchgefühl laufen.
Dev-Stage: Geschwindigkeit mit klarer Basis
In der Entwicklungsstage zählen hohe Taktung und frühe Fehlererkennung. GitLab kann häufigere Builds, Feature-Tests und Integrationstests liefern. Die Voraussetzung ist, dass bereits Artefaktregeln gelten: Sobald ein Build stabil durchläuft, steht die Version im Depot bereit.
Staging-Stage: Plausibilität vor Übernahme
Hier wird geprüft, ob Verhalten, Datenmasken, Konfigurations-Patches und SLO-basierte Smoke-Tests mit dem eigentlichen Zielbild kompatibel sind.
Typische Freigabekriterien:
- Ergebnisstatus der Tests.
- Freigabe eines Release-Managers.
- Dokumentation der Konfigurationsanpassungen.
Production-Stage: Freigabepfad statt Notfall-Pushes
Für produktive Umgebungen empfiehlt sich eine explizite Gate-Struktur:
- Freigabe durch definierte Rolle (nicht nur „derjenige, der die Änderung gebaut hat“),
- Schutz der Umgebung gegen ungeplante direkte Updates,
- definiertes Rollback-Ziel mit klarer Zielartefakt-Referenz.
Wesentlich: Diese Struktur ist gerade für 10–100 Mitarbeitende machbar, wenn man sie auf wenige kritische Workflows beschränkt.
GitLab CI, Nexus3 und ArgoCD im operativen Zusammenspiel
In vielen Organisationen ist eine Frage zentral: „Bauen wir einen GitOps-Repo oder nicht?“ Die Antwort ist nicht dogmatisch. Für manche Teams ist ein zentrales GitOps-Repo für alle Anwendungen überdimensioniert.
Eine pragmatische Reihenfolge:
- Schritt A: Wählen Sie einen produktionsnahen Service mit hoher Betriebsrelevanz.
- Schritt B: Definieren Sie die Pipeline in GitLab für Build/Test/Publish.
- Schritt C: Speichern Sie Artifact-ID, Tag-Strategie und Bereitstellungsversion in einem kontrollierten Auslieferungsdokument.
- Schritt D: Synchronisieren Sie die gewünschte Stage-Reihenfolge über ArgoCD.
Helm und Kustomize sind hier nicht Gegensätze, sondern Rollen mit klarer Grenze.
Helm als Standard für App-Pakete, Kustomize dort, wo es Sinn macht
Helm bleibt oft die bessere Wahl, wenn ein eigener Workload mit mehreren Komponenten, Release-Logik und Rollbacks betrieben wird. Helm-Charts bringen Paketierung, Versionierung und Release-Ziele sauber in die Auslieferungslogik 5. Kustomize eignet sich für kleinräumige Anpassungen – etwa Namespace- oder Monitoring-spezifische Strukturierung, wo ein eigenes Overlay sauberer ist als komplexe Helm-Werte-Fächer.
Wenn man beides vermischt ohne Regel, entsteht ein typischer Nebel:
- Werte werden über alle Layer verteilt,
- Promotionlogik wird unleserlich,
- Diff-Analyse wird schwer.
Kubernetes-Docs beschreibt das Base/Overlay-Prinzip für Kustomize und macht die Grenzen deutlich: Es ist ein starkes Instrument für kontrollierte Kontextanpassung, aber nicht automatisch der richtige Standard für alles 6.
Rollenmodell für einen Teamkontext mit wenig Operativbudget
Ein robustes Modell braucht weniger Rollen als oft angenommen:
- Delivery Owner: Entscheidet über Promotion-Reihenfolge und Notfall-Flow.
- Service Owner: Verantwortet Build-Stabilität und Testqualität.
- Reviewer: Prüft Staging-Ergebnisse vor Produktion.
- Incident-Hüter: Bewertet Rollbacks und Follow-ups.
Ein realistisches Datenbild für KMU:
- In einem mittelständischen Team mit etwa 5–8 Deploy-Vorgängen/Woche entstehen ohne Artefaktkette oft 20–60 Minuten reine Suchzeit pro Incident, um Versionen und Freigaben nachzuvollziehen.
- Die eigentliche Fehlerbehebung dauert dadurch länger und wird weniger vorhersagbar.
Diese Zahlen sind als Planungsrahmen zu lesen, nicht als universelle Statistik.
Die Steuerungsfrage bleibt: Wer zeichnet nach, ob die Freigabekriterien erfüllt wurden? Ohne diese Verantwortungszene bleibt „Continuous Deployment“ im besten Fall Geschwindigkeit im Blindflug.
Typische Stolpersteine und Gegenmaßnahmen
1) „Wir brauchen weniger Freigaben, mehr Tempo“
Lösung: Beschränken Sie explizite Freigaben auf Produktion. Dev und Staging können weiterhin automatisiert laufen.
2) „Wir nehmen alles in Kustomize“
Lösung: Nutzen Sie Kustomize dort, wo Strukturen wirklich „overlay-artig“ sind. Für Applikationspakete mit klarer Versionslogik ist Helm oft lesbarer.
3) „Wir haben keine Zeit für GitOps-Repo“
Lösung: Starten Sie mit einem kleinen, dedizierten Auslieferungsrepo für genau einen Service und erweitern Sie erst nach der ersten stabilen Promotion.
4) „GitLab kann das alles nicht abbilden“
Lösung: GitLab trägt Pipeline- und Freigabe-Logik; ArgoCD übernimmt Ausführungs- und Revisionsabgleichs-Logik. Das ist die Rollenentkopplung, die für sichere Audit-Pfade hilft.
Was Sie versprechen können — und was Sie nicht versprechen sollten
Versprechen Sie in diesem Modell:
- reproduzierbare Artefakt-Promotions je Auslieferungsstufe,
- nachvollziehbare Freigaben mit eindeutiger Verantwortungszuordnung,
- klarere Rollback-Pfade mit belastbaren Referenzen.
Versprechen Sie nicht:
- Null-Fehler-Betrieb durch Tooling allein,
- vollständige Compliance-Bescheinigung ohne ergänzende Sicherheits- und Betriebsmaßnahmen,
- sofortige Plattform-Reife ohne gewachsene Betriebsroutine.
Was dieses Modell nicht verspricht
Es gibt klare Grenzen:
- Es ersetzt keine vollständige Sicherheitshardening-Strategie.
- Es garantiert keine lückenlose Compliance-Bescheinigung.
- Es ist kein Zauber für Team-Verfügbarkeitsprobleme.
Es macht aber klarer:
- was in welcher Version ausgeliefert wurde,
- auf welcher Freigabebasis,
- mit welchem Rückbaupfad.
Das ist für viele Teams der entscheidende Unterschied zwischen „läuft meistens“ und „lässt sich verantwortbar betreiben“.
Eine 6-Wochen-Praxis für Ihr nächstes Quartal
Wochen 1–2: Transparenz der Lieferkette
- einen Workflow auswählen.
- Definition der Stages und Freigabepunkte festlegen.
- Image- und Chart-Naming-Standard definieren.
- Nachweise im Team dokumentieren.
Wochen 3–4: Artefakte stabilisieren
- Build einmalig pro Commit-Run erzeugen.
- Container und Helm Chart in Nexus3 veröffentlichen.
- Digest/Version als Pflichtreferenz in der Promotion definieren.
Wochen 5–6: Kontrollierte Promotion einführen
- ArgoCD nur noch über zugelassene Versionen syncen.
- Produktions-Promotion mit manuell verifizierter Freigabe ergänzen.
- Rollback-Übung auf demselben Artefakt abbilden.
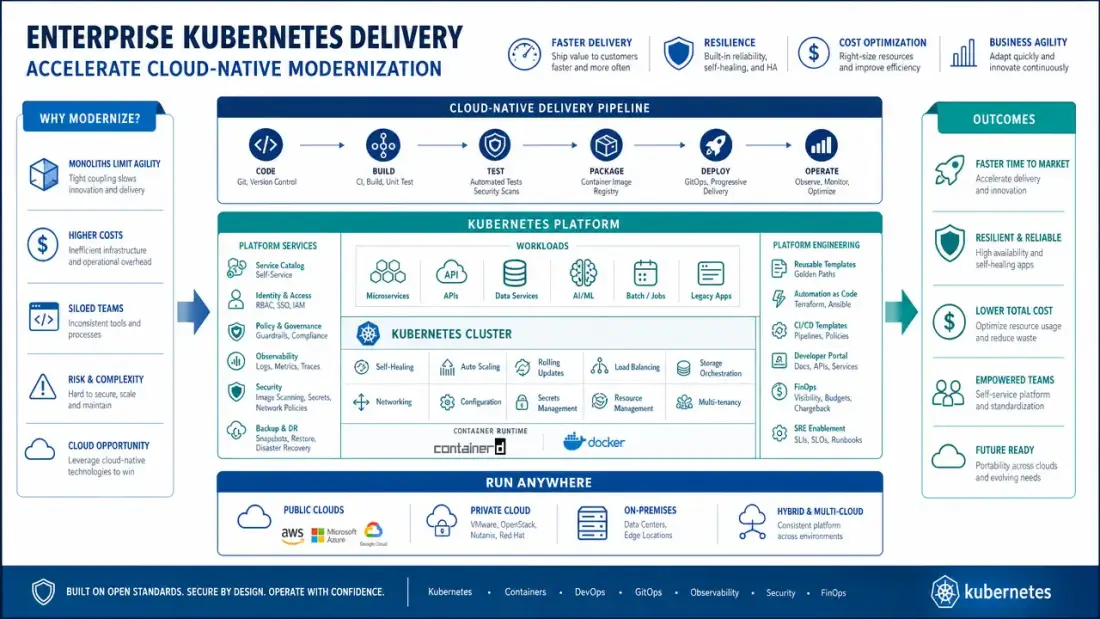
Ergebnisbild für die Organisation: Geschwindigkeit, die erklärbar bleibt
Ein Team, das diesen Pfad etabliert, gewinnt nicht automatisch „mehr Performance“, sondern bessere Vorhersagbarkeit:
- Incident-Diagnose beginnt mit klarer Version und Stage-Historie.
- Review-Gespräche richten sich auf kontrollierte Freigabeketten statt auf Vermutungen.
- Ausrollfehler werden früher erkannt, weil Sync-Differenzen sichtbar werden.
Und ja: Für 10–100 Mitarbeitende ist genau diese Steuerbarkeit oft der Schlüssel. Denn große Skalierung in der Architektur beginnt mit sauberer Miniatur: einem Service, der stabil ausliefert, statt fünf parallelen manuellen Mustern.
Footnotes
Verwandte Artikel
Vom Migrations-Laufband herunter: Wie KMU die Kosten erzwungener Anbieter-Migrationen stoppen
Plattform-Eigentum für KMU: Ein Playbook vom gemieteten Silo zur eigenen, tragfähigen Infrastruktur