Daten-Schwerkraft: Warum Datenlokalität zur Betriebsfrage wird
Wenn Unternehmensdaten über SaaS, Cloud, KI-Tools und Exporte verstreut sind, wird Automatisierung riskant. Dieser Leitfaden zeigt, wie KMU Datenflüsse, Eigentum und Souveränität praktisch ordnen.
Inhalt
Wenn Unternehmensdaten über SaaS, Cloud, KI-Tools und Exporte verstreut sind, wird Automatisierung riskant. Dieser Leitfaden zeigt, wie KMU Datenflüsse, Eigentum und Souveränität praktisch ordnen.
Artikel teilen
Der Moment, in dem die KI-Pilotphase an einer Frage stoppt: Wo leben die Daten?
Die Szene ist in vielen mittelständischen Unternehmen ähnlich: Die Geschäftsführung möchte KI-gestützte Anfrage-Triage oder automatisierte Angebotsentwürfe einführen. Das Geschäftsziel ist klar — schnellere Reaktionszeiten, konsistentere Angebote, weniger manuelle Koordination. Dieses Ziel lässt sich aber nur ohne Compliance-Nacharbeit erreichen, wenn Datenresidenz und Verarbeitungsgrenzen von Beginn an architektonisch verankert sind. DSGVO-by-Design bedeutet, diese Entscheidungen vor dem ersten Produktivbetrieb zu treffen, nicht nach dem nächsten Audit.
Doch dann kommt die entscheidende Hürde: Niemand kann präzise erklären, welche Quelle aktuell ist, welche Systeme Kundendaten verarbeiten, welche Exporte noch in Ordnern liegen und wo die rechtlichen oder operativen Grenzen verlaufen.
In diesem Moment wird klar: Datenlokalität ist keine technische Fußnote für die IT-Abteilung. Sie ist eine zentrale Betriebsentscheidung. Laut der Eurostat-Erhebung 2025 zur IKT-Nutzung in Unternehmen setzten bereits 20,0 % der EU-Unternehmen mit mehr als 10 Beschäftigten KI-Technologien ein, wobei Textanalyse und Texterzeugung zu den häufigsten Anwendungen gehörten. Bezahlte Cloud-Dienste sind gleichzeitig längst Alltag, auch in kleineren Unternehmen. Die Frage "Wo leben unsere Daten?" betrifft daher nicht nur Konzerne mit eigenen Rechenzentren, sondern Betriebe, Agenturen, Dienstleister und Solo-Gründer, die ihre Arbeit über SaaS, Cloud, Automatisierung und KI organisieren.
Wer automatisiert, ohne die Schwerkraft seiner Daten zu verstehen, baut auf unsicherem Grund. Die erste Version fühlt sich schnell an, weil Kontext kopiert, Berechtigungen improvisiert und Ergebnisse manuell geprüft werden. Sobald der Workflow aber geschäftskritisch wird, zählen andere Fragen: Welche Quelle ist verbindlich? Wer darf sie ändern? Wo werden Zwischenergebnisse gespeichert? Wie lässt sich der Prozess umziehen, wenn ein Anbieter, Vertrag oder Risiko sich ändert?
Was Daten-Schwerkraft für ein echtes Unternehmen bedeutet
Daten ziehen Workflows an sich
Der Begriff "Data Gravity" beschreibt ein einfaches Prinzip: Große oder wichtige Datensätze ziehen Anwendungen, Dienste, Rechenleistung und vor allem Team-Gewohnheiten an. Sobald Kundenhistorien, Projektkontexte und Automatisierungszustände an einem Ort leben, sammeln sich immer mehr Werkzeuge und Abhängigkeiten um diesen Kern. Die "Masse" ist hier nicht nur das Datenvolumen, sondern die operative Autorität.
Für ein KMU ist diese Autorität sehr konkret. Das CRM kennt vielleicht die Verkaufsphase, die gemeinsame Inbox enthält aber die neuesten Kundenworte. Das Projekttool kennt Aufgaben, die Angebotslogik liegt in alten Dokumenten, und das Wissen über Sonderfälle steckt in E-Mails. Wenn KI daraus einen Vorschlag machen soll, zieht sie unweigerlich zu den Stellen, an denen Kontext verfügbar ist. Sind diese Stellen nicht geordnet, folgt der Workflow der Bequemlichkeit statt der Geschäftslogik.
Lokalität bedeutet Kontrolle, nicht Isolation
Es geht nicht darum, Cloud-Dienste oder SaaS-Convenience pauschal abzulehnen. Das Ziel ist es, zu wissen, was wohin gehört. Welche Daten brauchen eine starke lokale Ownership? Welche Workflows können sicher auf gemanagten Plattformen laufen? Welche Informationen dürfen in KI-gestützte Verarbeitung, und welche brauchen zuerst eine fachliche oder datenschutzrechtliche Prüfung?
Souveränität bedeutet, den Überblick über Datenflüsse, Zugriffsberechtigungen und Verarbeitungsorte zu behalten. Gerade in der Cloud reicht ein einfaches Etikett wie "EU gehostet" oder "self-hosted" nicht aus. Entscheidend sind Zugriffspfade, Unterauftragnehmer, Backups, Administrationsrechte, Exportformate, Protokolle und die Frage, wer im Unternehmen fachlich entscheiden kann, ob ein Workflow so betrieben werden darf.
Das Risiko: Wenn Daten schleichend aus dem Unternehmen driften
Wenn Daten unkontrolliert in isolierten Tools, KI-Assistenten, Exportordnern und Beraterkonten landen, wirkt das anfangs bequem. Das Team bewegt sich schneller, weil niemand erst Architekturentscheidungen treffen muss. Die Kosten kommen später, und sie erscheinen selten als eine einzelne Rechnung. Sie zeigen sich als Suchzeit, Nacharbeit, unnötige Abos, blockierte Migrationen und schwächeres Vertrauen in die eigenen Abläufe.
Für deutsche KMU wird daraus oft zuerst ein Betriebsproblem, erst danach ein juristisches Thema. Eine Datenschutzprüfung, ein Anbieterwechsel oder eine KI-Erweiterung scheitert nicht, weil niemand guten Willen hat. Sie scheitert, weil die Firma ihre eigene Datenlandkarte nicht schnell genug erklären kann.
Zeitverlust: Jede Migration beginnt zu spät, wenn die Karte fehlt
Eine normale Veränderung wird zur Untersuchung: Welcher Export enthält den aktuellen Stand? Welche Automatisierung nutzt noch das alte Feld? Welche Person hat den API-Zugang erstellt? Welche Daten müssen vor einem Wechsel in ein Zielsystem übernommen werden? Ohne Karte starten Migrationen, Prüfungen und Incident-Analysen immer mit detektivischer Arbeit.
Der EU Data Act (Verordnung (EU) 2023/2854), der im Januar 2024 in Kraft trat und ab September 2025 stufenweise anzuwenden ist, macht Anbieterwechsel und Portabilität für Datenverarbeitungsdienste sichtbarer. Das hilft aber nur, wenn das Unternehmen selbst weiß, welche Daten, Metadaten, digitalen Assets und Abhängigkeiten geschäftlich relevant sind. Ein rechtlicher oder vertraglicher Exportanspruch ersetzt keine operative Vorbereitung.
Finanzielle Kosten: Bequemlichkeit wird zur wiederkehrenden Abhängigkeit
Schwache Datenlokalität erzeugt eine leise Komplexitätssteuer. Tools bleiben aktiv, weil niemand sicher weiß, was davon abhängt. Externe Dienstleister müssen zuerst rekonstruieren, bevor sie verbessern können. Teams bezahlen für doppelte Funktionen, weil kein System eindeutig als Quelle gilt. Automatisierungsprojekte verschieben sich, weil der Datenzustand nicht tragfähig ist.
Diese Kosten sind schwerer zu sehen als Lizenzgebühren. Genau deshalb bleiben sie lange bestehen. Ein Betrieb kann ein CRM, ein Projekttool, ein Dokumentensystem, mehrere Cloud-Speicher, ein paar n8n-Workflows und einen KI-Assistenten nutzen und trotzdem keine belastbare Antwort auf die Frage haben: Welches System ist für diesen Kundenvorgang autoritativ?
Vertrauensverlust: Kunden fühlen die Unklarheit
Kunden sehen keine Infrastruktur-Diagramme, aber sie spüren Inkonsistenz. Wenn der Support andere Informationen hat als der Vertrieb, die KI eine veraltete Leistungsbeschreibung nutzt oder eine Angebotsvorlage auf falschen Annahmen basiert, leidet das professionelle Bild. Operative Souveränität ist deshalb nicht nur ein internes Architekturthema. Sie ist die Grundlage dafür, dass Kommunikation verlässlich bleibt.
Bei personenbezogenen Daten kommt eine zweite Ebene hinzu: Dokumentation macht fachliche Prüfung erst möglich. Art. 30 DSGVO verpflichtet Verantwortliche und Auftragsverarbeiter zur Führung von Verarbeitungsverzeichnissen, die Kategorien, Zwecke, Empfänger, Übermittlungen, Maßnahmen und Aufbewahrungslogik abdecken. Für Unternehmen mit weniger als 250 Beschäftigten gilt eine Befreiung, sofern keine risikobehaftete, nicht nur gelegentliche Verarbeitung oder keine Daten besonderer Kategorien vorliegen. Dieser Artikel ersetzt keine Rechtsberatung. Er zeigt aber, warum eine saubere Datenlandkarte die Voraussetzung für sinnvolle Prüfung ist.
Das datenlokale Betriebsmodell
Ein belastbares Modell verbindet geschäftliche Relevanz mit technischer Kontrolle. Es stellt sicher, dass kritische Datensätze in den richtigen Zonen verarbeitet werden und jederzeit ein Ausstiegsschlüssel existiert. Der wichtigste Schritt ist nicht, alles in ein einziges System zu zwingen. Der wichtigste Schritt ist, die Schwerkraftzentren zu benennen und die Workflows bewusst um sie herum zu bauen.
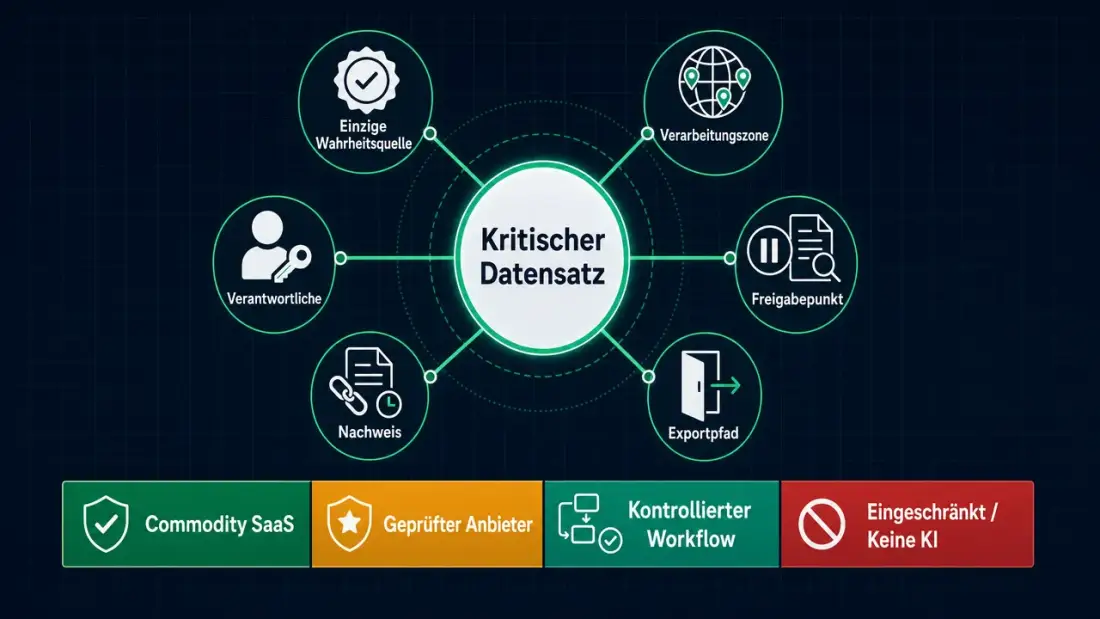
Die folgende Darstellung zeigt das Prinzip: Ein geschäftskritischer Datenkern wird nicht isoliert, sondern kontrolliert angebunden. Verarbeitungszonen, KI- und Automatisierungsschichten, menschliche Freigaben, Logs, Backups und Exportpfade bleiben sichtbar.
Die sieben Felder, die jeder kritische Workflow braucht
Ein praxistaugliches Modell beginnt mit wenigen Feldern. Sie sind bewusst einfacher als ein vollständiges Enterprise-Governance-Programm, aber präzise genug, um Entscheidungen zu treffen.
| Feld | Frage | Warum es zählt |
|---|---|---|
| Kritischer Datensatz | Welche Daten treiben den Workflow an? | Fokus auf das, was das Geschäft wirklich schützt. |
| Source of Truth | Welches System ist autoritativ? | Verhindert widersprüchliche Antworten und Dubletten. |
| Verarbeitungszone | Wo liegen Speicherung, Backup, KI und Administration? | Grundlage für Risikoanalyse, Anbieterprüfung und Wiederherstellung. |
| Owner | Wer verantwortet Änderungen, Freigaben und Exporte? | Klare Zuständigkeit bei Vorfällen oder Wechseln. |
| Freigabepunkt | Wo prüft ein Mensch kundensichtbare oder sensible Ergebnisse? | KI bleibt Unterstützung, nicht unkontrollierter Entscheider. |
| Exportpfad | Wie ziehen wir um, wenn der Anbieter wechselt? | Verhindert teuren Vendor Lock-in. |
| Evidence Trail | Welche Logs und Freigaben bleiben? | Macht KI-gestützte Aktionen nachvollziehbar. |
Klassifizierung der Zonen
Nicht alle Daten brauchen denselben Schutz. Ein Newsletter-Tool muss anders behandelt werden als ein Angebotsworkflow mit Kundendaten, Kapazitätsnotizen und Preislogik. Wir unterscheiden in der Praxis vier Zonen:
- Commodity SaaS: unkritische Tools mit klarem Export und begrenzter Sensibilität.
- Reviewed Provider: Kundendaten, bei denen Region, Unterauftragnehmer und Zugriffspfade geprüft werden.
- Controlled Workflow: eigene oder streng reglementierte Systeme für Kern-Know-how, Automatisierung und Entscheidungslogik.
- Restricted/No-AI: sensible Daten ohne explizite Freigabe für KI-Modelle oder externe Verarbeitung.
Die Einteilung ist keine juristische Freigabe. Sie ist eine Betriebsdisziplin. Sie verhindert, dass jedes neue Tool dieselbe Diskussion von vorne beginnt, und sie macht klar, welche Daten niemals nur durch Bequemlichkeit in den nächsten Assistenten kopiert werden.
Von verstreuten Daten zur digitalen Firmenzentrale
Ein klassisches Szenario: eine 14-köpfige Ingenieurberatung. Lukas, der Geschäftsführer, möchte KI-gestützte Anfragevorbereitung und schnellere Angebotserstellung einführen. Mira, die Operations-Leiterin, verwaltet die Projektabwicklung und pflegt den Projektstatus im Projekttool. Theo, der Account Manager, verantwortet CRM-Einträge und die gesamte Kundenkommunikation. Der Betrieb nutzt Website, gemeinsame Inbox, CRM, Angebotsdokumente, Projektordner, Buchhaltungsexporte, n8n-Automatisierung und einen KI-Assistenten.
Im alten Modell hält jedes Tool ein Fragment. Die Website kennt die Anfrage, die Inbox den Ton des Kunden, das CRM die Phase, alte Dokumente die Formulierungen, und der Automatisierungsworkflow verschiebt Daten, ohne dass der vollständige Zustand sichtbar ist.
Lukas möchte KI-gestützte Anfragevorbereitung einführen. Im ersten Demo funktioniert das, weil Mira Kontext aus vier Quellen manuell zusammenkopiert. Produktiv wäre das riskant: Theo kann nicht zuverlässig prüfen, welcher CRM-Eintrag aktuell ist. Datenpfade sind unklar, Quellen nicht bewertet, Freigaben improvisiert, Logs unvollständig. Die Lösung besteht nicht darin, alles sofort umzuziehen. Der erste Schritt ist ein einziger kontrollierter Workflow — mit Mira als benannter Verantwortlichen.
Vorher: Daten folgen der Tool-Bequemlichkeit
Vorher entstehen Entscheidungen aus Gewohnheit. Das CRM bleibt halb aktuell, weil die Inbox schneller ist. Theos Angebotsbausteine liegen in alten Dateien, weil sie dort leicht zu kopieren sind. Die KI, die Lukas testen will, bekommt Kontext per Copy-and-paste, weil es keine geprüfte Wissensquelle gibt. Backups existieren für einige Systeme, aber niemand hat die Wiederherstellungsreihenfolge für den gesamten Workflow getestet.
Dieser Zustand ist nicht ungewöhnlich. Er entsteht, wenn Unternehmen wachsen, aber ihre digitale Architektur nicht nachziehen. Die Werkzeuge arbeiten, aber die Firma besitzt keine gemeinsame Sicht auf den Ablauf.
Nachher: Datenlokalität folgt der Geschäftskritikalität
Nachher läuft die Anfrage in eine genehmigte Queue. Die Quelle ist sichtbar, Mira ist als Verantwortliche benannt, die Verarbeitungszone ist definiert, und die KI darf nur aus Quellen zusammenfassen, die Mira freigegeben hat. Kundensichtbare Antworten brauchen Theos Prüfung, bevor sie versandt werden. Logs halten Quelle, Automatisierungsschritt, Freigabe und Übergabe fest. Lukas kann Datenklassenänderungen sicher genehmigen, weil der Systemzustand lesbar ist. Exportpfade werden dokumentiert, bevor der Workflow geschäftskritisch wird.
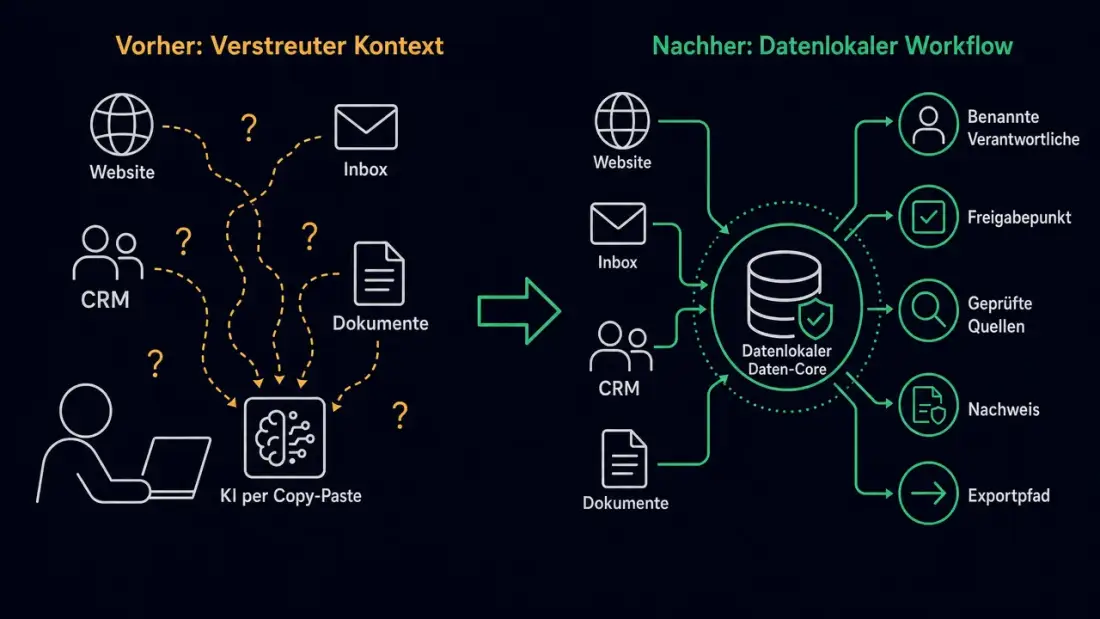
So entsteht eine digitale Firmenzentrale: kein monolithischer Datentresor, sondern ein geordnetes Betriebssystem. Wissen, Workflows, Systeme, Rollen, Logs und Eigentum werden so verbunden, dass Arbeit schneller wird, ohne die Kontrolle zu verlieren.
Der Weg mit Planfold: Plan -> Unfold -> Resonate
Planfold behandelt Datenlokalität nicht als isoliertes Compliance-Projekt. Für KMU, Mittelstand, Handwerk und Solo-Gründer muss der Weg praktisch bleiben: Sie wollen sich nicht dauerhaft um Infrastruktur kümmern, aber Sie müssen wissen, wo Ihre Unternehmensdaten leben, wer darauf zugreift und wie ein Wechsel möglich bleibt.
Plan: Die Schwerkraftzentren finden
Wir mappen Systeme, Datenklassen, Anbieter, Regionen, Besitzer, Exporte und Fehlerbilder. Dabei geht es nicht um eine endlose Dokumentation, sondern um Priorität: Welche Daten treiben Umsatz, Kundenvertrauen oder Betriebsfähigkeit? Wo reicht gemanagte Bequemlichkeit aus? Wo braucht Ihr Unternehmen stärkere Ownership?
In dieser Phase entsteht die erste Datenflusskarte. Sie beantwortet die Fragen, die sonst erst beim Vorfall gestellt werden: Welche Quelle ist verbindlich? Welche Rolle darf ändern? Wo liegen Backups? Welche Verarbeitung ist für KI freigegeben? Welche Daten dürfen nicht in einen externen Assistenten wandern?
Unfold: Den ersten kontrollierten Workflow bauen
Wir implementieren einen abgegrenzten Workflow, zum Beispiel eine KI-gestützte Anfrage-Vorbereitung. Daten kommen aus geprüften Quellen, Automatisierungen laufen über dokumentierte Pfade, und kundensichtbare Ergebnisse haben menschliche Freigaben. n8n, Git, APIs, Backups und Logs sind nicht Selbstzweck. Sie bilden die digitale Maschine, die den Prozess tragfähig macht.
Unfold heißt auch: nicht alles gleichzeitig umbauen. Ein sauberer Workflow mit Eigentümer, Freigabe, Log und Exportpfad schafft mehr Souveränität als zehn lose Tool-Optimierungen.
Resonate: Betrieb ohne Kontrollverlust
Sie arbeiten mit einem Sorglospaket, behalten aber den Ausstiegsschlüssel. Planfold betreut Betrieb, Wartung und Dokumentation so, dass die Architektur nachvollziehbar bleibt. Wenn Anbieter, Team, Risiko oder Geschäftsmodell sich ändern, beginnt die Firma nicht wieder bei null. Sie besitzt die Karte, die Logik und den Weg heraus.
Der praktische Startpunkt
Beginnen Sie nicht mit einer Plattformentscheidung. Beginnen Sie mit einem Workflow, der geschäftlich zählt: Anfrage, Angebot, Buchung, Rechnung, Supportfall, Projektübergabe oder automatisierte Nachfassung. Schreiben Sie auf, welcher Datensatz den Prozess antreibt, welche Quelle verbindlich ist, wo verarbeitet wird, wer freigibt und wie ein Export aussehen müsste.
Wenn Sie diese Fragen für Ihren wichtigsten Prozess nicht beantworten können, ist das kein persönliches Versäumnis. Es ist ein Hinweis darauf, dass Ihre digitale Maschine gewachsen ist, ohne dass die Betriebslandkarte mitgewachsen ist.
Eine einfache Diagnose für diese Woche
Nehmen Sie einen realen Kundenvorgang und folgen Sie ihm einmal vollständig: Eingang, Qualifizierung, Angebot, Freigabe, Speicherung, Übergabe und Nachweis. Notieren Sie für jeden Schritt System, Owner, Datenklasse, Automatisierung, Log und Exportpfad. Wo Sie raten müssen, liegt das nächste Risiko.
Die Übung dauert selten länger als eine Stunde. Sie zeigt aber, ob Datenlokalität in Ihrem Betrieb eine bewusste Entscheidung ist oder nur das Ergebnis historischer Tool-Auswahl.
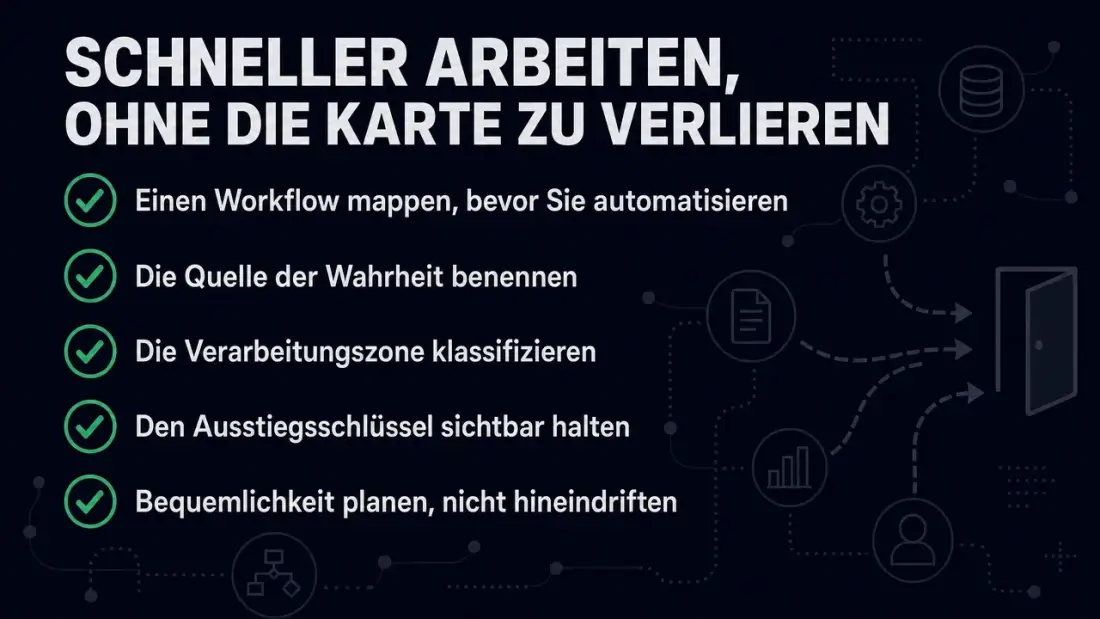
Das eigentliche Ergebnis: schneller arbeiten, ohne die Karte zu verlieren
Daten-Schwerkraft ist kein Grund, Innovation zu bremsen. Sie ist der Grund, Innovation sauber zu bauen. Wenn klar ist, welche Daten wohin gehören, welche Systeme autoritativ sind und welche Ausstiegspfade existieren, werden KI und Automatisierung belastbarer statt riskanter.
Für KMU ist das die praktische Bedeutung digitaler Souveränität: Sie bekommen ein Sorglospaket für Betrieb und Weiterentwicklung, ohne Ihre Unternehmenslogik an undurchsichtige Tool-Ketten zu verlieren. Bequemlichkeit bleibt erlaubt. Sie wird nur endlich geplant.
Hinweis: Dieser Artikel dient der Information und ersetzt keine Rechts- oder Datenschutzberatung. Eine fachliche Prüfung durch Ihren Datenschutzbeauftragten bleibt für spezifische Implementierungen notwendig.
Verwandte Artikel
Vom Migrations-Laufband herunter: Wie KMU die Kosten erzwungener Anbieter-Migrationen stoppen
Plattform-Eigentum für KMU: Ein Playbook vom gemieteten Silo zur eigenen, tragfähigen Infrastruktur