

Infrastrukturbetrieb in gemischten Linux- und Windows-Umgebungen standardisieren
Eine anonymisierte Umsetzungsgeschichte darüber, wie wiederkehrende Administration auf Linux und Windows mit GitLab, GitLab CI, Ansible und Semaphore unter kontrollierte Betriebsführung gebracht wurde.
Vertraulichkeitshinweis
Diese Seite bündelt zusammenhängende Umsetzungsarbeit aus einer früheren Anstellung. Konkrete Umgebungsdetails und organisatorische Hinweise wurden angepasst, um Vertraulichkeit zu wahren und dennoch Betriebsmodell, Governance-Entscheidungen und technische Form der Umsetzung korrekt zu zeigen.
Passende Service-Seiten
Operations / Souveränität
Was dadurch möglich wurde
- Einheitlichere Ausführung wiederkehrender Administration über Linux und Windows hinweg
- Klarere Review- und Audit-Spuren für Infrastrukturänderungen
- Weniger Drift und geringere Abhängigkeit von individuellem Betriebswissen
- Bessere Kontrolle über Ausführung, Zeitplanung und Wiederholbarkeit im Tagesbetrieb
Inhalt
- Kurzfassung
- Kundenkontext
- Das eigentliche Problem
- Warum GitLab zum Kontrollpunkt wurde
- Zielbild für den Betrieb
- Inventory- und Rollen-Governance
- GitLab CI als Quality Gate
- Rolle von Semaphore
- AWX oder Tower als optionale Erweiterung
- Linux- und Windows-Realität
- Umsetzungsweg
- Ergebnis
- Was dieser Artikel nicht ist
- CTA
Verlässlicher Infrastrukturbetrieb beginnt mit Governance, nicht mit mehr Skripten
Die Umgebung umfasste wiederkehrende Administrationsarbeit auf Linux- und Windows-Systemen. Updates, Konfigurationsänderungen, Patch-Aufgaben und Softwarepflege wurden zu oft manuell und uneinheitlich ausgeführt. Gesucht war daher nicht zuerst ein Plattformwechsel, sondern ein kontrolliertes Betriebsmodell für genau diese Routinearbeit.
Kurzfassung
Diese Umsetzung hatte ein sehr praktisches Ziel: wiederkehrende Infrastrukturarbeit kontrollierter, reviewbarer und weniger abhängig von individuellen Betriebsgewohnheiten zu machen.
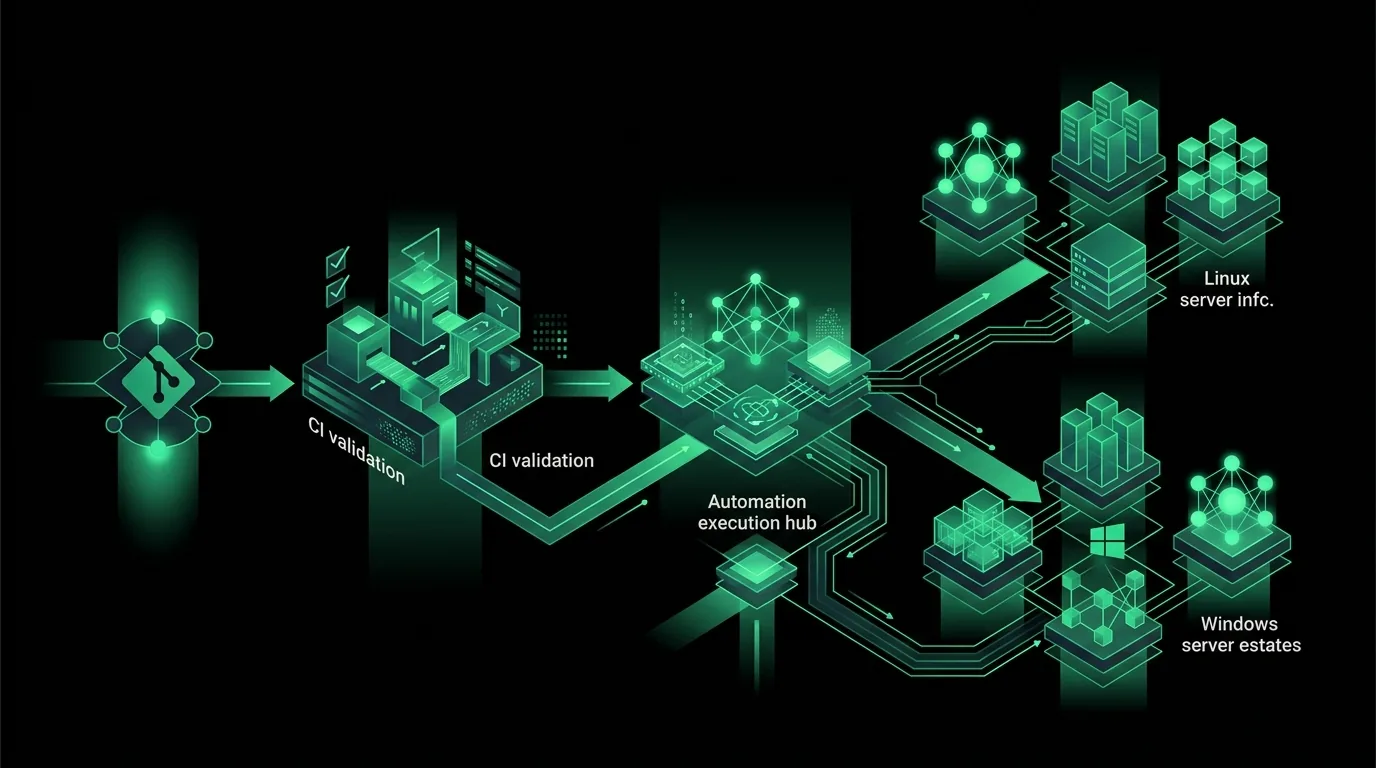
GitLab hielt die maßgeblichen Definitionen für Inventories, Rollen und operative Änderungen. GitLab CI prüfte Struktur und Qualität, bevor Jobs überhaupt ausgeführt wurden. Ansible beschrieb die wiederkehrende Arbeit als reviewte Automatisierung. Semaphore stellte die bedienbare UI für kontrollierte Ausführung und Zeitplanung bereit. Genau diese Kombination schuf ein belastbares Betriebsmodell über Linux und Windows hinweg, ohne so zu tun, als seien beide Welten identisch.
Kundenkontext
Solche Arbeit entsteht in Organisationen, in denen die Infrastruktur bereits wichtig genug für Disziplin ist, das Betriebsmodell aber noch nicht entsprechend gereift ist.
Die Umgebung umfasst Linux- und Windows-Systeme. Wiederkehrende Aufgaben wie Patchen, Basis-Konfigurationen, Paketverwaltung und korrigierende Administration fallen laufend an. Die einzelnen Tätigkeiten sind normal. Problematisch wird, dass sie zu oft aus Erinnerung, aus Ticket-Kommentaren oder aus lokal gewachsenen Gewohnheiten heraus ausgeführt werden.
Nach außen wirkt die Umgebung damit oft beherrschbar, unter der Oberfläche bleibt sie jedoch fragil.
Das eigentliche Problem
Das eigentliche Problem war nicht das Fehlen einzelner Automatisierungs-Skripte. Es war das Fehlen eines geregelten Modells für wiederkehrende Infrastrukturarbeit.
Wenn Inventories inkonsistent sind, Variablen unsauber geschnitten werden und Ausführung außerhalb eines reviewbaren Pfads stattfindet, helfen selbst gute Playbooks nur begrenzt. Drift kehrt schnell zurück. Audit-Nachweise bleiben schwach. Die Umgebung hängt weiter an Personen, die ihre Ausnahmen aus dem Kopf kennen.
Deshalb wurde diese Arbeit als Governance- und Lieferqualitätsproblem behandelt und nicht als "einfach Ansible einführen".
Warum GitLab zum Kontrollpunkt wurde
GitLab wurde zum sinnvollen Zentrum, weil es nicht nur um Ausführung ging, sondern um Änderungsabsicht, Review, Historie und Kontrolle.
Inventories, Rollenstruktur und Playbooks gehören in Git. Merge Requests schaffen einen sichtbaren Review-Pfad. Freigaben schaffen Verantwortlichkeit. Commit-Historien ersetzen undokumentierte lokale Varianten. GitLab CI kann fehlerhafte Inventory-Strukturen oder unsaubere Automatisierung ablehnen, bevor überhaupt Zielsysteme berührt werden.
Das war wichtiger als eine UI allein. Eine UI ist für Operatoren hilfreich. Sie darf nur nicht der Ort werden, an dem Infrastruktur-Wahrheit unbemerkt von der Versionsverwaltung abweicht.
Zielbild für den Betrieb
Das Zielbild war bewusst klar gehalten.
GitLab fungierte als Quelle der Wahrheit für Inventories und operative Definitionen. GitLab CI setzte Quality Gates. Ansible beschrieb wiederkehrende Administration als reviewte Automatisierung. Semaphore war die kontrollierte Ausführungsschicht für geplante Läufe und operator-seitig gestartete Aufgaben.
Diese Aufgabentrennung hielt das Modell sauber:
- GitLab verantwortet die Änderungsabsicht.
- GitLab CI validiert Struktur vor der Ausführung.
- Ansible beschreibt wiederholbare Betriebsabläufe.
- Semaphore übernimmt Ausführung und Zeitplanung.
Inventory- und Rollen-Governance
Die Qualität des Inventorys war genauso wichtig wie die Qualität der Playbooks.
In gemischten Umgebungen entstehen viele Fehler lange bevor die Automatisierungs-Engine das eigentliche Problem ist. Gruppierung, Variablen-Grenzen, Namenskonventionen und Zuständigkeiten müssen so klar sein, dass Operatoren nachvollziehen können, was eine Änderung konkret trifft und warum.
Darum behandelte diese Umsetzung Inventories und Rollenstruktur als erstklassige, geregelte Assets. Es ging nicht darum, Host-Daten um ihrer selbst willen in Git zu legen. Es ging darum, Infrastruktur-Absicht langfristig reviewbar und wartbar zu machen.
GitLab CI als Quality Gate
GitLab CI brachte Disziplin vor der Ausführung.
Pipelines wurden genutzt, um Inventory-Struktur zu prüfen, Automatisierung zu linten und sicherzustellen, dass operative Definitionen den vereinbarten Konventionen folgen. Welche Prüfungen konkret sinnvoll sind, variiert je nach Umgebung. Das Prinzip bleibt gleich: Die Ausführung darf nicht der erste Moment sein, in dem Probleme auffallen.
Genau hier wird das Betriebsmodell deutlich stärker als manuelle Administration, die nur durch Tickets oder Kommentare begleitet wird. Merge Requests plus CI liefern bessere Nachweise, bessere Review-Qualität und weniger unbeabsichtigte Varianten.
Rolle von Semaphore
Semaphore war die praktische UI-Schicht für den Tagesbetrieb.
Das war wichtig, weil reviewte Automatisierung trotzdem eine bedienbare Ausführungsoberfläche braucht. Operatoren brauchen einen Ort für kontrollierte Starts, wiederkehrende Zeitpläne, parametrisierte Jobs und sichtbare Laufhistorie, ohne wieder in ad hoc Shell-Zugriffe oder private Notizen zurückzufallen.
Semaphore passte dafür sehr gut. Es stellte eine kontrollierte Ausführungsoberfläche bereit und ließ GitLab trotzdem die autoritative Quelle bleiben. Anders gesagt: Operatoren konnten eine sinnvolle UI nutzen, ohne dass sich Entscheidungen über den Soll-Zustand in die UI verlagerten.
AWX oder Tower als optionale Erweiterung
Für Teams, die eine schwerere Enterprise-Steuerung benötigen, können AWX oder Ansible Tower eine sinnvolle optionale Ergänzung sein.
Architektonisch ändert das aber nichts am Kern. Stärkere Workflow-Steuerung, RBAC oder umfangreichere Freigabestrukturen können in manchen Organisationen dafür sprechen, sind jedoch nicht erforderlich, um das Grundmodell belastbar zu machen.
Linux- und Windows-Realität
Gerade hier zeigt sich, warum diese Arbeit operative Erfahrung braucht: Linux und Windows werden nicht identisch, nur weil Ansible beide ansprechen kann.
Zugriffsmuster unterscheiden sich. SSH und WinRM verhalten sich unterschiedlich. Rechte-Modelle unterscheiden sich. Patch-Logik unterscheidet sich. Modulverhalten unterscheidet sich. Ein gutes Betriebsmodell akzeptiert diese Unterschiede und erzwingt dennoch einen gemeinsamen Governance- und Review-Pfad.
Der praktische Wert liegt genau darin: ein kontrolliertes Modell über gemischte Umgebungen hinweg, ohne echte Plattformunterschiede in künstliche Symmetrie zu pressen.
Umsetzungsweg
Der Rollout war bewusst pragmatisch.
Zuerst wurden Inventory-Struktur und Rollen-Grenzen bereinigt. Darauf aufbauend wurden wiederkehrende Aufgaben als reviewte Automatisierung beschrieben. Anschließend kamen CI-Gates hinzu, damit strukturelle Probleme früh auffallen. Semaphore wurde danach als Ausführungsschicht für Operatoren und Zeitpläne angebunden, um improvisierte manuelle Pfade weiter zurückzudrängen.
Das Ergebnis war nicht "volle Automatisierung". Das Ergebnis war begrenzte Varianz, bessere Wiederholbarkeit und klarere operative Verantwortlichkeit.
Ergebnis
Das Ergebnis war ein verlässlicheres Betriebsmodell für Infrastrukturarbeit.
Routineänderungen ließen sich konsistenter ausführen. Drift wurde reduziert, weil Inventories und Automatisierungsdefinitionen einem geregelten Review-Pfad folgten. Betriebswissen hing weniger an individueller Erinnerung. Ausführung ließ sich besser planen und nachvollziehen, ohne dass die UI-Schicht zur Quelle der Wahrheit wurde.
Genau darin liegt der Beleg: nicht darin, dass jede Aufgabe automatisch wurde, sondern darin, dass wiederkehrende Infrastrukturarbeit kontrollierter und weniger personenabhängig wurde.
Was dieser Artikel nicht ist
Dieser Artikel handelt nicht von Kubernetes-Auslieferung, Helm-basiertem Release-Management oder Cluster-GitOps.
Er handelt von der Standardisierung wiederkehrender Linux- und Windows-Operationen mit Git-gesteuerten Inventories, reviewter Automatisierung und einer kontrollierten Ausführungsschicht.
CTA
Wenn Ihre Infrastruktur heute davon abhängt, dass erfahrene Menschen wiederkehrende Änderungen aus dem Kopf sicher ausführen, ist PLANFOLDs Operations-Service genau dafür da, diese Arbeit in ein disziplinierteres Betriebsmodell zu überführen.
Implementierungsdetails
- GitLab als Quelle der Wahrheit für Inventories, Playbooks und Rollenstruktur
- GitLab-CI-Prüfungen für Inventory-Qualität, Struktur und Automatisierungs-Hygiene
- Ansible-Automatisierung für Linux- und Windows-Administration
- Semaphore für kontrollierte Ausführung, Zeitplanung und bedienbare Operator-Workflows
Warum das Vertrauen schaffen sollte
- Die Umsetzung ist auf Governance und Betriebsqualität zentriert und nicht auf Tools um ihrer selbst willen
- Sie zeigt reale gemischte Betriebsumgebungen statt einer idealisierten Greenfield-Situation
- Sie trennt Quellverwaltung, Validierung, Secret-Handling und Ausführungsverantwortung sauber voneinander
Warum das geschäftlich relevant ist
Das ist relevant für Organisationen, die nicht zuerst eine neue Plattform brauchen, sondern einen disziplinierteren Umgang mit wiederkehrender Infrastrukturarbeit. Genau dafür ist PLANFOLD aufgebaut: weniger improvisierte Administration, mehr Reviewbarkeit und ein Betrieb, der weniger auf stillschweigenden Gewohnheiten beruht.
Weiterführend
Verwandte Projektbeispiele

Kontrollierte Kubernetes-Delivery über Entwicklung, Staging und Produktion
Eine anonymisierte Umsetzungsgeschichte darüber, wie mit GitLab CI, Nexus3, Helm, Kustomize und ArgoCD ein diszipliniertes Kubernetes-Delivery-Modell aufgebaut wurde, betrieben auf Rancher-verwalteten RKE2- und K3s-Clustern auf vSphere.
Kommerzieller Kontext
Käufer, die Kubernetes-Delivery-Modernisierung, GitOps-Betriebsmodelle oder gestufte Release-Kontrolle auf selbst verwalteter Infrastruktur bewerten
Vertrauenssignal
Zeigt praktische Erfahrung beim Entwurf kontrollierter Kubernetes-Delivery mit Artefakt-Governance, gestufter Promotion und pragmatischem Cluster-Betrieb

Weniger manuelle Arbeit durch pragmatische interne Automatisierung
Eine anonymisierte Umsetzungsgeschichte darüber, wie wiederkehrende operative Routinen durch strukturierte Workflows zwischen Ticketing, Monitoring, Onboarding, Identity, Passworterneuerung und Business-Datenübergabe entlastet wurden.
Kommerzieller Kontext
Käufer, die Workflow-Automatisierung für operative Reibung in internen Prozessen statt für öffentliche Marketing-Szenarien bewerten
Vertrauenssignal
Zeigt praktische Erfahrung darin, fragmentierte interne Routinen in eine verlässlichere Prozessschicht zu überführen