

Kontrollierte Kubernetes-Delivery über Entwicklung, Staging und Produktion
Eine anonymisierte Umsetzungsgeschichte darüber, wie mit GitLab CI, Nexus3, Helm, Kustomize und ArgoCD ein diszipliniertes Kubernetes-Delivery-Modell aufgebaut wurde, betrieben auf Rancher-verwalteten RKE2- und K3s-Clustern auf vSphere.
Vertraulichkeitshinweis
Diese Seite basiert auf realer Umsetzungsarbeit aus einem Arbeitgeberkontext. Identifikatoren, Umgebungsdetails und Anwendungsinformationen wurden angepasst, um Vertraulichkeit zu wahren und das Architektur- und Betriebsmodell dennoch korrekt darzustellen.
Passende Service-Seiten
Operations / Souveränität
Was dadurch möglich wurde
- Klarere Promotionskontrolle über Entwicklung, Staging und Produktion hinweg
- Sauberere Trennung zwischen Build, Registry und Deployment-Verantwortung
- Bessere Nachvollziehbarkeit von Commit bis Artefakt und Cluster-Sync
- Nutzbarerer Cluster-Betrieb durch Rancher und eine konsistente Monitoring-Basis
Inhalt
- Kurzfassung
- Kundenkontext
- Warum das eine Delivery-Geschichte ist
- Zielbild für den Betrieb
- Multi-Stage-Delivery über Entwicklung, Staging und Produktion
- Verantwortlichkeiten von GitLab CI
- Nexus3 als Artefakt-Hub
- Helm als bevorzugtes Paketierungsmodell
- Wo Kustomize passte
- ArgoCD als Deployment-Ebene
- Repo-Strategie
- Rancher-, RKE2-, K3s- und vSphere-Kontext
- Ergebnis
- Tradeoffs und Leitplanken
- Was dieser Artikel nicht ist
- CTA
Die Hauptaufgabe war nicht, Kubernetes zu installieren. Die Hauptaufgabe war, Anwendungs-Delivery steuerbar zu machen.
Die Umgebung brauchte ein Delivery-Modell, das freigegebene Anwendungsversionen über Entwicklung, Staging und Produktion hinweg promoten konnte, ohne Build-, Registry- und Deployment-Verantwortung zu vermischen. Rancher-verwaltete RKE2- und K3s-Cluster auf vSphere bildeten die Laufzeitbasis, doch die eigentliche Umsetzungsarbeit war der kontrollierte Weg von Commit zu Laufzeitzustand.
Kurzfassung
Die relevante Verbesserung war nicht einfach, dass Workloads auf Kubernetes liefen. Die relevante Verbesserung war, dass Delivery vom Commit bis zum Cluster kontrollierbar wurde.
GitLab hielt Source, Review-Fluss und CI-Policy. GitLab CI baute Container, führte Tests aus, validierte Charts und veröffentlichte unveränderliche Artefakte. Nexus3 hielt diese Images und Helm-Charts als maßgebliche Registry. ArgoCD glich anschließend den freigegebenen Deployment-Zustand über Entwicklung, Staging und Produktion hinweg in Kubernetes ab.
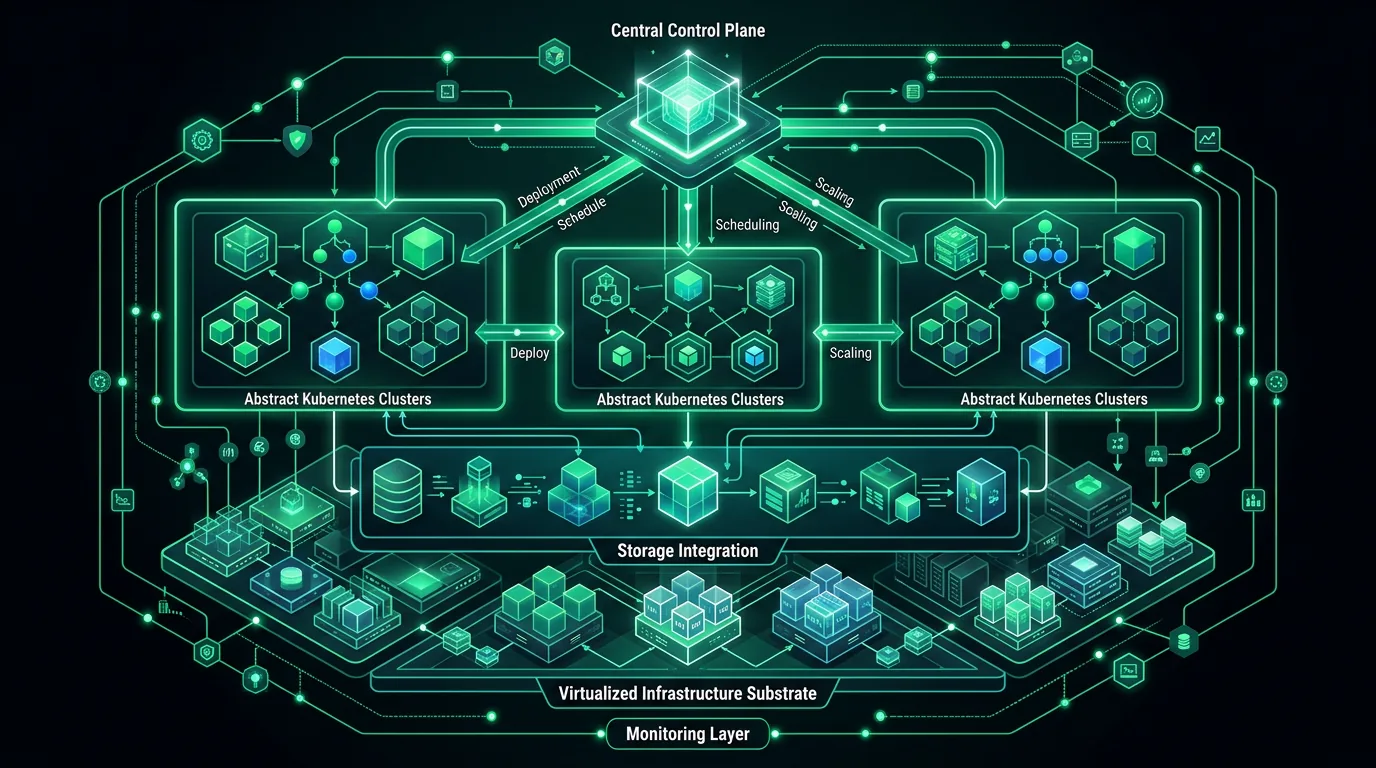
Auch die Cluster-Seite war wichtig, aber als Betriebsrealität und nicht als Überschrift. Rancher Cluster Manager stellte die grafische Management-Ebene bereit, machte den Umgang mit Clustern zugänglicher und vereinfachte die Bereitstellung eines Monitoring-Stacks. RKE2 und K3s waren je nach Umfeld sinnvolle Kubernetes-Distributionen. Die vSphere-Integration deckte sowohl Cluster-Provisionierung als auch CSI-gestützten Storage ab, damit die Plattform zur vorhandenen Infrastruktur passte statt eine Cloud-Welt zu unterstellen.
Kundenkontext
Diese Art von Arbeit entsteht, wenn Anwendungs-Delivery über eine kleine Zahl manuell verstandener Services hinausgewachsen ist.
Frühere Container-Delivery-Muster funktionieren oft eine Zeit lang gut. Das Problem beginnt, wenn mehr Services, mehr Umgebungen und mehr Release-Druck aus diesen Gewohnheiten ein Betriebsrisiko machen. Entwicklung, Staging und Produktion existieren dann vielleicht bereits, verhalten sich aber noch nicht wie disziplinierte Promotionsstufen. Artefakte werden zu oft neu gebaut. Deployment-Logik ist verteilt. Vertrauen in Rollbacks bleibt schwach, weil nicht immer klar ist, welche Artefakt-Version tatsächlich in welcher Umgebung gelandet ist.
Genau das war hier das eigentliche Problemfeld. Gesucht war kein modischerer Runtime-Stack. Gesucht war Release-Kontrolle.
Warum das eine Delivery-Geschichte ist
Dieser Artikel handelt von Software-Delivery-Architektur, nicht von Linux- und Windows-Standardisierung und nicht von Ansible-geführtem Host-Betrieb.
Die zentrale Designfrage lautete, wie sich Build, Artefakt-Verantwortung, Deployment-Absicht und Laufzeit-Abgleich so trennen lassen, dass Anwendungsänderungen nachvollziehbar und kontrolliert durch mehrere Umgebungen laufen können. Kubernetes war das Laufzeitziel. Es war nicht die ganze Geschichte.
Zielbild für den Betrieb
Das Betriebsmodell beruhte auf einer klaren Verantwortungskette.
GitLab war maßgeblich für Source, Merge-Kontrolle, Tags und CI-Logik.
GitLab CI baute Container, führte Tests aus, lintete oder renderte Charts dort, wo es sinnvoll war, und veröffentlichte freigegebene Ergebnisse.
Nexus3 wurde zum Artefakt-Hub für OCI-Images und Helm-Charts. Das war wichtig, weil Build-Ergebnisse eine dauerhafte verantwortliche Ablage außerhalb der Pipeline brauchten, die sie erzeugt hatte. Als Nebeneffekt unterstützt dieselbe Plattform auch breitere Artefakt-Governance, etwa für npm- oder NuGet-Pakete.
ArgoCD übernahm Pull-basiertes Deployment und den Abgleich. Das hielt die Trennung zwischen CI und Cluster-Zugriff sauber und machte Drift und Sync-Status leichter sichtbar.
Helm war das bevorzugte Paketierungsmodell für First-Party-Anwendungen.
Kustomize wurde gezielter für kleinere strukturelle Änderungen, Namespace-übergreifende Anpassungen oder Cluster-Service-Anpassungen eingesetzt, wenn Overlays sauberer waren als zusätzliche Komplexität in Helm-Values.
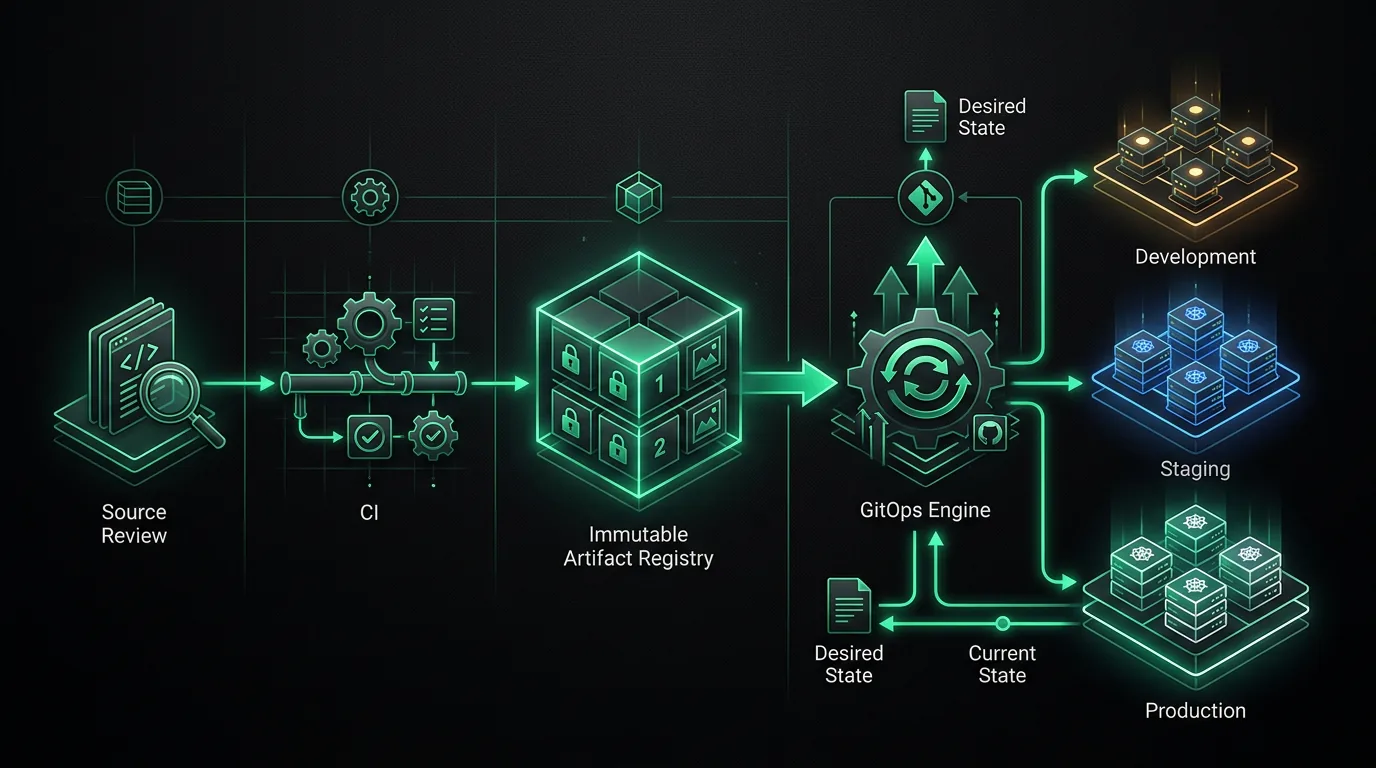
Multi-Stage-Delivery über Entwicklung, Staging und Produktion
Das Stufenmodell wurde als Kontrollsystem behandelt, nicht als Namensdekoration.
Entwicklung diente schnellem Integrationsfeedback. Staging diente dazu, einen Release-Kandidaten in einem produktionsnäheren Pfad zu prüfen. Produktion war ein bewusster Promotionspunkt und nicht der Ort, an dem plötzlich andere Build-Logik galt.
Diese Trennung funktioniert nur, wenn das Artefakt über alle Stufen stabil bleibt. Das Betriebsprinzip war daher einfach: einmal bauen, einmal testen, unveränderliche Artefakte veröffentlichen und anschließend bewusst promoten.
Das verbesserte die Nachvollziehbarkeit. Ein Release ließ sich vom Commit zur Pipeline, von der Pipeline zur Image- oder Chart-Version in Nexus3 und von der freigegebenen Version bis zur ArgoCD-Sync-Revision in der Zielumgebung verfolgen.
Verantwortlichkeiten von GitLab CI
GitLab CI trug die Engineering-Prüfungen, die vor dem Deployment stattfinden mussten.
Dazu gehörten Container-Builds, Anwendungstests, Chart-Validierung, Release-Tagging und Artefakt-Veröffentlichung. Der Punkt war nicht, aus CI einen Cluster-Administrator zu machen. Der Punkt war sicherzustellen, dass die Ergebnisse, die in die Registry gelangen, die erwarteten Quality Gates bereits bestanden haben.
Diese Verantwortlichkeiten in GitLab zu halten, machte Review und Change Control zusätzlich leichter steuerbar, weil Merge Requests, Pipeline-Logik und Release-Mechanik im selben auditierbaren System lagen.
Nexus3 als Artefakt-Hub
Nexus3 war wichtig, weil Artefakte ein echtes System of Record brauchten.
Container-Images und Helm-Charts wurden dort versioniert und abgelegt. Das machte Rollback- und Promotionslogik deutlich leichter nachvollziehbar als pipeline-lokale Ergebnisse oder pro Umgebung neu gebaute Artefakte. Ein Neuaufbau je Environment hätte die Auditierbarkeit geschwächt und es erschwert nachzuweisen, dass Staging und Produktion wirklich denselben Release-Kandidaten gesehen haben.
Diese Trennung hielt auch die Verantwortlichkeiten sauber. GitLab steuerte Source und CI. Nexus3 steuerte die Artefakt-Verantwortung. ArgoCD steuerte den Deployment-Abgleich.
Helm als bevorzugtes Paketierungsmodell
Helm war die Standardwahl für Anwendungspaketierung, weil Anwendungs-Deployments von versionierter Release-Semantik profitieren.
Charts erleichterten es, First-Party-Workloads wiederverwendbar zu paketieren, Deployment-Eingaben explizit zu halten und bekannte Versionen zwischen Umgebungen zu promoten. Das war besonders hilfreich, sobald mehr als eine Anwendung oder mehr als ein Service durch dasselbe gestufte Delivery-Modell laufen musste.
Wo Kustomize passte
Kustomize wurde nicht als zweiter Standard für alles verwendet.
Es war dort sinnvoll, wo ein kleines Overlay klarer war als zusätzliche Logik in Helm-Values, besonders bei Namespace-übergreifenden Anpassungen, ausgewählten Cluster-Services oder kleinen strukturellen Unterschieden zwischen Umgebungen. Diese Zurückhaltung war wichtig. Zu viel Logik in Helm-Values wird schwer nachvollziehbar, aber zu viele Kustomize-Overlays werden schwer sicher zu promoten.
ArgoCD als Deployment-Ebene
ArgoCD lieferte das Pull-basierte Deployment-Modell.
Dadurch wurde der Blast Radius von CI reduziert, weil Pipelines nicht für jeden Deployment-Schritt weitreichende direkte Cluster-Credentials brauchten. Gleichzeitig verbesserte sich die operative Sichtbarkeit durch Sync-Status, Historie und Drift-Erkennung.
Genauso wichtig war, dass ArgoCD eine andere Verantwortung ausdrückte als die Registry. Nexus3 speicherte freigegebene Artefakte. Git drückte freigegebenen Zielzustand aus. ArgoCD sorgte dafür, dass sich der Cluster diesem Zustand annäherte.
Repo-Strategie
Auch der Repo-Aufbau folgte derselben Trennung der Verantwortlichkeiten.
Der Anwendungscode lag im jeweiligen Anwendungs-Repository. Helm-Chart-Quellen konnten im selben Repository bleiben, wenn sie eng an die Anwendung gekoppelt waren. Ein separates Chart-Repository ergab erst dann Sinn, wenn Charts einen eigenen Lebenszyklus oder breitere Wiederverwendung hatten. Das GitOps-Repository diente wiederum einem anderen Zweck: Es drückte aus, welche freigegebene Version in Entwicklung, Staging oder Produktion für ArgoCD gelten sollte.
Diese Unterscheidung ist in der Praxis wichtig, weil ein Chart-Repository und ein GitOps-Repository unterschiedliche Governance-Probleme lösen.
Rancher-, RKE2-, K3s- und vSphere-Kontext
Die Runtime-Ebene war dennoch relevant, weil Delivery-Disziplin zur realen Betriebswelt passen muss.
RKE2 und K3s waren in dieser Arbeit relevante Kubernetes-Distributionen, gewählt nach Umweltanforderungen und operativen Randbedingungen. Rancher Cluster Manager ergänzte eine grafische Management-Oberfläche, die den Umgang mit Clustern zugänglicher machte, besonders für Teams, die Sichtbarkeit brauchten, ohne den ganzen Tag in Kubernetes-Interna zu arbeiten.
Rancher erleichterte außerdem den Aufbau einer Monitoring-Basis. Ein Monitoring-Stack ließ sich über die Management-Ebene konsistenter bereitstellen, statt auf jedem Cluster erst im Nachhinein ergänzt zu werden.
Auch vSphere war Teil des praktischen Betriebsrahmens. Dazu gehörten die Integration für Cluster-Provisionierung und vSphere CSI für Persistent Storage. Genau solche Details entscheiden darüber, ob eine Plattform nur installiert oder im Alltag wirklich nutzbar ist.
Ergebnis
Das Resultat war eine steuerbarere Release-Kette.
Die Promotion über Entwicklung, Staging und Produktion wurde klarer. Rollback-Logik wurde vertrauenswürdiger, weil freigegebene Artefakte versioniert und nachvollziehbar waren. Build-, Registry- und Abgleichsverantwortung verschwammen nicht länger ineinander. Durch Rancher wurde außerdem der Cluster-Betrieb zugänglicher, was für die Akzeptanz über einen kleinen Spezialistenkreis hinaus wichtig war.
Der Wert lag nicht darin, dass der Stack moderner klang. Der Wert lag darin, dass Anwendungs-Delivery besser kontrollierbar wurde.
Tradeoffs und Leitplanken
Auch dieses Modell braucht Disziplin.
Artefakte pro Environment neu zu bauen, ist ein Anti-Pattern, wenn Auditierbarkeit zählt. Zu viel Variation in Helm-Values macht Releases schwerer nachvollziehbar. Kustomize überall einzusetzen, erzeugt Overlay-Sprawl. Repositories zu aggressiv aufzuteilen, kann ebenfalls Governance-Aufwand schaffen, ohne genug Nutzen zu bringen.
Die Architektur funktioniert am besten, wenn jeder Teil bei seiner Aufgabe bleibt: GitLab für Source und CI-Policy, Nexus3 für Artefakt-Verantwortung, Git für freigegebene Environment-Absicht, ArgoCD für den Abgleich und Rancher für den praktischen Cluster-Betrieb.
Was dieser Artikel nicht ist
Dieser Artikel handelt nicht von Linux- und Windows-Host-Standardisierung. Er ist auch nicht die Ansible- und Semaphore-Geschichte. Ebenso ist er kein generischer Leitfaden zur Cluster-Installation.
Der Punkt ist die Delivery-Kette: einmal bauen, unveränderliche Artefakte ablegen, bewusst promoten und freigegebenen Zustand so in Kubernetes abgleichen, dass Teams ihn im Alltag tatsächlich betreiben können.
CTA
Wenn Ihre Organisation einen kontrollierteren Weg von Code nach Kubernetes braucht, ist PLANFOLDs Arbeit an Souveränität und Modernisierung genau für diese Art von Delivery-Architektur gedacht.
Implementierungsdetails
- GitLab CI für Container-Builds, Tests, Chart-Validierung und Release-Veröffentlichung
- Nexus3 für OCI-Images und Helm-Charts, mit Potenzial für breitere Artefakt-Governance etwa für npm und NuGet
- ArgoCD für Pull-basiertes Deployment und Abgleich über Entwicklung, Staging und Produktion hinweg
- Helm für First-Party-Anwendungspaketierung und Kustomize für kleinere Cluster- oder Namespace-übergreifende Anpassungen
- Rancher Cluster Manager als grafische Management-Oberfläche und für die einfache Bereitstellung eines Monitoring-Stacks
- RKE2- und K3s-Cluster auf vSphere einschließlich vSphere-basierter Provisionierung und CSI-gestützter Storage-Integration
Warum das Vertrauen schaffen sollte
- Die Architektur trennt Source Control, Artefakt-Verantwortung und Deployment-Abgleich sauber
- Die Geschichte zeigt, wie GitOps durch unveränderliche Artefakte und Promotionsdisziplin praktisch wird
- Sie spiegelt die reale Betriebswelt von Rancher-verwaltetem Kubernetes auf vSphere wider statt nur eine generische Cluster-Installation
Warum das geschäftlich relevant ist
Das ist die Art von Modernisierungsarbeit, die PLANFOLD unterstützt, wenn Container-Delivery mehr braucht als einen weiteren Cluster. Der Wert liegt in einer kontrollierten Release-Kette: Source und CI in GitLab, Artefakt-Verantwortung in Nexus3, Pull-basiertes Deployment mit ArgoCD und ein Cluster-Betrieb, der im Alltag nutzbar bleibt.
Weiterführend
Verwandte Projektbeispiele

Infrastrukturbetrieb in gemischten Linux- und Windows-Umgebungen standardisieren
Eine anonymisierte Umsetzungsgeschichte darüber, wie wiederkehrende Administration auf Linux und Windows mit GitLab, GitLab CI, Ansible und Semaphore unter kontrollierte Betriebsführung gebracht wurde.
Kommerzieller Kontext
Käufer, die bewerten, wie man manuelle Systemadministration reduziert und den Betrieb gemischter Linux- und Windows-Infrastruktur standardisiert
Vertrauenssignal
Zeigt praktische Erfahrung darin, wiederkehrende Infrastrukturarbeit in ein Git-gesteuertes, weniger personenabhängiges Betriebsmodell zu überführen

Weniger manuelle Arbeit durch pragmatische interne Automatisierung
Eine anonymisierte Umsetzungsgeschichte darüber, wie wiederkehrende operative Routinen durch strukturierte Workflows zwischen Ticketing, Monitoring, Onboarding, Identity, Passworterneuerung und Business-Datenübergabe entlastet wurden.
Kommerzieller Kontext
Käufer, die Workflow-Automatisierung für operative Reibung in internen Prozessen statt für öffentliche Marketing-Szenarien bewerten
Vertrauenssignal
Zeigt praktische Erfahrung darin, fragmentierte interne Routinen in eine verlässlichere Prozessschicht zu überführen