Souveräne Infrastruktur im Rückblick: Was KMU nach der Migration wirklich lernen
Eine souveräne Infrastruktur-Migration endet nicht mit dem Umzug. Dieser Leitfaden zeigt, wie KMU Kostenform, Datenstandort, Recovery, Betrieb und Exit-Key nach 30 Tagen ehrlich prüfen.
Inhalt
Eine souveräne Infrastruktur-Migration endet nicht mit dem Umzug. Dieser Leitfaden zeigt, wie KMU Kostenform, Datenstandort, Recovery, Betrieb und Exit-Key nach 30 Tagen ehrlich prüfen.
Artikel teilen
Der Monat nach der Migration
Eva öffnet nicht die alte Hyperscaler-Rechnung. Genau das war vor sechs Monaten noch das Symbol des Problems. Das illustrativa DACH-Unternehmen, ein Industriedienstleister mit 58 Mitarbeitenden, hat ihr Kundenportal, den Dokumentenaustausch und einen internen Automatisierungsrunner aus einer gewachsenen Cloud-Miete in eine stärker kontrollierte DACH-gehostete Betriebsumgebung verschoben. Jonas, der technische Teilzeit-Owner, zeigt im Review Git-Merge-Requests, Kubernetes-Manifeste, Backup-Protokolle und die ersten Monitoring-Signale. Lena aus Finance bringt die Kapazitätsauswertung mit. Markus aus Operations will wissen, ob der Portalbetrieb für Kunden wirklich stabiler geworden ist.
Dieser Moment fühlt sich anders an als ein Migrationskickoff. Vor dem Umzug waren die Fragen leicht zu formulieren: Warum steigen die Kosten? Wo liegen die Daten? Wie abhängig sind wir vom Anbieter? Nach dem Umzug werden die Fragen präziser und unangenehmer. Welche Kapazität ist überdimensioniert? Welcher Restore-Test beweist, dass das Portal nicht nur läuft, sondern wieder aufgebaut werden kann? Wer besitzt die Credentials? Welche Workflows wurden wirklich entkoppelt? Welche Abhängigkeiten sind geblieben, weil ein Umzug mehr Risiko als Kontrolle gebracht hätte?
Die Marktlage macht diese Fragen dringlicher. dpa berichtete über den Bitkom Cloud Report 2026, dass viele deutsche Unternehmen ihre Abhängigkeit von US-Cloud-Anbietern kritisch sehen, zugleich aber weiter auf deren Angebote angewiesen bleiben und europäische Alternativen nicht in jedem Fall als gleichwertig wahrnehmen (WELT/dpa, 2026). Das ist keine Aufforderung zur pauschalen Cloud-Flucht. Es ist ein Signal, dass Souveränität nicht als Provider-Etikett verstanden werden darf. Sie muss sich im Betrieb zeigen.
Eine souveräne Infrastruktur-Migration ist deshalb nicht abgeschlossen, wenn DNS umgestellt und Daten kopiert sind. Sie ist erst belastbar, wenn das Unternehmen nach 30 Tagen erklären kann, was sich an Kostenform, Datenstandort, Wiederherstellung, Verantwortlichkeit und Verhandlungsmacht tatsächlich verbessert hat. Genau dafür braucht es eine Retrospektive.
Warum der Cloud-Ausstieg nicht mit dem Umzug endet
Der häufigste Denkfehler lautet: "Wir sind umgezogen, also sind wir souverän." Der Umzug verändert aber nur die Ausgangslage. Er ersetzt keine Architekturentscheidungen, keine Runbooks, keine Zugangspolitik, keine Kostenreviews und keine getesteten Wiederherstellungspfade. Ein Unternehmen kann den Hyperscaler verlassen und trotzdem eine neue Black Box bauen, wenn Betrieb, Dokumentation und Verantwortlichkeiten nicht mitziehen.
Die Flexera 2026 State of the Cloud ordnet dieses Problem breiter ein: Cloud-Landschaften sind häufig hybrid, Kostenverschwendung bleibt ein Thema, und viele Organisationen landen in komplexen Multi- oder Hybrid-Umgebungen eher durch gewachsene Realität als durch bewusstes Design. Für ein KMU heißt das: Kostenkontrolle entsteht nicht automatisch durch "weg von Cloud" oder "hin zu selbst gehostet". Sie entsteht durch Workload-Auswahl, Messung, Kapazitätsplanung und klare Ownership.
Kostenform: von variabler Rechnung zu geplantem Betrieb
Nach einer Migration verschwindet die alte variable Rechnung oft nicht einfach. Sie ändert ihre Form. Aus nutzungsabhängiger Cloud-Miete werden geplante Serverkapazität, Backup-Speicher, Monitoring, Supportzeit, Wartungsfenster, Betriebspartner und interne Verantwortung. Das kann besser steuerbar sein. Es kann aber auch nur anders intransparent werden, wenn niemand prüft, ob CPU, RAM, Storage, Netzwerk und Retention zur tatsächlichen Last passen.
Für diesen DACH-Industriedienstleister ist die erste Lehre deshalb kaufmännisch und technisch zugleich. Lena vergleicht nicht nur "Cloud vorher" gegen "DACH-Betrieb nachher". Sie prüft Forecast gegen reale Nutzung, Backup-Wachstum gegen Aufbewahrungsziel und Supportaufwand gegen Störungsprotokoll. Jonas ergänzt, welche Reserven bewusst gewählt wurden und welche nur aus Vorsicht zu groß sind. Erst dann wird aus dem Umzug eine Kostenentscheidung.
Datenort: Residenz ist kein Betriebsmodell
DACH-Hosting kann eine wichtige Antwort sein, wenn Kunden nach Datenstandort, Zugriffswegen oder Anbieterabhängigkeit fragen. Aber Datenort allein beantwortet nicht, wer lesen darf, wie Exporte funktionieren, welche Metadaten im Workflow bleiben, wie Backups geprüft werden und wie ein Anbieterwechsel dokumentiert ist. Der Standort schafft eine bessere Ausgangsposition. Das Betriebsmodell entscheidet, ob diese Position belastbar bleibt.
Auch der EU Data Act verstärkt die Erwartung, dass Wechsel zwischen Datenverarbeitungsdiensten technisch und vertraglich weniger blockiert werden. Der Rechtsrahmen ersetzt aber nicht Ihre Feldlisten, Credentials, Provider-spezifischen APIs, Runbooks und Restore-Tests. Dieser Artikel ist Architektur- und Marketinginformation, keine Rechtsberatung. Die praktische Lehre bleibt: Ein Recht auf Wechsel hilft erst, wenn die eigene Infrastruktur wechselbar gebaut und geübt ist.
Verantwortung: Wer besitzt den nächsten Vorfall?
Vor der Migration war der Anbieter oft der bequeme Schuldige. Nach der Migration ist die Verantwortung näher am Unternehmen. Das ist der Sinn von Souveränität, aber auch ihre Härte. Wenn das Portal nachts ausfällt, muss Markus wissen, welcher Prozess startet. Jonas muss Logs, Deployments und Rollback-Pfade sehen. Eva muss entscheiden können, ob ein Kundenkommunikationsfenster geöffnet wird. Lena muss verstehen, ob ein Notfall zusätzliche Kapazität, externen Support oder einen vertraglichen Eskalationsweg auslöst.
Souveränität bedeutet also nicht "alles selbst machen". Sie bedeutet, dass Verantwortung sichtbar und vertraglich, technisch und organisatorisch verteilt ist. Ein Full-Service-Partner kann Betrieb übernehmen. Ein DACH-Provider kann Hosting liefern. Planfold kann Architektur, Kubernetes-Betrieb, n8n-Workflows, GitOps und Dokumentation bauen. Aber das Unternehmen braucht trotzdem einen benannten Owner, einen Nachweisweg und einen Exit-Key.
Was im Rückblick gut funktionierte
Eine gute Retrospektive sucht nicht nur Fehler. Sie hält fest, welche Entscheidungen den Umzug erst sinnvoll gemacht haben. Bei diesem DACH-Industriedienstleister war nicht der komplette Stack Kandidat für die neue Betriebsumgebung. Das Kundenportal, der Dokumentenaustausch und der Automatisierungsrunner waren nah an Kundenvertrauen, Datenstandort, Betriebskontinuität und Integrationslogik. Andere Systeme blieben bewusst managed, weil ein Umzug dort nur zusätzliche Betriebsarbeit erzeugt hätte.
Diese Selektivität ist wichtig. Ein KMU ohne dediziertes Plattformteam gewinnt nichts, wenn es Commodity-Tools aus Prinzip selbst betreibt. Die bessere Frage lautet: Welcher Workload ist strategisch, datenrelevant, kostenkritisch oder abhängigkeitskritisch genug, dass mehr Besitz den zusätzlichen Betrieb rechtfertigt? Genau dort beginnt souveräne Infrastruktur.
Workload-Auswahl vor Ideologie
Dieser DACH-Industriedienstleister hat zuerst die Workloads ausgewählt, bei denen Betriebskontrolle einen klaren Zweck hatte. Das Kundenportal verarbeitet etwa 260 aktive Portalnutzer pro Monat. Der Dokumentenaustausch hält in diesem illustrativen Szenario 620 GB Projektdokumente. Der CRM-Connector und neun tägliche n8n-Workflow-Läufe bewegen Informationen zwischen Service, Finance und Operations. Diese Zahlen sind keine Kundendaten und kein Benchmark. Sie zeigen nur die Größenordnung, bei der ein Mittelstandsworkflow schon kritisch genug wird, um nicht mehr in Admin-Screenshots und persönlichem Wissen zu verschwinden.
Gleichzeitig blieb ein Teil der SaaS-Landschaft dort, wo er sinnvoll ist. Ein E-Mail-Dienst, ein Buchhaltungssystem oder eine spezialisierte Fachanwendung muss nicht automatisch ausziehen. Der Fortschritt liegt nicht darin, jede externe Abhängigkeit zu entfernen. Er liegt darin, jede wichtige Abhängigkeit bewusst zu benennen, ihren Ausstiegspfad zu kennen und ihren Wert gegen das Betriebsrisiko zu stellen.
Git, IaC und Container als Wiederaufbaupfad
Was im Rückblick am stärksten half, war nicht ein einzelnes Tool. Es war die Wiederholbarkeit. Infrastrukturdefinitionen lagen in Git. Änderungen liefen über Merge Requests. Kubernetes-Manifeste, Helm- oder Kustomize-Konfigurationen und CI/CD-Pfade machten sichtbar, welcher Zustand gewollt war. Backups und Restore-Notizen wurden nicht als Projektabschlussordner behandelt, sondern als Teil des Betriebs.
Die Kubernetes-Dokumentation beschreibt Kubernetes als portable, erweiterbare Open-Source-Plattform für containerisierte Workloads mit deklarativer Konfiguration und Automatisierung. Das ist für geeignete Workloads wertvoll. Es ist aber kein vollständiges PaaS, keine Datenbank, keine Monitoring-Strategie und kein automatischer Lock-in-Ausweg. Der Nutzen entsteht erst, wenn Container, Daten, Secrets, Netzwerke, Logs und Delivery-Pfade zusammen betrieben werden.
DACH-Betrieb dort, wo Daten und Kundenvertrauen zählen
DACH-Betrieb half diesem DACH-Industriedienstleister nicht als Slogan, sondern als Gesprächsgrundlage. Eva konnte Kunden klarer erklären, wo relevante Betriebsdaten liegen, wer Zugriff hat und wie der Nachweis geführt wird. Markus konnte Support- und Eskalationspfade enger mit dem tatsächlichen Betrieb verbinden. Jonas konnte eine Zielumgebung betreiben, die nicht nur über Provider-Konsolen, sondern über Git, Runbooks und Monitoring nachvollziehbar war.
Die Lehre ist nüchtern: Datenstandort ist ein Baustein. Er wirkt erst zusammen mit Zugriffskontrolle, Wiederherstellung, Protokollen, Exportpfaden, Vertragsprüfung und Betriebssignalen. Wer DACH-Hosting ohne diese Schicht einkauft, hat möglicherweise den Standort verbessert, aber noch kein souveränes Betriebsmodell.
Was weh tat: versteckte Migrationskosten
Die schmerzhaftesten Kosten der Migration standen nicht alle auf der Anbieterrechnung. Einige zeigten sich als Parallelbetrieb. Einige als Testaufwand. Einige als fehlende Dokumentation. Einige als Entscheidungsmüdigkeit, weil niemand vor dem Umzug sauber sagen konnte, welche Integrationen wirklich produktiv waren.
Dieser DACH-Industriedienstleister musste 14 externe Integrationen prüfen. Drei davon waren fachlich kritisch, aber technisch schlechter dokumentiert als erwartet. Zwei Workflows enthielten Ausnahmen, die nur Markus aus Operations kannte. Ein Servicekonto war noch auf einen früheren Dienstleister zurückzuführen. Solche Details wirken klein, bis sie den Migrationskalender bestimmen.
Egress, Synchronisierung und Parallelbetrieb
Daten bewegen sich selten nur einmal. Für das Portal mussten Dokumente kopiert, Prüfsummen kontrolliert, Datenbankstände synchronisiert, Suchindizes neu aufgebaut und Benutzerberechtigungen verglichen werden. Währenddessen lief der alte Stack weiter, weil Kunden nicht auf eine saubere Architekturzeichnung warten. Parallelbetrieb ist kein Nebengeräusch. Er ist ein Kostenblock.
Die bessere Planung behandelt Egress, Synchronisierung und Parallelbetrieb als eigene Kategorien. Nicht jede Zahl lässt sich vorher exakt kennen. Aber jede Kategorie sollte bewusst im Plan stehen, damit Finance nicht erst nach der Migration versteht, warum der alte Anbieter noch mehrere Wochen Kosten erzeugt.
Unklare Abhängigkeiten in alten Workflows
Der zweite Schmerz saß in Workflows. Ein n8n-Flow war gut exportierbar, aber seine Credentials, Umgebungsvariablen und Fehlerpfade waren nicht vollständig beschrieben. Ein CRM-Connector nutzte Felder, die Operations anders verstand als Finance. Eine Kundenbenachrichtigung hing an einem Webhook, dessen Retry-Verhalten nie getestet wurde.
Das sind keine Argumente gegen Automatisierung. Sie sind Argumente für Betriebsdisziplin. Jeder kritische Workflow braucht Owner, Testdaten, Fehlerpfad, Review-Gate und Logspur. Sonst wird die Migration zum Archäologieprojekt.
Runbooks, die erst im Incident entstehen
Der dritte Schmerz war organisatorisch. Einige Runbooks entstanden erst, als etwas hakte. Das ist menschlich, aber teuer. Ein Runbook, das im Vorfall geschrieben wird, konkurriert mit Kundendruck, Müdigkeit und Zeitverlust. Ein gutes Migrationsprogramm schreibt die ersten Runbooks vor dem Umzug, ergänzt sie während des Parallelbetriebs und prüft sie im ersten echten Restore- oder Rollback-Test.
Der Lerneffekt ist unbequem: Souveränität erhöht anfangs die Sichtbarkeit von Arbeit, die vorher vom Anbieter verdeckt oder von einzelnen Personen getragen wurde. Das ist kein Scheitern. Es ist der Moment, in dem Betrieb endlich ehrlich wird.
Das Retrospektiv-Modell für KMU
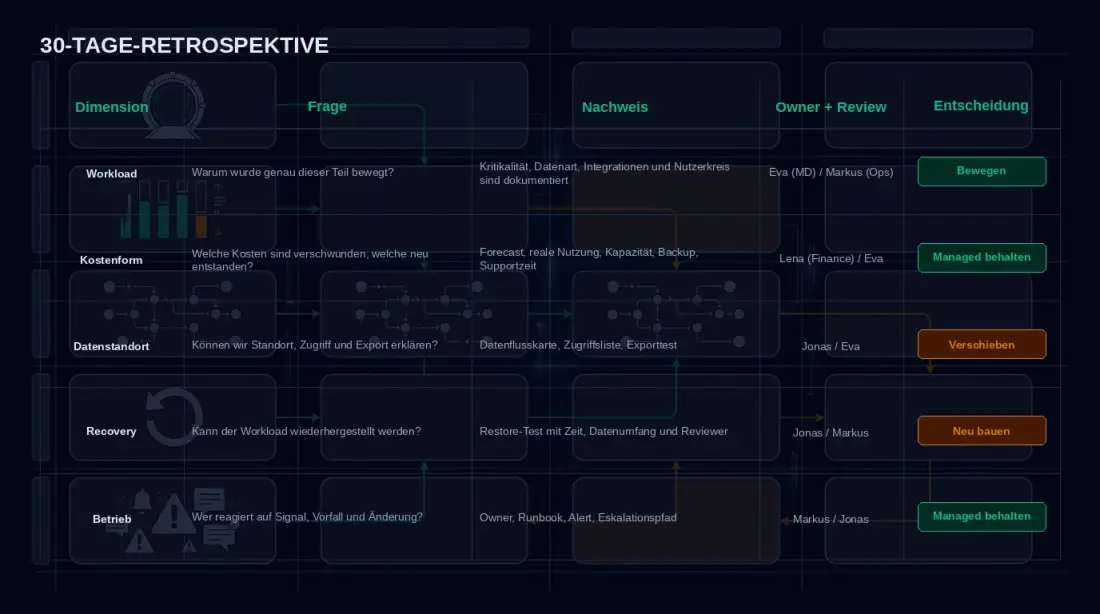
Eine 30-Tage-Retrospektive sollte kurz genug sein, um wirklich stattzufinden, und konkret genug, um Entscheidungen zu verändern. Für KMU mit 10 bis 100 Mitarbeitenden reicht ein Modell mit fünf Fragen: Welcher Workload wurde bewegt? Wie hat sich die Kostenform verändert? Was wissen wir jetzt über Datenstandort und Zugriff? Welcher Recovery-Nachweis existiert? Wer besitzt den Betrieb?
Die Antwort muss nicht immer "mehr Souveränität" lauten. Manchmal ist die beste Entscheidung, einen Workload managed zu behalten. Manchmal sollte ein Workload bewegt werden, weil Kosten, Daten oder Kundenanforderungen dafür sprechen. Manchmal muss er neu gebaut werden, weil der alte Stack zu stark an proprietäre Dienste gebunden ist. Manchmal sollte er verschoben werden, weil die Abhängigkeiten noch nicht verstanden sind.
| Dimension | Retrospektive Frage | Gute Evidenz | Mögliche Entscheidung |
|---|---|---|---|
| Workload | Warum wurde genau dieser Teil bewegt? | Kritikalität, Datenart, Integrationen und Nutzerkreis sind dokumentiert | behalten, bewegen, neu bauen oder verschieben |
| Kostenform | Welche Kosten sind verschwunden, welche neu entstanden? | Forecast, reale Nutzung, Kapazität, Backup, Supportzeit | Kapazität anpassen oder Betriebsmodell ändern |
| Datenstandort | Können wir Standort, Zugriff und Export erklären? | Datenflusskarte, Zugriffsliste, Exporttest | Datenmodell klären oder Anbieterpfad prüfen |
| Recovery | Kann der Workload wiederhergestellt werden? | Restore-Test mit Zeit, Datenumfang und Reviewer | RTO/RPO anpassen oder Runbook verbessern |
| Betrieb | Wer reagiert auf Signal, Vorfall und Änderung? | Owner, Runbook, Alert, Eskalationspfad | Owner benennen oder Workload nicht weiter migrieren |
Dieses Modell verhindert zwei Extreme. Es verhindert die naive Erfolgsmeldung "alles läuft". Und es verhindert die technische Endlosschleife, in der immer noch ein Diagramm, ein Tool oder ein Cluster fehlt. Die Retrospektive fragt nach entscheidbarer Evidenz.
Ein realistisches Szenario: Portal, Dateien, Automatisierung
Dieser DACH-Industriedienstleister ist ein illustratives Szenario, kein Planfold-Kundenfall. Genau deshalb eignet es sich für eine nüchterne Prüfung. Die Firma betreibt in diesem Modell ein Kundenportal, einen Dokumentenaustausch, einen CRM-Connector und Operations-Automatisierung. Es gibt 620 GB Projektdokumente, 120 GB PostgreSQL-Daten, 2 TB Backup-Retention, 32 Container über fünf Services, 14 externe Integrationen, neun n8n-Workflow-Läufe pro Tag, 260 Portalnutzer pro Monat und drei Release-Fenster pro Monat. Alle Zahlen sind bewusst als realistische Modellwerte formuliert, nicht als zugesagte Ergebnisse.
Die Rollen sind genauso wichtig wie die Technik. Eva besitzt Kundenzusagen, Verträge und Budgetentscheidungen. Markus besitzt Serviceabläufe, Übergabequalität und Kontinuitätserwartungen. Jonas besitzt Manifeste, CI/CD, Backups, Zugriff, Logs und Restore-Nachweise, aber nur als Teilzeit-Owner. Lena besitzt Kostenallokation, Kapazitätsreviews und Verlängerungsentscheidungen. Ohne diese Rollen wäre die Migration nur ein technisches Projekt.
Vorher: schnelle Cloud, unklare Besitzgrenzen
Vor der Migration war der Stack schnell gewachsen. Das Portal lief zuverlässig genug, aber niemand konnte in einem Review vollständig erklären, welche Integrationen beim Ausfall zuerst betroffen wären. Dokumente lagen in mehreren Speichern. Der CRM-Connector funktionierte, aber Feldbedeutungen und Fehlerpfade waren nicht vollständig dokumentiert. Ein externer Dienstleister kannte Teile der Deployment-Geschichte besser als das interne Team.
Der wichtigste Befund war nicht, dass die alte Cloud schlecht war. Der wichtigste Befund war, dass dieser DACH-Industriedienstleister seine Betriebsgrenzen nicht ausreichend kannte. Das Unternehmen hatte Geschwindigkeit gekauft und dabei einen Teil des Eigentumsnachweises verwässert.
Nachher: portable Laufzeit, Backup-Test, Review-Rhythmus
Nach der Migration ist nicht alles perfekt. Aber die offenen Fragen sind sichtbar. Die Container laufen auf einer portableren Laufzeitschicht. Git zeigt den gewünschten Zustand. Ein Restore-Test dokumentiert Datenumfang, Zeitpunkt, Reviewer und Abweichungen. n8n-Workflows haben Owner, Fehlerpfade und menschliche Freigaben dort, wo Kundenauswirkung oder Vertragsdaten berührt werden. Lena prüft monatlich Forecast, reale Nutzung und Reserven. Eva entscheidet nicht mehr aus Bauchgefühl, ob der nächste Workload migriert wird.
Die Retrospektive endet mit vier Entscheidungen. Das Portal bleibt in der neuen Umgebung und bekommt einen verbesserten Restore-Zeitplan. Ein Reporting-Workload bleibt managed, weil die Migrationskosten den Nutzen übersteigen. Ein alter CRM-Connector wird neu gebaut, weil seine Abhängigkeiten zu unklar sind. Ein Archiv-Workload wird verschoben, bis Datenklassifizierung und Retention sauberer sind. Das ist souveräne Infrastruktur im Alltag: nicht alles bewegen, sondern besser entscheiden.
Wie Planfold souveräne Infrastruktur betreibbar macht
Planfold behandelt souveräne Infrastruktur nicht als Anti-Cloud-These. Die operative Frage lautet: Welche digitale Maschine soll Ihr Unternehmen besitzen, welche Entlastung kaufen Sie bewusst ein, und welcher Exit-Key bleibt in Ihrer Hand? Daraus entsteht ein Sorglospaket mit Eigentumsnachweis: Betrieb, Wartung und Hosting können entlasten, aber Code, Datenflüsse, Dokumentation, Credentials, Runbooks und Review-Spuren bleiben nachvollziehbar.
Plan bedeutet: technische Schuld, Workload-Kritikalität, Datenflüsse, Anbieterabhängigkeiten, Verträge, Credentials, Recovery-Erwartungen und Kostentreiber auditieren. Das Ergebnis ist keine abstrakte Cloud-Strategie, sondern eine priorisierte Karte: Was bleibt managed, was wird bewegt, was wird neu gebaut und was wird verschoben?
Unfold bedeutet: die passende Betriebsschicht bauen. Für manche Workloads sind das APIs, Dokumentation und Exporttests. Für andere sind es Kubernetes-Operations, GitOps, Infrastructure as Code, CI/CD, DACH-Hosting-Optionen, Backup/Restore-Routinen, Observability und n8n-Workflows mit menschlichen Review-Gates. CKA, CKAD und LFCS sind dabei Fähigkeitssignale für Kubernetes-, Cloud-Native- und Linux-Betrieb, keine Compliance-Abzeichen.
Resonate bedeutet: die Infrastruktur mit Signalen betreiben. Release Notes, Incident Reviews, Restore-Tests, Kostenreviews, Kapazitätsentscheidungen, Runbook-Änderungen und Owner-Handoffs halten den Exit-Key aktuell. Ein einmaliger Umzug altert. Ein gepflegtes Betriebsmodell bleibt entscheidungsfähig.
Planfolds Infrastruktur- und Kubernetes-Proofs sind dafür Fähigkeitshinweise, keine Versprechen identischer Kundenergebnisse. Die Arbeit bleibt konkret: Git als Quelle der Wahrheit, CI/CD als nachvollziehbarer Lieferpfad, Kubernetes dort, wo Laufzeitportabilität den Aufwand rechtfertigt, und n8n dort, wo Operations-Workflows sichtbar, reviewbar und mit Fehlerpfaden betrieben werden müssen.
Die 30-Tage-Retrospektive nach jeder Migration
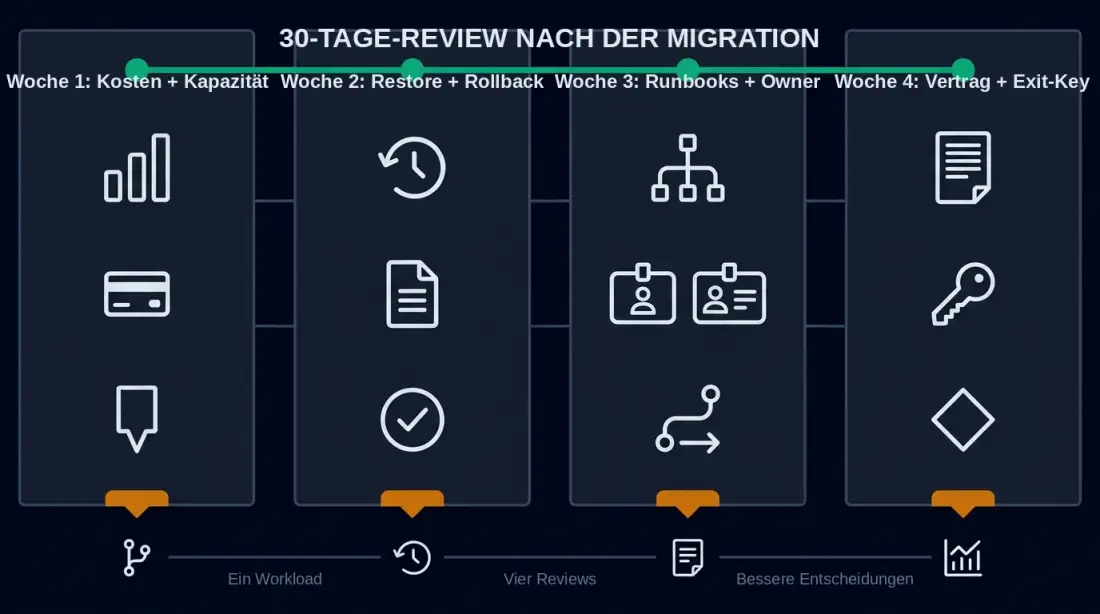
Der praktischste Startpunkt ist kein weiterer großer Architekturworkshop. Es ist ein 30-Tage-Rhythmus nach jeder Migrationswelle. Klein genug für ein Mittelstandsteam, konkret genug für Management und Technik, wiederholbar genug für den nächsten Workload.
Woche 1: Kosten- und Kapazitätsreview. Vergleichen Sie Forecast, tatsächliche Nutzung, Reserven, Backup-Wachstum, Monitoring-Kosten und Supportaufwand. Markieren Sie bewusst gewählte Reserven anders als unklare Überdimensionierung.
Woche 2: Restore- und Rollback-Test. Prüfen Sie einen echten Wiederherstellungspfad. Dokumentieren Sie Zeitpunkt, Datenumfang, beteiligte Personen, Abweichungen und offene Lücken. Wenn RTO oder RPO nur Wunschwerte sind, schreiben Sie das ehrlich auf und bauen Sie den nächsten Test enger.
Woche 3: Runbooks und Owner prüfen. Jedes kritische Signal braucht einen Owner, ein Runbook, einen Eskalationspfad und eine Review-Spur. Wenn der Betrieb nur funktioniert, weil Jonas sich erinnert, ist der Exit-Key nicht in der Organisation angekommen.
Woche 4: Vertrag, Exit-Key und nächster Workload. Prüfen Sie Kündigungsfristen, Exportpfade, Credential-Besitz, Anbieterabhängigkeiten und den nächsten Entscheidungspunkt. Entscheiden Sie danach nicht ideologisch, sondern pro Workload: managed behalten, bewegen, neu bauen oder verschieben.
Das Ergebnis dieser Retrospektive ist keine perfekte Plattform. Es ist bessere Entscheidungsfähigkeit. Sie sehen, welche Kontrolle wirklich gewonnen wurde, welche Arbeit neu sichtbar wurde und welche Abhängigkeit bewusst bleibt.
Planen. Entfalten. Souverän bleiben.