Wiederholbare Systeme statt Schneeflocken: Infrastructure as Code für den Mittelstand
Wenn Server-Konfiguration in einem Kopf lebt, ist das kein Betrieb — das ist ein Risiko. Was Infrastructure as Code für KMU bedeutet, wie ein pragmatischer Einstieg aussieht und warum Wiederholbarkeit die Grundlage von Souveränität ist.
Inhalt
Wenn Server-Konfiguration in einem Kopf lebt, ist das kein Betrieb — das ist ein Risiko. Was Infrastructure as Code für KMU bedeutet, wie ein pragmatischer Einstieg aussieht und warum Wiederholbarkeit die Grundlage von Souveränität ist.
Artikel teilen
Der Dienstag, an dem niemand den Server kannte
Bei einem mittelständischen Logistikdienstleister aus der DACH-Region läuft der Betrieb seit acht Jahren auf denselben virtuellen Servern. 38 Mitarbeitende, regionale Speditionssoftware, 12 virtuelle Maschinen verteilt auf zwei Cloud-Provider. Geschäftsführer Markus trägt die IT-Entscheidung, hat aber kein eigenes DevOps-Team. Klaus Hartmann, der Systemadministrator, betreut alle Server und arbeitet vier Tage pro Woche. Sarah Lenz, eine externe Entwicklerin, deployt neue Softwareversionen — und ist dabei vollständig auf Klaus angewiesen.
An einem Dienstag im Juli kommt eine kritische Sicherheitsmeldung für die verwendete Datenbank. Der Patch erfordert einen Neustart der Staging-Umgebung, um die Kompatibilität mit der Produktion zu testen. Klaus ist im Urlaub. Markus fragt Sarah, ob sie die Staging-Umgebung neu aufsetzen kann. Sarah loggt sich ein, findet vier Server, die alle "irgendwie gleich" aussehen sollten, aber keiner hat eine aktuelle Dokumentation. Die nginx-Konfiguration auf Staging weicht von der Produktion ab — ein manueller Tweak aus dem letzten Herbst, den nur Klaus kannte. Die Firewall-Regeln sind nicht versioniert. Die SSL-Zertifikatskette wurde damals per Hand zusammengeklickt.
Nach drei Tagen Reverse-Engineering ist die Staging-Umgebung halbherzig wiederhergestellt. Ein Kundendemo wurde verschoben. Das Team hat vier Personentage in manuelles Trial-and-Error investiert — und niemand ist sicher, ob die Umgebung wirklich identisch zur Produktion ist.
Dieser Dienstag ist kein Einzelfall. Er ist die logische Konsequenz einer Infrastruktur, die nicht dokumentiert, nicht versioniert und nicht reproduzierbar ist. Für KMU mit 10 bis 100 Mitarbeitenden und ohne dediziertes Plattform-Team ist das der Normalzustand — und er wird teurer, je länger er besteht.
Was Infrastructure as Code wirklich bedeutet — und was nicht
Infrastructure as Code klingt nach Enterprise-Jargon. In Konferenzvorträgen geht es oft um Terraform-Provider, Kubernetes-Operatoren und GitOps-Pipelines in globalem Maßstab. Für einen Mittelständler mit einem halben Systemadministrator klingt das abstrakt und unerreichbar.
Das ist ein Kategoriefehler. Infrastructure as Code ist kein Enterprise-Luxus. Es ist die technische Umsetzung einer Betriebsgrundlage, die jede Organisation braucht, die auf Servern arbeitet: Die Fähigkeit, die gesamte Umgebung aus einer definierten, versionierten Quelle neu aufzubauen.
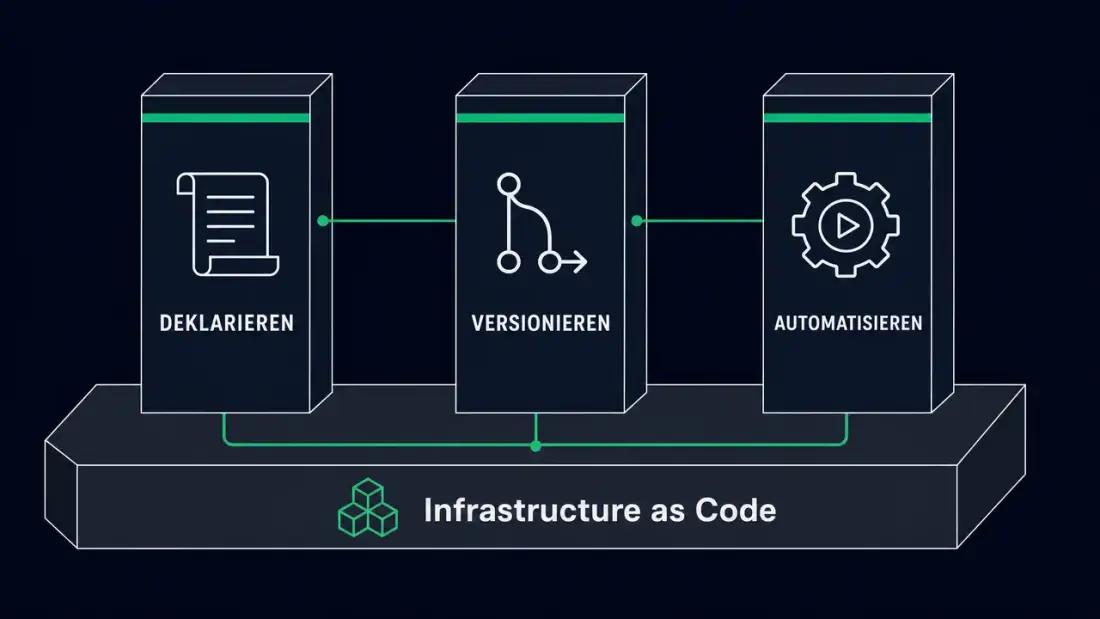
Diese Fähigkeit ruht auf drei Säulen:
Deklarieren. Statt einen Server Schritt für Schritt manuell zu konfigurieren, beschreiben Sie den gewünschten Zustand in einer Datei: welche Pakete installiert sind, welche Dienste laufen, welche Ports offen sind, welche Benutzer existieren. Das Ziel ist nicht ein Skript, das "irgendwie funktioniert". Das Ziel ist eine Beschreibung, die sagt: "So soll dieser Server aussehen."
Versionieren. Diese Beschreibung lebt in Git. Jede Änderung ist ein Commit. Jeder Commit hat einen Autor, einen Zeitstempel und einen Review-Prozess. Wenn etwas schiefgeht, können Sie den vorherigen Zustand wiederherstellen — nicht aus einer Backup-Festplatte, sondern aus einer bekannten, getesteten Code-Revision.
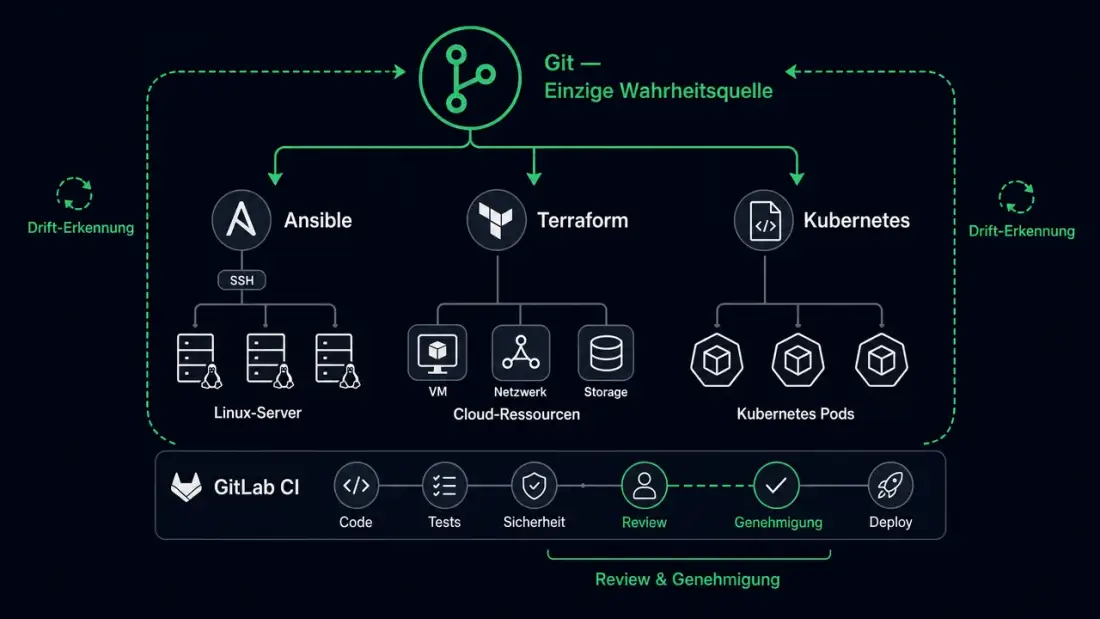
Automatisieren. Ein Automatisierungstool wendet die deklarierte Konfiguration an. Ansible für Betriebssystem- und Service-Konfiguration. Terraform oder Kubernetes-Manifeste für Cloud-Ressourcen und Container. GitLab CI als Ausführungs- und Review-Schicht. Der entscheidende Unterschied zum manuellen Klicken: Das Tool stellt sicher, dass der tatsächliche Zustand dem deklarierten Zustand entspricht — und meldet Abweichungen.
Die MarketsandMarkets-Analyse zum IaC-Markt zeigt, dass der globale IaC-Markt von 0,8 Milliarden USD im Jahr 2022 auf 2,3 Milliarden USD bis 2027 wachsen soll — und das SME-Segment dabei schneller wächst als große Unternehmen. Precedence Research aktualisiert diese Prognose auf 9,40 Milliarden USD bis 2034. Das Signal ist klar: Kleinere Organisationen erkennen zunehmend, dass manuelle Infrastrukturführung nicht nachhaltig ist.
Drei Bruchstellen, die manuelle Infrastruktur für KMU gefährlich machen
Manuelle Infrastruktur ist nicht nur unbequem. Sie erzeugt drei systemische Bruchstellen, die für KMU besonders gefährlich sind, weil keine redundante Abteilung die Lücken schließt.
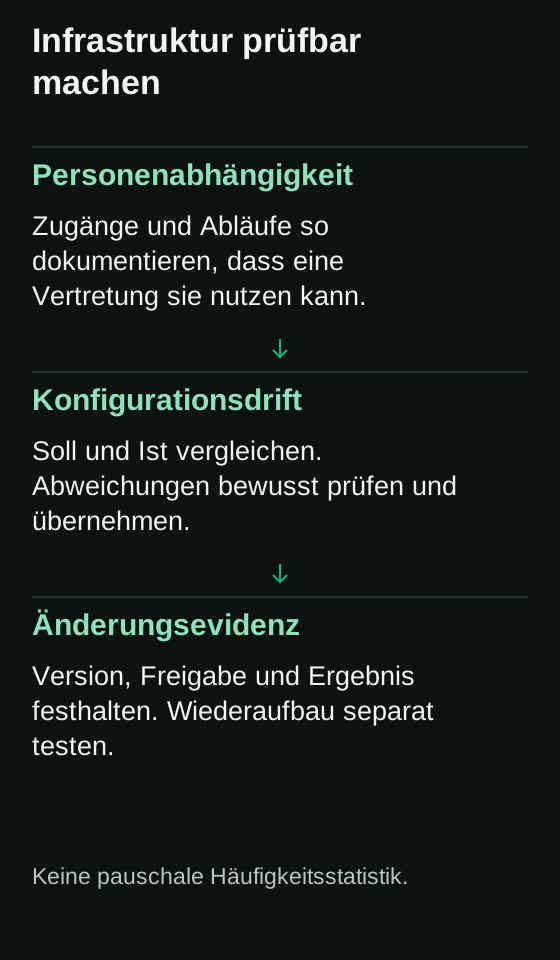
1. Personenabhängigkeit: Wenn Wissen nicht dokumentiert, sondern erinnert wird
Wenn nur Klaus weiß, welche Änderungen an einem Server vorgenommen wurden, muss jede Vertretung diese Informationen neu zusammensuchen. Prüfen Sie konkret, ob eine andere Person den gewünschten Zustand aus Repository, Konfiguration und Betriebsanleitung nachvollziehen kann. Eine allgemeine Prozentzahl über Schlüsselpersonen ersetzt diese Übung nicht.
Für Infrastruktur bedeutet das: Wenn Klaus krank wird, kündigt oder einfach nur im Urlaub ist, existiert das Betriebswissen nicht in dokumentierter Form. Es existiert als Terminal-History, Slack-Nachrichten und mündliche Überlieferung.
2. Konfigurationsdrift: Warum identische Umgebungen nie identisch bleiben
Vor sechs Monaten waren die drei Umgebungen — Development, Staging, Produktion — "identisch". Heute hat jeder Server ad-hoc Änderungen akkumuliert: ein manueller nginx-Tweak auf Staging, ein vergessenes Cron-Job auf Produktion, ein Test-Port, der auf Development offen geblieben ist. Die Umgebungen sind visuell ähnlich, technisch aber divergent.
Konfigurationsdrift kann erklären, warum dieselbe Version in Staging funktioniert und in Produktion scheitert. Vergleichen Sie den deklarierten Zustand mit der tatsächlichen Konfiguration. Git allein erkennt keine außerhalb des Prozesses ausgeführten Änderungen; dafür braucht es passende Prüfungen und eine Zuständigkeit für Abweichungen.
3. Audit-Blindheit: Wenn Änderungen keine Spur hinterlassen
Eine Cyberversicherung, ein ISO-27001-Audit oder die NIS2-Richtlinie fragen nach Evidenz: Wie ist Ihre Infrastruktur konfiguriert? Wer hat was geändert? Gab es einen Review-Prozess? Bei manueller Infrastruktur ist die Antwort eine Sammlung von E-Mail-Threads, Slack-Nachrichten und handschriftlichen Notizen. Es gibt keinen Changelog, keinen Approval-Trail, keine reproduzierbare Baseline.
Ob NIS2-Anforderungen gelten, hängt von der Einrichtung und der nationalen Umsetzung ab. In Deutschland gilt die Umsetzung seit dem 6. Dezember 2025, in Österreich das NISG 2026 seit dem 1. Oktober 2026. Versionskontrolle und nachvollziehbare Änderungen können technische Nachweise unterstützen; Infrastructure as Code ist dadurch weder allgemein vorgeschrieben noch ein Nachweis vollständiger Compliance.
Von der Dokumentation zum Code: Ein pragmatischer Einstiegspfad
Der Sprung von "alles manuell" zu "alles automatisiert" ist für KMU zu groß. Ein vierphasiger Einstiegspfad, angelehnt an das IaC-Maturity-Modell der JISEM (2025), reduziert das Risiko und produziert nach jeder Phase einen messbaren Fortschritt.
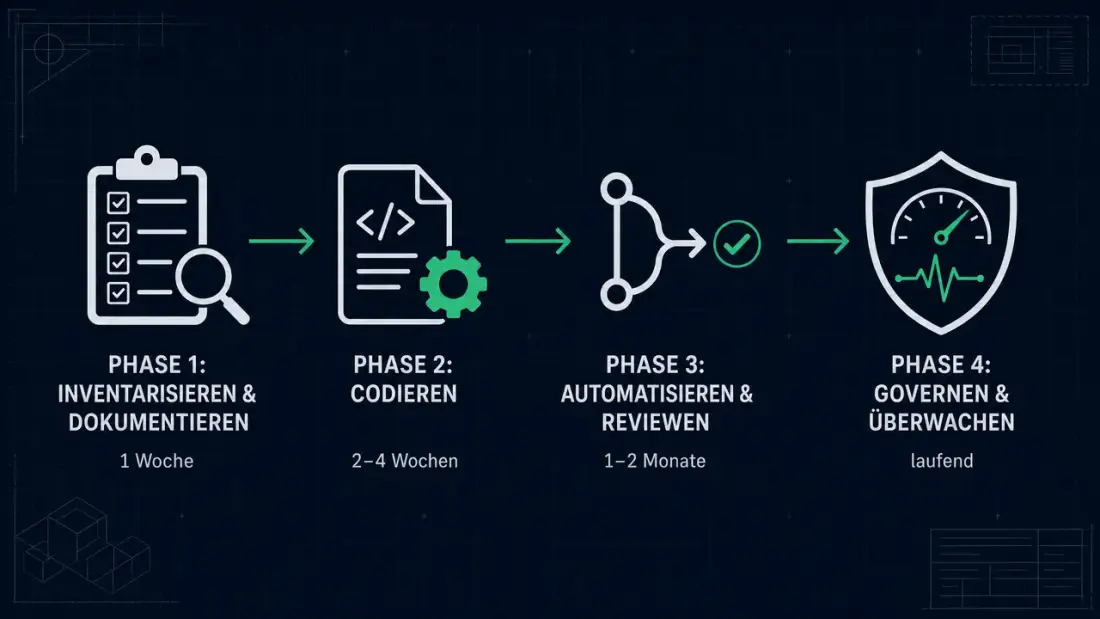
Phase 1: Inventarisieren und dokumentieren (1 Woche)
Bevor Sie automatisieren, müssen Sie wissen, was Sie haben. Erstellen Sie ein Inventar aller Server, Dienste, Cloud-Ressourcen und Konfigurationsdateien. Dokumentieren Sie den aktuellen Zustand — nicht als Roman, sondern als strukturierte Liste: Server-Name, IP, Betriebssystem, laufende Dienste, offene Ports, zuständige Person, letzte Änderung.
Das Ziel dieser Phase ist nicht Perfektion. Das Ziel ist Transparenz. Wenn Klaus morgen im Urlaub ist, sollte ein Kollege dieses Inventar lesen und zumindest wissen, welche Systeme existieren und wo sie laufen.
Phase 2: Konfiguration codieren (2–4 Wochen)
Wählen Sie einen einzigen Dienst oder Server-Typ und beschreiben Sie dessen gewünschten Zustand in Code. Für Linux-Server und Dienste eignet sich Ansible: Ein Playbook, das definiert, welche Pakete installiert sind, welche Konfigurationsdateien existieren und welche Dienste laufen. Für Cloud-Ressourcen eignet sich Terraform: Ein Manifest, das definiert, welche virtuelle Maschinen, Netzwerke und Speicher existieren.
Starten Sie nicht mit dem komplexesten Server. Starten Sie mit einem, den Sie verstehen — vielleicht der Staging-Webserver. Wenn Sie diesen Server aus dem Code neu aufbauen können, haben Sie den wichtigsten Beweis erbracht: Die Konfiguration lebt nicht mehr in einem Kopf, sondern in einer Datei.
Phase 3: Automatisieren und reviewen (1–2 Monate)
Verbinden Sie den Code mit Git. Jede Änderung wird ein Merge Request. Jeder Merge Request wird von einer zweiten Person reviewt — auch wenn diese Person zunächst nur versteht, dass etwas geändert wurde, ohne jedes Detail zu kennen. Die GitLab-CI-Pipeline führt das Playbook aus, nachdem der Merge Request genehmigt wurde.
Der entscheidende kulturelle Wandel passiert hier: Infrastruktur-Änderungen werden nicht mehr "gemacht", sondern "vorgeschlagen, reviewt und angewendet". Das schafft den Audit-Trail, den Compliance-Prüfer suchen.
Phase 4: Governen und überwachen (laufend)
Führen Sie monatliche Drift-Checks durch: Vergleichen Sie die deklarierte Konfiguration mit der tatsächlichen Konfiguration auf den Servern. Führen Sie vierteljährliche Wiederherstellungsübungen durch: Bauen Sie einen Testserver komplett aus dem Code neu auf. Pflegen Sie das Inventar. Reviewen Sie die Merge-Request-Qualität.
Diese Routinen wirken unspektakulär. Aber sie verhindern, dass die Infrastruktur nach sechs Monaten wieder zu einer Sammlung manueller Tweaks verkommt.
GitOps für den Mittelstand: Git als einzige Wahrheitsquelle
GitOps ist kein neues Tool. Es ist ein Betriebsmodell: Git ist die einzige Wahrheitsquelle für sowohl Anwendungs-Code als auch Infrastruktur-Code. Wenn sich der gewünschte Zustand ändert, ändern Sie eine Datei in Git. Ein Automatisierungstool bemerkt die Änderung und bringt die tatsächliche Umgebung in den gewünschten Zustand.
Für KMU ist Git der richtige Kontrollpunkt, weil die meisten Unternehmen bereits Git für Softwareentwicklung nutzen. Das bedeutet: Kein neues Tool, keine neue Lizenz, keine neue Lernkurve. Das bedeutet auch: Der Review-Prozess, den Sie für Code-Änderungen bereits kennen, gilt nun auch für Infrastruktur-Änderungen.
Die Werkzeugkette für den Mittelstand ist pragmatisch skalierbar:
- Ansible für Betriebssystem- und Service-Konfiguration. Es benötigt keinen Agent auf den Zielservern, arbeitet über SSH und ist idempotent: Mehrfaches Ausführen desselben Playbooks führt immer zum selben Zustand.
- Terraform oder Kubernetes-Manifeste für Cloud-Ressourcen und Container-Orchestrierung. Terraform ist besonders wertvoll, wenn Sie zwischen Cloud-Providern wechseln oder eine Multi-Cloud-Strategie verfolgen.
- GitLab CI als Ausführungs- und Review-Schicht. Die Pipeline führt Playbooks aus, führt Qualitätsgates durch und dokumentiert jeden Schritt.
Die Planfold-Proof-Story zur Infrastruktur-Standardisierung validiert dieses Modell in der Praxis: GitLab als Wahrheitsquelle für Inventare, Playbooks und Rollenstruktur. GitLab CI für Qualitäts- und Hygiene-Gates. Ansible für Linux- und Windows-Administration. Semaphore für kontrollierte Ausführung, Scheduling und Operator-Workflows. Das Ergebnis ist nicht nur Automatisierung — es ist ein governables Betriebsmodell mit weniger Drift, geringerer Personenabhängigkeit und klaren Audit-Spuren.
Planfold-Perspektive: Souveränität beginnt mit Wiederholbarkeit
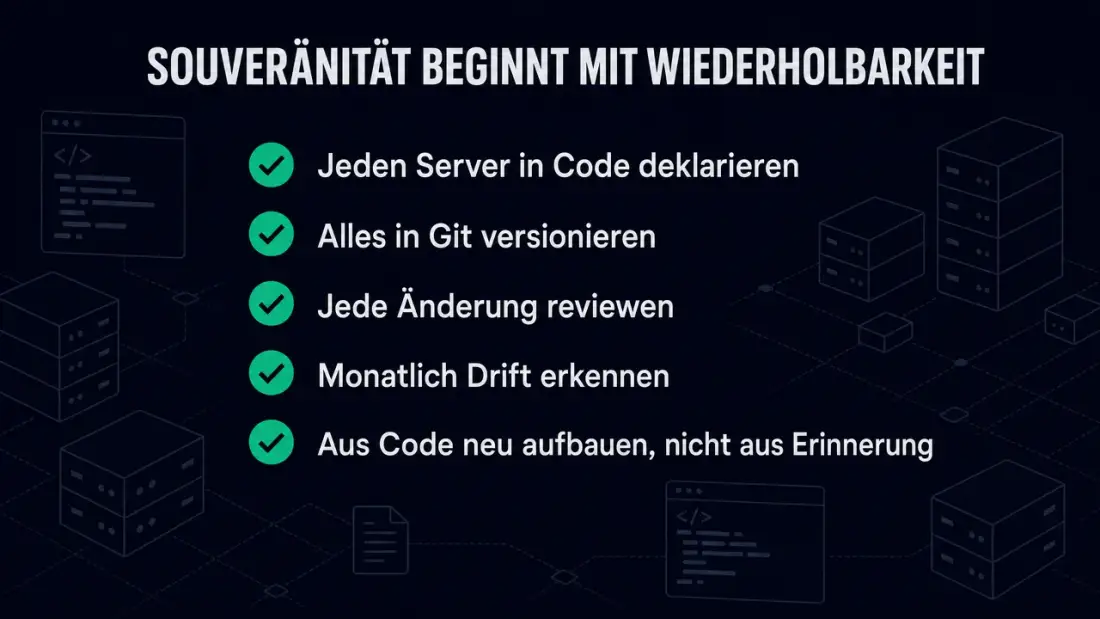
Planfold behandelt Infrastruktur von Tag eins als Code. Jeder Server, jede Netzwerkregel, jede Service-Konfiguration ist in versionierten Dateien deklariert, die in Git leben, Review durchlaufen und von automatisierten Pipelines angewendet werden. Das ist nicht ein Werkzeug-Stack. Das ist ein Betriebsmodell.
Plan bedeutet: Ihre aktuelle Infrastruktur kartieren. Welche Server existieren? Wo lebt das Wissen? Welche Abhängigkeiten bestehen? Wo ist die größte Drift? Welche Audit-Lücken sind vorhanden?
Unfold bedeutet: Die Wiederholbarkeitsschicht bauen. Ein erstes Inventar, ein erstes Playbook, eine GitLab-CI-Pipeline, ein Review-Prozess. Nicht als separates Compliance-Portal, sondern als Teil Ihrer digitalen Firmenzentrale: in Workflows, Dokumentation, Rollen und Automatisierung.
Resonate bedeutet: Evidenz pflegen. Monatliche Drift-Checks. Quartalsweise Wiederherstellungsübungen. Review der Merge-Request-Qualität. Anpassung der Playbooks, wenn sich ein System ändert. Diese Routinen verhindern, dass Infrastruktur nach einem Jahr wieder zu Erinnerung und Vermutung wird.
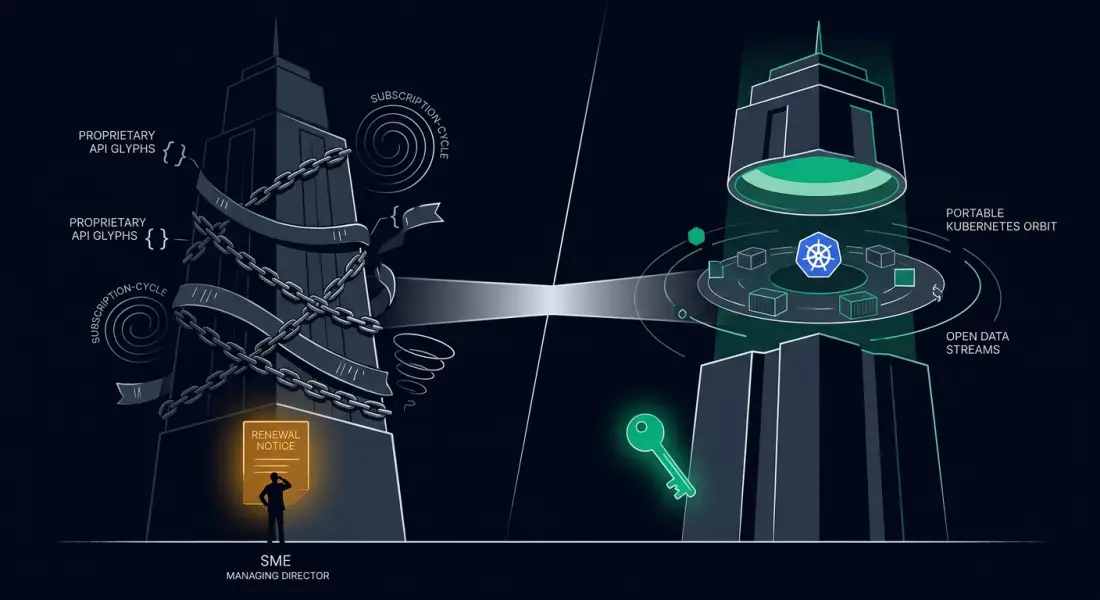
Warum portabel bedeutet, aus dem Code neu aufbauen zu können: Wenn Ihre gesamte Infrastruktur in versionierten, reviewten Dateien lebt, können Sie den Ausstiegsschlüssel behalten. Sie können den Cloud-Provider wechseln, ohne drei Monate Reverse-Engineering zu betreiben. Sie können Audit-Fragen mit einem Git-Log beantworten. Sie können neue Umgebungen in Stunden statt in Tagen aufbauen — weil der Code die Umgebung beschreibt, nicht ein Mensch sie aus dem Gedächtnis rekonstruiert.
Der nächste Schritt ist konkret. Wenn Ihre Infrastruktur heute auf manueller Konfiguration basiert, auf personenabhängigem Wissen und auf fehlenden Audit-Spuren, dann ist der erste Schritt nicht der Kauf einer Enterprise-Plattform. Der erste Schritt ist die Entscheidung, dass Server-Konfiguration keine persönliche Erinnerungsleistung mehr sein darf.