KI-Kompetenz: Der Wettbewerbsvorteil, bevor KI zum Risiko wird
KI-Kompetenz ist mehr als Prompt-Training. Wie KMU Shadow AI erkennen, Teams befähigen und aus unkontrollierter KI-Nutzung einen geprüften Workflow machen.
Inhalt
KI-Kompetenz ist mehr als Prompt-Training. Wie KMU Shadow AI erkennen, Teams befähigen und aus unkontrollierter KI-Nutzung einen geprüften Workflow machen.
Artikel teilen
Das KI-Problem ist nicht mehr Zugang, sondern Kontrolle
In vielen DACH-Unternehmen ist KI längst im Alltag angekommen, nur nicht unbedingt im offiziellen Betrieb. Ein Vertriebsteam lässt Angebote vorformulieren. Der Kundenservice fasst E-Mails zusammen. HR testet eine KI-Funktion für Stellenanzeigen oder Bewerbungsunterlagen. Eine Assistenz nutzt ein öffentliches Tool, um interne Protokolle zu strukturieren. Jede einzelne Nutzung wirkt harmlos, schnell und produktiv.
Die Geschäftsführung sieht aber oft nur das Ergebnis. Niemand kann sicher sagen, welche Kundendaten in welches Tool kopiert wurden, welche Quellen die KI genutzt hat, ob eine Ausgabe geprüft wurde oder ob ein Vorschlag später in einer Entscheidung gelandet ist. Das Unternehmen hat dann nicht zu wenig KI. Es hat zu wenig Kontrolle über die KI, die bereits genutzt wird.
Genau deshalb wird KI-Kompetenz zum Wettbewerbsvorteil. Nicht als Zertifikat an der Wand und nicht als einmaliger Prompt-Kurs, sondern als Betriebsschicht: Menschen verstehen Grenzen und Risiken, Workflows definieren Prüfung und Eskalation, Systeme halten Quellen und Entscheidungen nachvollziehbar fest. So wird aus Shadow AI kein Verbotsthema, sondern ein Hinweis darauf, wo ein besserer genehmigter Weg gebraucht wird.
Aktuelle Arbeitsmarktdaten zeigen, dass diese Nutzung nicht mehr am Rand stattfindet. Gallup berichtete im April 2026, dass die Hälfte der befragten US-Beschäftigten KI zumindest gelegentlich in ihrer Rolle nutzt; 13 Prozent nutzen sie täglich. Die Zahlen sind nicht DACH-spezifisch, aber sie zeigen die Richtung: Zugang ist nicht mehr der Engpass. Der Engpass ist die Fähigkeit, KI in reale Geschäftsprozesse einzubauen, ohne Daten, Qualität und Verantwortung zu verlieren.
Was KI-Kompetenz für Unternehmen wirklich bedeutet
Der EU AI Act beschreibt AI Literacy in Artikel 4 nicht als abstraktes Wissensideal. Anbieter und Betreiber von KI-Systemen sollen Maßnahmen ergreifen, damit Mitarbeitende und Personen, die in ihrem Auftrag handeln, ausreichende KI-Kompetenz haben. Entscheidend sind Kontext, Rolle, Erfahrung, Ausbildung und die Personen oder Gruppen, die von einem KI-System betroffen sein können. Artikel 4 gilt seit dem 2. Februar 2025; die Durchsetzung durch nationale Marktüberwachung gewinnt ab 2026 an praktischer Bedeutung.
Dieser Artikel ist eine praktische Einordnung für Unternehmen, keine Rechtsberatung. Einstufung und Pflichten sollten für das konkrete System rechtlich und datenschutzrechtlich geprüft werden. Für die operative Arbeit ist aber schon jetzt klar: KI-Kompetenz ist breiter als Hochrisiko-KI. Auch alltägliche ChatGPT-ähnliche Nutzung im Unternehmen braucht ein Verständnis für Halluzinationen, Datenabfluss, Rollenverantwortung und menschliche Prüfung.
Ein generischer Prompt-Kurs löst dieses Problem nicht. Prompting kann nützlich sein, aber Unternehmen brauchen mehr als bessere Befehle an ein Modell. Sie brauchen Datenklassen, erlaubte Tools, die Prüfung von Quellen, Eskalationsregeln, Review-Punkte und eine klare Linie, wann KI nur vorbereitet und wann ein Mensch entscheiden muss. BCGs 10-20-70-Perspektive auf KI-Transformation passt hier gut: Der größere Teil der Arbeit liegt nicht im Algorithmus, sondern in Menschen, Prozessen und Organisation.
KI-Kompetenz heißt deshalb: Ein Team weiß, welche KI-Systeme es verwendet, welche Daten hinein dürfen, welche Ausgaben skeptisch geprüft werden müssen, welche Aufgaben für KI ungeeignet sind und wo Entscheidungen dokumentiert werden. Das ist weniger spektakulär als ein neues Tool. Aber es ist die Grundlage, damit KI im Betrieb schneller statt riskanter wird.
Die Kosten von KI-Unwissenheit
Shadow AI entsteht selten aus böser Absicht. Sie entsteht, weil Mitarbeitende ein Problem lösen wollen und der offizielle Weg fehlt. Wenn der freigegebene Prozess langsam ist, der Wissensstand verstreut liegt und niemand einen sicheren KI-Workflow bereitstellt, gewinnt das öffentliche Tool im Browser. Kurzfristig spart das Zeit. Mittelfristig entstehen Nacharbeit, Datenrisiken und Vertrauensverlust.
Die CybSafe- und National Cybersecurity Alliance-Auswertung aus 2024 berichtete, dass 38 Prozent der befragten Beschäftigten sensible Arbeitsinformationen ohne Wissen des Arbeitgebers mit KI-Tools geteilt hatten; mehr als die Hälfte hatte keine Schulung zur sicheren KI-Nutzung erhalten. Diese Zahlen sollten nicht dramatisiert werden, aber sie machen das Grundmuster sichtbar: Ohne klare Regeln wird Produktivität privat organisiert und Risiko kollektiv getragen.
Der finanzielle Schaden zeigt sich oft nicht als großer Einzelvorfall. Er zeigt sich als Korrekturschleifen: KI-Texte müssen neu geprüft werden, weil Quellen fehlen. Angebote werden überarbeitet, weil ein Modell alte Konditionen vermischt hat. Support-Antworten klingen plausibel, enthalten aber falsche Zusagen. Ein Audit-Fragebogen kostet mehrere Tage, weil niemand rekonstruieren kann, welche KI welche Daten berührt hat.
Der Zeitverlust ist besonders tückisch. Jede unprotokollierte KI-Abkürzung kann später zur Untersuchung werden: Wer hat den Text erzeugt? Welche Kundendaten wurden verwendet? War die Quelle aktuell? Wer hat geprüft? Wurde ein Mensch informiert oder betroffen? Je mehr KI im Alltag hilft, desto teurer wird der nachträgliche Versuch, Ordnung in Spuren zu bringen, die nie angelegt wurden.
Der Vertrauensverlust kommt danach. Teams merken, dass KI-Ausgaben nicht belastbar sind, und prüfen alles doppelt. Führungskräfte verlieren die Bereitschaft, sinnvolle Automatisierung freizugeben. Kunden stellen Governance-Fragen, bevor das Unternehmen eine klare Antwort hat. In diesem Zustand wird KI nicht zum Hebel, sondern zu einer weiteren unsichtbaren Betriebsunsicherheit.
Diagnose: Ist Ihr Team KI-kompetent oder nur KI-glücklich?
Eine KI-kompetente Organisation erkennt man nicht daran, dass viele Mitarbeitende KI nutzen. Man erkennt sie daran, dass die Nutzung erklärbar ist. Es gibt ein Inventar der KI-Werkzeuge, eine Regel für Datenklassen, eine Liste freigegebener Tools, benannte Owner und ein Verfahren für neue Use Cases. Teams wissen nicht nur, was erlaubt ist, sondern auch warum.
Der einfachste Test ist eine kurze AI-Use-Inventur. Fragen Sie jede Abteilung, welche KI in der vergangenen Woche Arbeit berührt hat: Recherche, Zusammenfassung, Bild, Text, Code, Support, CRM, HR, Dokumentenverarbeitung, Meeting-Notizen. Dann ergänzen Sie: Welche Daten wurden genutzt? War das Tool freigegeben? Wurde das Ergebnis geprüft? Ist die Ausgabe in eine Kundenkommunikation, Personalentscheidung oder andere relevante Handlung eingeflossen?
Die Warnzeichen sind klar: KI-Nutzung lebt in persönlichen Accounts, Ergebnisse werden ohne Quellen übernommen, Kundendaten werden in öffentliche Tools kopiert, HR- oder Finanzprozesse haben keine gesonderte Prüfung, und niemand weiß, ob ein SaaS-Feature KI im Hintergrund nutzt. Ein weiteres Zeichen ist Überkorrektur: Das Unternehmen verbietet KI pauschal, obwohl die Teams sie brauchen. Dann verlagert sich Nutzung nur weiter in den Schatten.
Eine bessere Diagnose trennt Produktivität von Risiko. Viele KI-Anwendungen sind niedrigschwellig und trotzdem dokumentationswürdig. Andere können, je nach Kontext, Hochrisiko-Fragen berühren oder zusätzliche Transparenz- und Aufsichtspflichten auslösen. Die Europäische Kommission konsultiert seit dem 19. Mai 2026 Leitlinien zur Einstufung von Hochrisiko-KI-Systemen. Das ist ein guter Grund, heute mit Inventar und Kompetenz zu beginnen, statt später Klassifizierung aus verstreuten Einzelfällen zu rekonstruieren.
Vom Shadow AI zur geprüften Arbeitsweise
Der sichere Pfad beginnt vor dem Modell
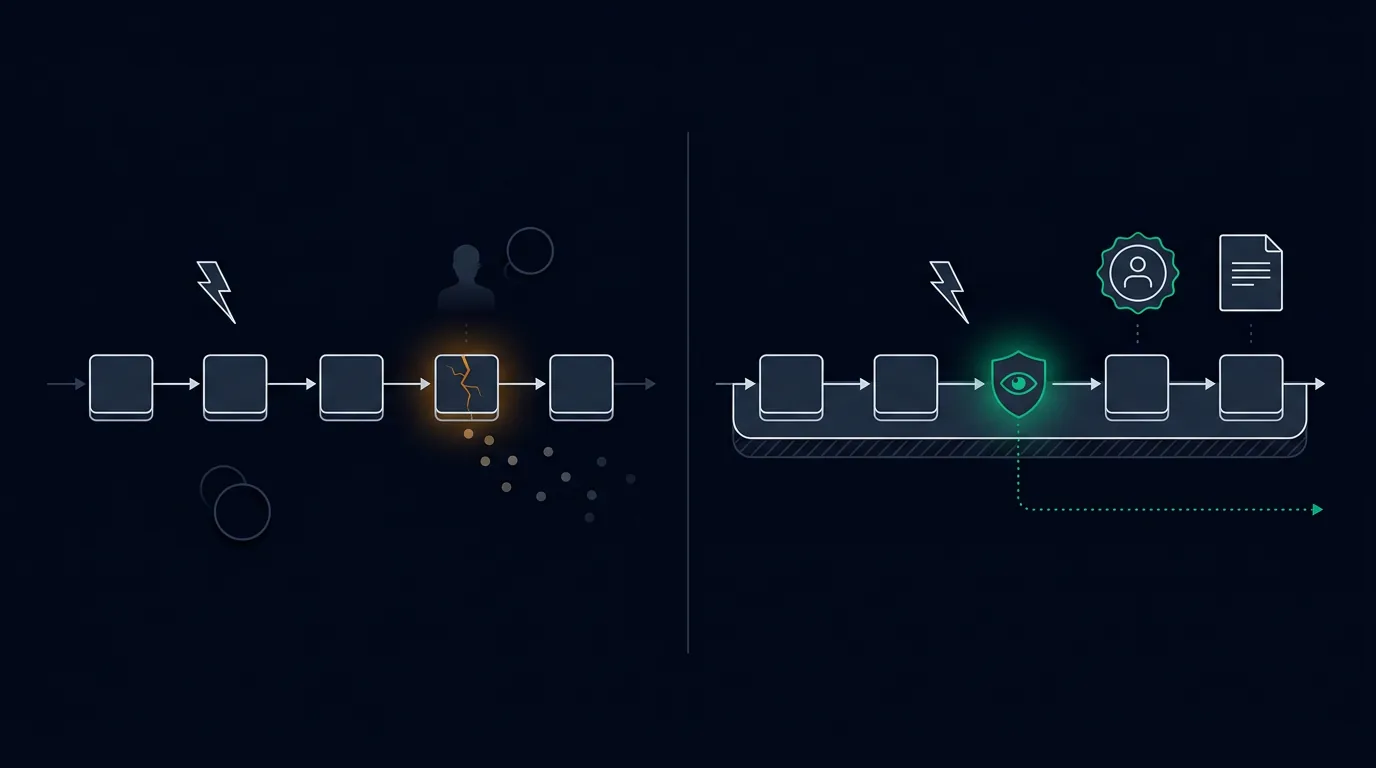
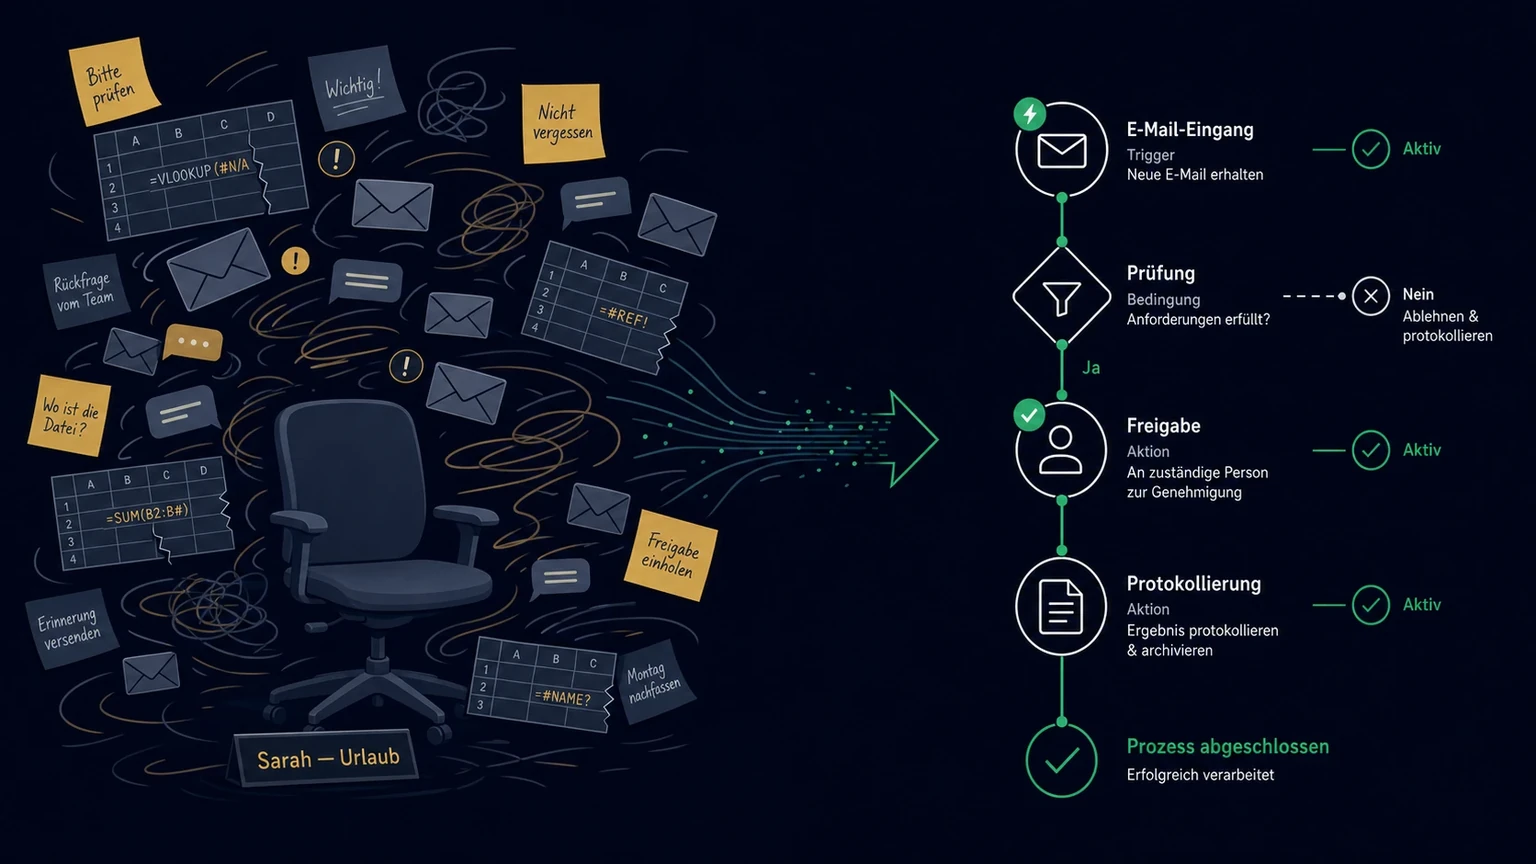
Stellen Sie sich ein 35-Personen-Dienstleistungsunternehmen vor. Es nutzt KI, um Kundenanfragen vorzubereiten und eingehende Anfragen zu qualifizieren. Vorher kopieren Mitarbeitende E-Mail-Kontext in öffentliche Tools. Es gibt keine gemeinsame Prompt-Logik, keine freigegebenen Wissensquellen und keine Aufzeichnung, welche Antwortvorschläge geprüft wurden. Die Inhaberin sieht nur den finalen Text.
Nachher beginnt der Prozess mit einer AI-Use-Map. Welche Anfragen dürfen automatisiert vorbereitet werden? Welche Kundendaten sind tabu? Welche internen Wissensquellen sind freigegeben? Wann muss ein Mensch prüfen? Was passiert, wenn Quellen fehlen oder das Modell unsicher wirkt? Aus diesen Fragen wird kein großes Transformationsprogramm, sondern ein erster geprüfter Workflow.
Prüfung wird Teil des Arbeitsflusses
Der Unterschied liegt im Betrieb. Die Anfrage kommt kontrolliert in den Workflow. Die KI nutzt freigegebene Wissensquellen statt zufälliger Copy-Paste-Kontexte. Der Antwortentwurf wird mit Quellenhinweisen und Unsicherheiten angezeigt. Ein Mensch prüft, ändert oder verwirft den Vorschlag. Erst danach geht eine Nachricht an den Kunden oder ein Datensatz in das CRM. Die Korrektur landet wieder im Verbesserungslog.
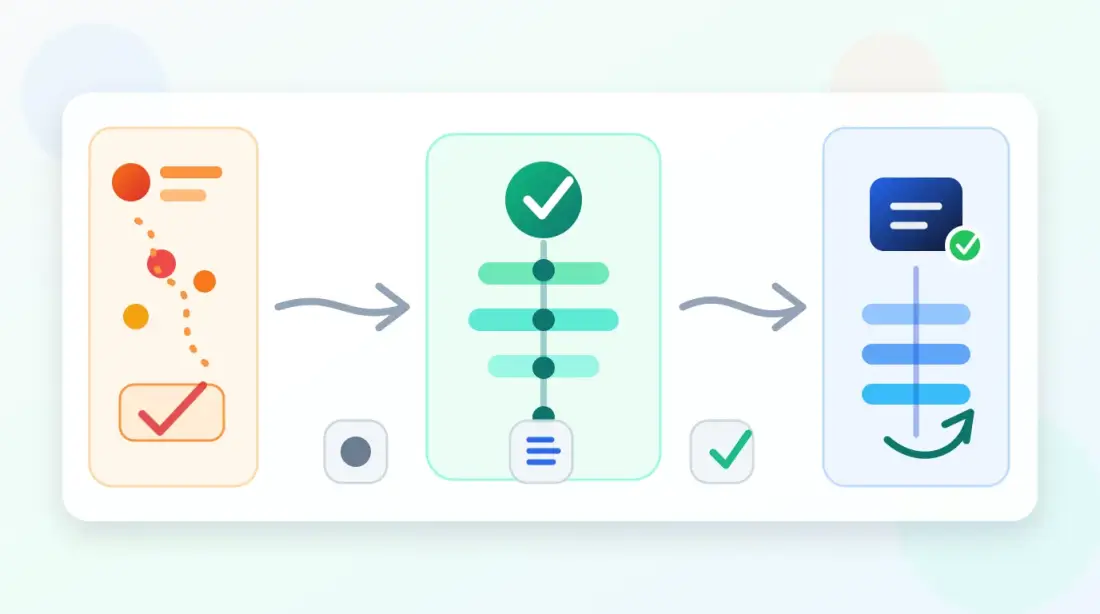
Dieses Beispiel ist bewusst einfach. Es geht nicht darum, einen Menschen durch einen Agenten zu ersetzen. Es geht darum, die echte Nachfrage nach KI in eine Arbeitsweise zu bringen, die schneller ist als der alte manuelle Weg und sicherer als der Schattenweg. Genau dort entsteht Wettbewerbsvorteil: nicht im Modell selbst, sondern in der Fähigkeit, es kontrolliert in Arbeit zu übersetzen.
Das technische Betriebsmodell: Wissen zuerst, Agent danach
Viele Unternehmen springen direkt zum Agenten. Das klingt modern, überspringt aber die wichtigste Frage: Worauf darf der Agent zugreifen, und wer verantwortet dieses Wissen? Retrieval-Augmented Generation kann Antworten verbessern, aber nur, wenn die Wissensbasis Eigentümer, Aktualität, Berechtigungen und Review-Pfade hat. Sonst ruft die KI nur strukturiertes Durcheinander ab.
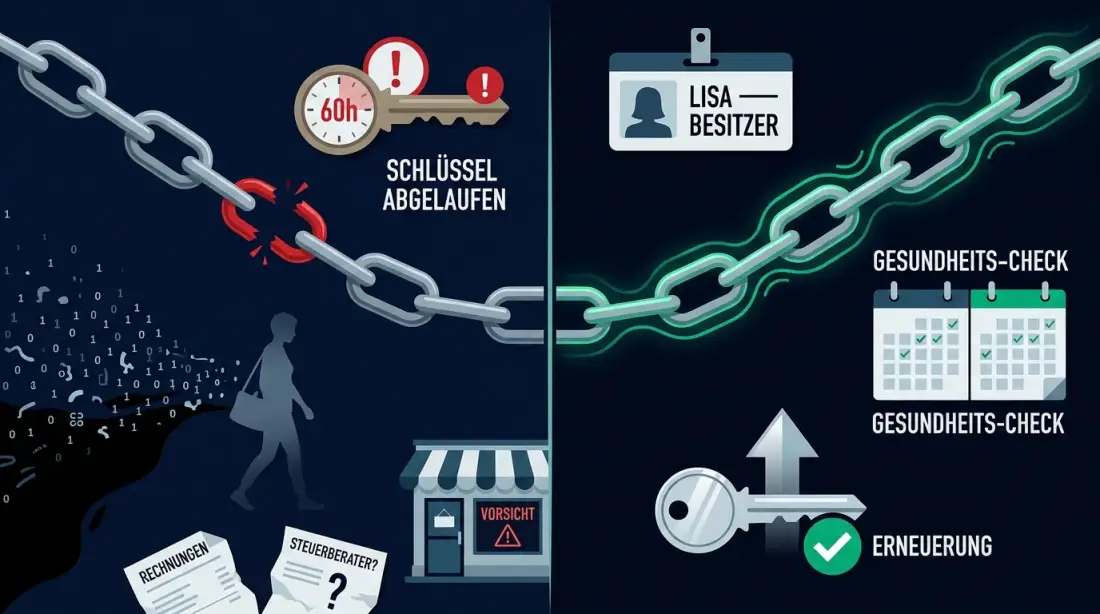
Ein belastbares Modell beginnt mit der Wissensschicht. Dort liegen freigegebene Dokumente, Prozessregeln, Angebotslogik, Produktinformationen, Supportantworten und Datenschutzgrenzen. Jede Quelle braucht einen Owner und ein Aktualitätsdatum. Veraltete Inhalte dürfen nicht still weiter als Wahrheit dienen. Rechte müssen abbilden, wer was sehen darf. Gerade bei Kundendaten, Personalinformationen und Finanzdaten ist das kein Detail, sondern die Grundlage.
Darauf folgt der KI-Workflow. Er sollte so gebaut sein, dass Eingabe, Quelle, Modellaufruf, Ergebnis, Prüfung, Aktion und Feedback sichtbar sind. Wenn Quellen fehlen, muss der Workflow das melden. Wenn eine Ausgabe konsequente Wirkung hat, muss menschliche Prüfung davor liegen. Wenn ein Ergebnis korrigiert wird, sollte die Korrektur nicht im Postfach verschwinden, sondern als Lernsignal in den Betrieb zurückfließen.
Human-in-the-loop bedeutet dabei nicht, dass irgendwo theoretisch ein Mensch existiert. Es bedeutet: vor externer Kommunikation prüfen, bei relevanten Entscheidungen freigeben, bei niedriger Quellenabdeckung eskalieren, bei persönlicher Betroffenheit besondere Vorsicht anwenden und jeden Eingriff nachvollziehbar festhalten. Nur so bleibt KI-Kompetenz mehr als Schulungsnachweis.
Die technische Entscheidung muss nicht immer lokal oder immer global heißen. Planfolds Automatisierungsansatz unterstützt offene Orchestrierung, interne Wissensbasen und austauschbare Modellanbieter. Entscheidend ist, dass das Unternehmen den Ausstiegsschlüssel behält: Datenflüsse sind dokumentiert, Schnittstellen offen, Berechtigungen nachvollziehbar und der Betrieb nicht an ein unprüfbares Tool gebunden.
Planfold-Perspektive: Planen, Entfalten, Resonanz erzeugen
Planfold behandelt KI-Kompetenz nicht als isolierte Schulung. Sie gehört in die digitale Firmenzentrale, also in den Ort, an dem Arbeit, Wissen, Rollen und Automatisierung zusammenlaufen. Die Frage lautet nicht: Welches KI-Tool sollen wir kaufen? Die bessere Frage lautet: Welcher Arbeitsfluss soll mit KI verlässlicher werden, und welche Kontrolle braucht er?
Planen bedeutet: KI-Nutzung inventarisieren, Risiken grob einordnen, Datenklassen klären, Wissensquellen prüfen und Owner benennen. Das Ergebnis ist keine Hochglanzstrategie, sondern eine Arbeitskarte: Wo hilft KI bereits? Wo entsteht Shadow AI? Welche Nutzung darf bleiben, welche braucht Grenzen und welche sollte gestoppt werden?
Entfalten bedeutet: einen ersten Workflow bauen. Nicht die ganze Organisation auf einmal. Ein klarer Use Case mit genehmigten Quellen, Berechtigungen, Logs, Review-Punkt und Fallback reicht als Anfang. Wenn dieser Workflow nützlich ist, wählen Teams ihn freiwillig, weil er einfacher ist als unsicheres Copy-Paste.
Resonanz erzeugen bedeutet: Korrekturen, Ausnahmen und Fehlversuche nicht ignorieren. Welche Entwürfe wurden abgelehnt? Welche Quellen fehlten? Wo musste ein Mensch eingreifen? Welche Daten dürfen künftig nicht mehr in den Prozess? Aus diesen Signalen verbessert sich der Workflow, ohne dass Kontrolle verloren geht.
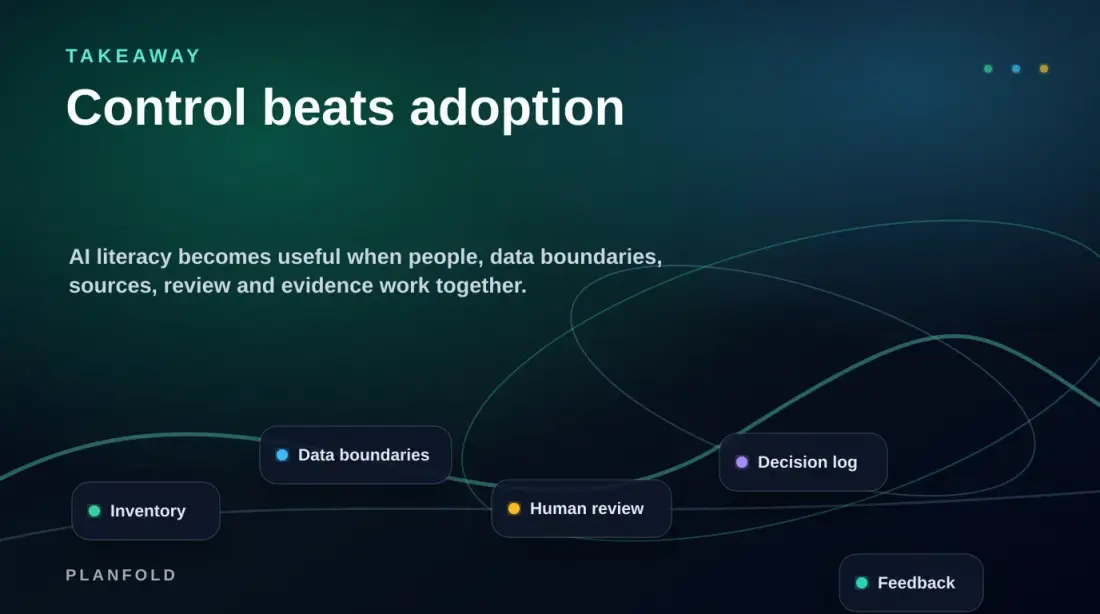
Der nächste Schritt: KI-Kompetenz in die digitale Firmenzentrale bauen
Wenn Sie jetzt starten, beginnen Sie nicht mit einem breiten Trainingsdeck. Beginnen Sie mit einer AI-Use-Map und einem einzelnen Workflow, der Kundendaten, interne Wissensquellen oder relevante Entscheidungen berührt. Legen Sie fest, welche Daten hinein dürfen, welche Quellen verbindlich sind, wer prüft, was protokolliert wird und wann ein Fallback greift.
Danach wird KI-Kompetenz konkret. Mitarbeitende wissen, wie sie KI nutzen dürfen. Führungskräfte sehen, welche Use Cases wirklich passieren. Kundenfragen lassen sich schneller beantworten. Neue KI-Werkzeuge werden nicht nach Bauchgefühl freigegeben, sondern nach Zweck, Daten, Risiko, Prüfung und Ausstiegspfad bewertet.
Das ist kein Versprechen rechtlicher Compliance und keine Abkürzung um Rechts- oder Datenschutzprüfung. Es ist die operative Grundlage, auf der solche Prüfungen überhaupt sauber werden können. Planen. Entfalten. Souverän bleiben.