Manuelles Monitoring: Warum Dashboards allein Ihr Unternehmen nicht schützen
Dashboards zeigen oft nur, dass Daten existieren. Erfahren Sie, warum manuelles Monitoring KMU ausbremst und wie klare Signale, Runbooks und Eskalationen digitale Abläufe stabiler machen.
Inhalt
Dashboards zeigen oft nur, dass Daten existieren. Erfahren Sie, warum manuelles Monitoring KMU ausbremst und wie klare Signale, Runbooks und Eskalationen digitale Abläufe stabiler machen.
Artikel teilen
Der Fehler vom Freitag, den niemand bis Montag sieht
Freitagabend wird auf der Website eines Dienstleistungsbetriebs ein kleines Update eingespielt. Die Startseite lädt. Der Hoster meldet grün. Das Monitoring-Dashboard zeigt keine roten Warnungen. Was niemand sieht: Das Kontaktformular nimmt Anfragen an, verschickt aber keine Bestätigung und schreibt keinen Lead ins CRM.
Montagmorgen fragt der Vertrieb, warum vom Wochenende keine qualifizierten Anfragen eingegangen sind. Erst dann beginnt die Suche. Formulare testen, Mailbox prüfen, CRM-Log ansehen, Entwickler anrufen, Zeitfenster rekonstruieren, verlorene Nachrichten suchen. Das Problem war nicht, dass es keine Daten gab. Das Problem war, dass kein System den geschäftlichen Ablauf überwacht hat.
So sieht manuelles Monitoring in vielen KMU aus. Jemand schaut regelmäßig auf ein Dashboard, ein Tool oder eine Mailbox und hofft, dass Auffälligkeiten rechtzeitig sichtbar werden. Das fühlt sich verantwortungsvoll an, bleibt aber eine Person-abhängige Gewohnheit. Wenn der Fehler nach Feierabend, im Urlaub oder zwischen zwei Zuständigkeiten passiert, findet ihn oft der Kunde zuerst.
Warum Dashboards sicher wirken, aber Ihr Geschäft offen lassen
Ein Dashboard beantwortet Fragen. Es zeigt Metriken, Logs, Statusmeldungen oder historische Ausführungen. Das ist hilfreich für Analyse und Fehlersuche. Es ist aber noch keine Betriebsorganisation. Der Unterschied ist entscheidend: Monitoring ist erst dann wirksam, wenn ein relevantes Signal eine verantwortliche Person, einen Eskalationsweg und eine Handlung auslöst.
Google SRE trennt deshalb klar zwischen Dashboards und Alerting. Dashboards helfen beim Verstehen. Alerting sagt: Etwas ist kaputt, und jemand muss jetzt reagieren. Für KMU ist diese Trennung nicht akademisch. Eine Website kann HTTP 200 liefern, während das Formular, der CRM-Token, der Rechnungsexport oder die Backup-Wiederherstellung trotzdem gebrochen ist.
Sichtbarkeit ist nicht gleich Erkennung
Viele Systeme sind sichtbar, ohne überwacht zu sein. Der Hoster zeigt Serverwerte. Das CRM zeigt Kontakte. n8n zeigt Ausführungen. Die Buchhaltung zeigt Exporte. Jedes Tool enthält ein Stück Wahrheit, aber keines besitzt automatisch die Verantwortung für den gesamten Geschäftsprozess.
Entscheidend ist die Frage: Woran merken Sie, dass der gewünschte geschäftliche Ausgang tatsächlich eingetreten ist? Bei einer Anfrage ist das nicht der Seitenaufruf, sondern ein vollständiger Weg: Formular abgeschickt, Bestätigung verschickt, Lead im CRM, zuständige Person benachrichtigt. Wer nur den Server beobachtet, sieht diese Kette nicht.
Menschliche Aufmerksamkeit skaliert nicht über Workflows
Manuelle Prüfungen funktionieren am Anfang, solange wenige Systeme und eine technisch versierte Person beteiligt sind. Später entstehen Ferienvertretungen, neue Tools, Rollenwechsel, externe Dienstleister und Automatisierungen, die niemand mehr täglich vor Augen hat.
Atlassian empfiehlt in der Incident-Praxis nicht ohne Grund Alerting-Tools und Rufbereitschaftsmodelle statt Abhängigkeit von einzelnen Personen. Menschen wechseln Jobs, werden krank, machen Urlaub oder sind mit Kundenterminen beschäftigt. Ein Betriebssystem für digitale Abläufe muss diese Realität einplanen.
Alert-Lärm macht gute Signale schwach
Das Gegenproblem ist genauso gefährlich: zu viele Warnungen. Wenn jedes kleine Ereignis eine E-Mail erzeugt, lernt das Team, den Kanal zu ignorieren. Dann ist das Unternehmen wieder bei manueller Aufmerksamkeit, nur mit mehr Geräusch.
Gute operative Signale sind wenige, aber scharf. Sie orientieren sich an Symptomen, die Nutzer oder Geschäftsprozesse betreffen: Anfrage kommt nicht an, Synchronisation hängt, Zahlungspfad bricht, Export fehlt, Backup lässt sich nicht wiederherstellen. Nicht jedes Log-Event verdient einen Alarm.
Der Preis des Bildschirm-Schauens
Manuelles Monitoring verlagert Zuverlässigkeit in Erinnerung, Gewohnheit und Bauchgefühl. Das ist kein stabiles Betriebsmodell, sondern ein stilles Risiko. Der Schaden entsteht selten nur durch den eigentlichen Ausfall. Er entsteht durch die Zeit, bis jemand den Ausfall erkennt, versteht und sauber behebt.
Ausfallkosten sollten für KMU vorsichtig eingeordnet werden. Das Uptime Institute Annual Outage Analysis berichtet zwar, dass viele größere Ausfälle hohe Kosten verursachen, weist aber selbst auf Datenlücken und unterschiedliche Meldepraktiken hin. Für einen Handwerksbetrieb, eine Agentur oder ein kleines SaaS-Team ist die konkrete Rechnung oft bodenständiger: verlorene Anfragen, verzögerte Rechnungen, manuelle Rekonstruktion, Notfallarbeit und geschwächtes Vertrauen in den digitalen Kanal.
Zeitkosten: Jeder Vorfall beginnt mit Erkennungsverzug
Wenn ein Fehler erst am Montag sichtbar wird, muss das Team nicht nur reparieren. Es muss den Startzeitpunkt finden, betroffene Daten rekonstruieren, Kunden informieren, Automatisierungen erneut ausführen und klären, ob noch weitere Prozesse betroffen waren.
Die Atlassian-Incident-Metriken behandeln Time to Detect (TTD) und Time to Recovery (TTR) als entscheidende Indikatoren. Das ist auch für KMU sinnvoll. Wer den Beginn, die Erkennung und das Ende eines Vorfalls nicht festhält, lernt wenig daraus und wiederholt dieselben blinden Stellen.
Finanzielle Kosten: Ausfall ist nur die sichtbare Zeile
Ein defektes Formular kostet nicht nur die verlorene Anfrage. Es kostet Vertriebszeit, Nacharbeit, Entwicklerstunden, Management-Aufmerksamkeit und oft auch Werbebudget, das weiterläuft, während der Lead-Pfad kaputt ist.
Der ITIC Hourly Downtime Survey nennt auch kleinere Beispielrechnungen, bei denen schon niedrige vier- oder fünfstellige Stundenkosten schnell relevant werden. Solche Zahlen sind keine Garantie für Ihren Betrieb. Sie zeigen aber, warum "nur ein paar Stunden" bei umsatznahen Workflows nicht harmlos ist.
Vertrauenskosten: Kunden merken es zuerst
Der unangenehmste Vorfall ist der, den ein Kunde meldet. Dann ist die Firma nicht mehr in der Position, proaktiv zu erklären. Sie muss reagieren, entschuldigen und beweisen, dass sie ihren digitalen Kanal im Griff hat.
Der PwC Trust Survey 2024 beschreibt Vertrauen als etwas, das durch konkrete Handlungen und nachvollziehbaren Schutz sensibler Informationen entsteht. Für digitale Abläufe heißt das: Zuverlässigkeit ist nicht nur ein technisches Ziel. Sie ist Teil des Versprechens, das ein Unternehmen gegenüber Kunden, Partnern und Mitarbeitern macht.
Die operative Signal-Karte
Ein belastbares Monitoring-Modell beginnt nicht beim Tool. Es beginnt bei der Frage, welcher Geschäftsprozess nicht still ausfallen darf. Danach wird definiert, welches Signal diesen Prozess abbildet, wann es kritisch wird, wer es bekommt, was dann passiert und welcher Nachweis nach dem Vorfall bleibt.
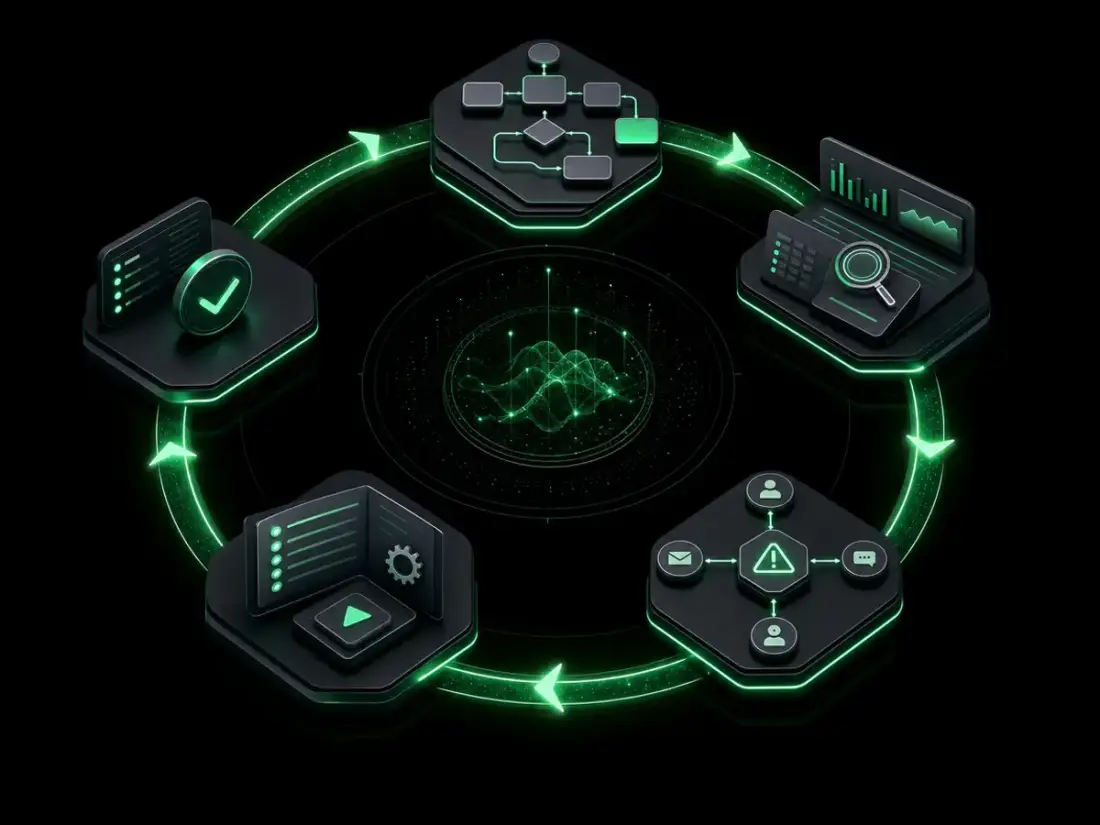
Die einfache Formel lautet: kritischer Workflow -> beobachtbares Signal -> Schwelle -> Eigentümer -> Eskalation -> Runbook -> Nachweis -> Review. Erst wenn diese Kette steht, wird aus einem Dashboard ein Betriebssystem.
Kritische Workflow-Signale
Für KMU müssen Signale nah am Geschäft liegen. Ein Kontaktformular kann regelmäßig synthetisch getestet werden: Testanfrage senden, Bestätigung prüfen, CRM-Testdatensatz erwarten, Alarm auslösen, wenn ein Schritt fehlt. Ein CRM-Sync kann die Anzahl "Lead erfasst" gegen "Lead sichtbar" vergleichen. Ein Rechnungsexport kann melden, wenn bis zu einer Uhrzeit kein Erfolgseintrag existiert.
Das Google SRE Book (Kapitel 6) spricht bei nutzerorientierten Systemen von Latenz, Traffic, Fehlern und Sättigung als den vier goldenen Signalen. Übersetzt in den KMU-Alltag heißt das: Wie lange dauert die Anfrage? Wie viele erfolgreiche Anfragen gibt es? Wo treten Fehler auf? Welche Warteschlange oder Schnittstelle läuft voll?
Eigentümer und Eskalation
Ein Alarm ohne Eigentümer ist nur ein Geräusch. Definieren Sie, wer die erste Bewertung macht, wer technisch eingreifen darf, wann ein externer Dienstleister beteiligt wird und wie Vertretung bei Urlaub oder Krankheit funktioniert.
Für viele Unternehmer ist genau das der Punkt, an dem das Sorglospaket relevant wird. Der Inhaber sollte nicht dauerhaft der Alarm-Router sein. Planfold kann Signalrouting, Runbooks und operative Pflege übernehmen, während Architektur, Workflows und Ausstiegsschlüssel dokumentiert bleiben.
Runbooks und Nachweise
Ein Runbook muss kein 40-seitiges Handbuch sein. Oft reicht eine klare Seite: Was ist passiert? Wo prüfe ich den Status? Welche Schritte sind erlaubt? Wann eskaliere ich? Welche Daten müssen nachträglich geprüft werden?
Die NIST SP 800-34 IT-Notfallplanung betont Tests, Übungen und die regelmäßige Pflege von Wiederherstellungsplänen. Für KMU bedeutet das pragmatisch: Ein grüner Backup-Job ist noch kein Wiederherstellungsnachweis. Ein dokumentierter Restore-Test ist einer.
Proof: Von manuellen Checks zu gemanagten Signalen
Lassen Sie uns ein konkretes Szenario betrachten: Ein spezialisierter Fachbetrieb für Heizungs- und Solartechnik mit 28 Mitarbeitenden. Jede Woche gehen rund 120 qualifizierte Projektanfragen über die Website und eine gemeinsame E-Mail-Inbox ein. Sabine, die Inhaberin und Geschäftsführerin, hat das Unternehmen digital gut aufgestellt. Das Team nutzt eine Website mit Anfrageformularen, ein CRM zur Kundenbetreuung, n8n für automatisierte Workflows sowie Cloud-Systeme für die Projektplanung. Doch im detail zeigt sich ein vertrautes Problem: Jedes System hat ein eigenes Dashboard, aber niemand sieht sicher, ob der geschäftskritische Anfrageprozess von der Formularabsendung bis zur Dispatching-Entscheidung durchgehend funktioniert.
Vorher: Ein Betrieb, der auf Symptome wartet
Im bisherigen unstrukturierten Zustand läuft die digitale Infrastruktur im Blindflug. Sabine schaut gelegentlich in die n8n-Ausführungsliste, wenn sie Zeit hat. Eines Freitags läuft jedoch das API-Token des CRM-Systems ab. Die Website nimmt Anfragen weiterhin an, aber die automatische Übergabe der HVAC-Planungsanfragen scheitert lautlos. Das Team merkt tagelang nichts, weil die Website-Uptime-Überwachung grün meldet.
Erst am Dienstagabend fällt auf, dass der Posteingang ungewöhnlich leer ist. Nun beginnt die hektische Fehlersuche: Logs prüfen, den API-Status manuell testen, die ausgefallenen n8n-Ausführungen filtern und die verlorenen Leads mühsam rekonstruieren. In der Zwischenzeit sind potenzielle Kunden zur Konkurrenz abgewandert. Die Reparaturkosten summieren sich auf mehrere Arbeitsstunden, während das Vertrauen in den digitalen Kanal schwindet. Die Sichtbarkeit im Dashboard war vorhanden, eine strukturierte Erkennung fehlte jedoch völlig.
Nachher: Eine digitale Maschine mit Reaktionswegen
Planfold führt den Betrieb zu einem gemanagten Signalmodell. Der gesamte Anfrageprozess wird in n8n sauber gemappt. Wenn ein Fehler wie ein abgelaufenes API-Token auftritt, fängt ein n8n-Fehler-Workflow das Ereignis sofort ab und leitet ein scharfes Signal an Markus, den Operations Lead, weiter. Das Signal enthält den genauen Fehlertyp und einen direkten Link zur betroffenen n8n-Ausführung.
Zusätzlich führt Planfold klare Entscheidungspfade und Freigabegates ein:
- Entscheidungspfad (Decision Point): Eingehende HVAC-Projektanfragen mit einem geschätzten Volumen von über 25.000 Euro werden automatisch als High-Priority klassifiziert und an ein gesondertes CRM-Board übergeben.
- Review-Gate: Für diese High-Priority-Projekte generiert die n8n-Pipeline auf Basis der Kundendaten und historischer Planungsdaten einen ersten Angebotsentwurf. Dieser Entwurf wird jedoch nicht automatisch versendet. Er verbleibt in einem Freigabegate, in dem Sabine das Angebot im n8n-Dashboard prüft, anpasst und erst nach Klick freigibt.
- Audit-Trail: Jede Systementscheidung, jede Fehlermeldung und jede menschliche Freigabe durch Sabine wird in einem revisionssicheren Log aufgezeichnet.
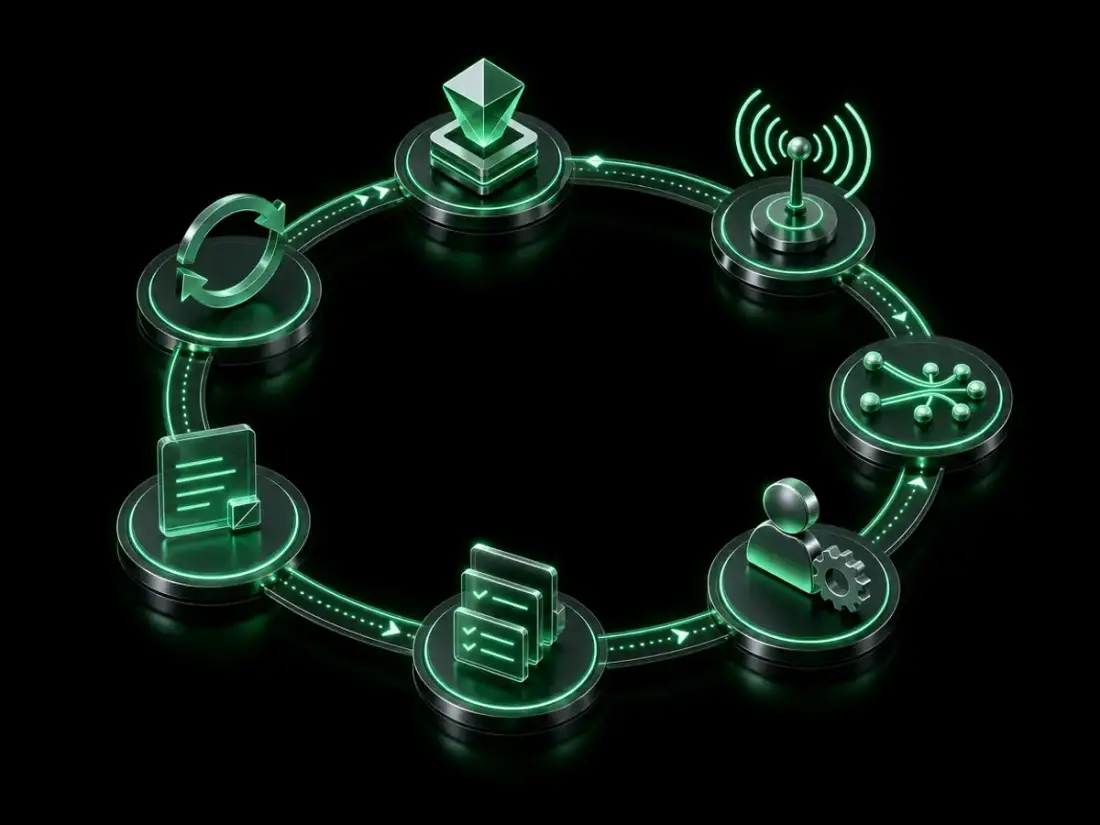
n8n unterstützt solche Muster mit Ausführungsstatus, Retry-Möglichkeiten und Error Workflows. Das ersetzt keine Tests und keine Verantwortung, aber es macht aus "jemand sollte ins Dashboard schauen" ein Signal, das einen definierten Weg nimmt.
Wie Planfold zuverlässige digitale Operations einordnet
Planfold behandelt Monitoring nicht als separates Kontrollkästchen. Es gehört zur digitalen Maschine: zur Architektur, zu den Workflows, zu den Menschen, die reagieren müssen, und zu den Nachweisen, die zeigen, dass der Betrieb gepflegt wird.
Für KMU, Mittelstand, Handwerk und Solo-Gründer ist das Ziel nicht ein großes Observability-Programm. Das Ziel ist ein System, das wichtige Abläufe nicht still scheitern lässt und das auch dann verständlich bleibt, wenn die zuständige Person gerade nicht verfügbar ist.
Plan: Kartieren, was nicht still ausfallen darf
In der Plan-Phase werden kritische Geschäftsabläufe, Abhängigkeiten, Eigentümer und Fehlerbedingungen erfasst. Welche Anfrage bringt Umsatz? Welcher Export löst Abrechnung aus? Welche Automatisierung darf nicht unbemerkt hängen bleiben? Welche Wiederherstellung muss wirklich getestet werden?
Das Ergebnis ist keine Tool-Liste, sondern eine Priorisierung. Erst wenn klar ist, was "kaputt" für den Betrieb bedeutet, lohnt sich die Auswahl des Signals.
Unfold: Monitoring in das System bauen
In der Umsetzung entstehen synthetische Checks, Workflow-Telemetrie, Alert-Routing, Runbooks, Log-Aufbewahrung, Backup-Prüfungen und saubere Übergabewege. Die Technik wird nicht dekorativ daneben gestellt, sondern in den Ablauf eingebaut.
Gerade bei n8n, CRM, Buchhaltung und Website-Formularen ist das wichtig. Die kritischen Fehler passieren oft zwischen Systemen, nicht innerhalb eines einzelnen Tools.
Resonate: Vorfälle in operative Lernschleifen verwandeln
Nach einem Vorfall muss das System besser werden. Welche Erkennung war zu spät? Welche Warnung war zu laut? Welcher Schritt im Runbook fehlte? Welche Information hätte der Inhaber früher gebraucht?
Resonate bedeutet, diese Erkenntnisse regelmäßig in Dokumentation, Signale und Übergaben zurückzuführen. So entsteht Betriebssicherheit, die nicht von Erinnerung abhängt.
Ein praktischer Startpunkt für KMU und Startups
Beginnen Sie nicht mit zehn Tools. Beginnen Sie mit einem umsatznahen Workflow. Für viele Betriebe ist das die Anfrage, Buchung, Zahlung, Rechnung oder ein automatisierter Übergang ins CRM.
Schreiben Sie den Ablauf einmal nüchtern auf: Auslöser, erwartetes Ergebnis, Erfolgssignal, Fehlersignal, Eigentümer, Eskalation, Runbook, Nachweis und Review-Rhythmus. Wenn Sie diese neun Punkte nicht beantworten können, ist der Workflow noch nicht betrieblich geführt.
Starten Sie mit einem kritischen Workflow
Wählen Sie den Ablauf, bei dem ein stiller Fehler am meisten schadet. Testen Sie nicht nur, ob die Website lädt. Testen Sie, ob der Kundenwunsch wirklich im zuständigen System ankommt und bearbeitbar wird.
Ein einzelner sauber geführter Workflow schafft mehr Stabilität als fünf neue Dashboards. Er zeigt, welche technischen Signale tatsächlich geschäftsrelevant sind.
Definieren Sie das Signal vor dem Tool
Viele Monitoring-Projekte starten falsch herum. Zuerst wird ein Tool gesucht, danach wird überlegt, was es melden soll. Besser ist die umgekehrte Reihenfolge: Geschäftsereignis, Fehlerbedingung, Eigentümer, Reaktion, erst dann Werkzeug.
Das hält den Betrieb schlank. Sie vermeiden Alert-Lärm und bauen stattdessen wenige Signale, die echte Entscheidungen auslösen.
Das eigentliche Ergebnis: Probleme finden, bevor Kunden es tun
Manuelles Monitoring ist nicht falsch, weil Menschen unaufmerksam sind. Es ist riskant, weil moderne Geschäftsabläufe zu viele Abhängigkeiten haben, um zuverlässig im Kopf behalten zu werden.
Ein robustes Betriebsmodell macht aus verstreuten Dashboards eine klare Kette: Was ist kritisch, welches Signal zählt, wer reagiert, was passiert dann und welcher Nachweis bleibt? Genau dort beginnt digitale Souveränität im Alltag. Nicht beim nächsten Dashboard, sondern bei einem System, das früher sieht, klarer eskaliert und aus Vorfällen lernt.
Verwandte Artikel
Rancher 2.15: Monitoring sicher auf den Upstream-Stack migrieren
Website-Modernisierung für traditionelle KMU: Vom digitalen Schaukasten zum Vertrauens- und Passungsfilter