Backup-Angst: Warum ein Backup noch kein Wiederherstellungsplan ist
Viele Unternehmen wiegen sich in Sicherheit, weil sie "Backups" haben. Doch ein ungetestetes Backup ist nur eine Hoffnung. Erfahren Sie, wie Sie Backup-Angst in Wiederherstellungs-Gewissheit verwandeln.
Inhalt
Viele Unternehmen wiegen sich in Sicherheit, weil sie "Backups" haben. Doch ein ungetestetes Backup ist nur eine Hoffnung. Erfahren Sie, wie Sie Backup-Angst in Wiederherstellungs-Gewissheit verwandeln.
Artikel teilen
Das falsche Gefühl von Sicherheit
"Keine Sorge, wir haben ein Backup."
Dieser Satz klingt beruhigend, bis jemand nach dem Wiederherstellungsplan fragt. Wo liegt das Backup genau? Wer hat Zugriff? Welche Systeme müssen zuerst starten? Wie alt dürfen die Daten sein? Wie lange darf der Betrieb stillstehen? Und wann wurde zuletzt bewiesen, dass aus der Sicherung wirklich wieder ein funktionierendes System entsteht?
Viele Unternehmen können die erste Frage noch beantworten. Bei den weiteren wird es schnell unscharf.
Das ist Backup-Angst: nicht die Angst, dass gar keine Kopie existiert, sondern die Ahnung, dass zwischen einer Kopie und einem wieder laufenden Betrieb eine gefährliche Lücke liegt. Diese Lücke bleibt im Alltag unsichtbar. Das Backup-Dashboard zeigt grün. Die Rechnung für den Speicher wird bezahlt. Der Dienstleister bestätigt, dass "alles gesichert" ist. Erst im Ernstfall zeigt sich, ob diese Aussage belastbar war.
Ein Backup ist eine Datenkopie. Ein Wiederherstellungsplan ist ein betrieblicher Ablauf. Er verbindet Daten, Infrastruktur, Zugänge, Reihenfolge, Verantwortlichkeiten und Entscheidungsgrenzen. Wenn dieser Ablauf nicht getestet ist, besitzt Ihr Unternehmen keine Wiederherstellungsfähigkeit. Es besitzt eine Hoffnung.
Für kleine und mittlere Unternehmen ist das besonders kritisch. Ein verlorener Tag im Kundenportal, in der Warenwirtschaft, im Buchungssystem oder in der internen Wissensbasis ist nicht nur ein IT-Vorfall. Es ist Support-Druck, Umsatzverlust, Reputationsschaden und Managementstress zugleich.
Warum Backups im Alltag besser aussehen, als sie sind
Backup-Systeme scheitern selten spektakulär. Meist wirken sie lange zuverlässig, weil sie nur den einfachsten Teil messen: Wurde eine Sicherung geschrieben?
Das beantwortet noch nicht die entscheidenden Fragen:
- Ist das Backup vollständig oder fehlen abhängige Datenbanken, Uploads, Secrets oder Konfigurationsdateien?
- Ist die Sicherung lesbar oder wurde sie nie aus dem Archiv zurückgeladen?
- Ist sie gegen Ransomware geschützt oder kann ein Angreifer sie mit denselben Zugangsdaten löschen?
- Passt die Wiederherstellung zur tatsächlichen Ausfalltoleranz des Unternehmens?
- Sind die Personen, die den Restore ausführen sollen, im Notfall verfügbar und berechtigt?
Das Problem ist also selten "kein Backup". Das Problem ist ein zu schmales Verständnis von Schutz. Viele Setups sichern Daten, aber nicht Betriebsfähigkeit. Sie speichern Datenbanken, aber nicht die Infrastrukturdefinition. Sie kopieren Dateien, aber nicht die Reihenfolge, in der Dienste wieder starten müssen. Sie verlassen sich auf eine Plattform, ohne zu klären, ob ein Export schnell genug, vollständig genug und unabhängig genug möglich ist.
Dadurch entsteht ein gefährlicher psychologischer Effekt: Je länger kein Vorfall passiert, desto stärker fühlt sich das Backup-Konzept an. In Wirklichkeit wurde es nur nie geprüft.
Die Wiederherstellungslücke: Backup vs. Restore
Stellen Sie sich ein realistisches Szenario vor. Ein Mitarbeiter löscht am Montagmorgen versehentlich eine Produktionsdatenbanktabelle. Kurz darauf schlägt ein automatischer Synchronisationsjob an und verteilt den Schaden in mehrere Systeme. Das Team bemerkt den Fehler nicht sofort, weil die Anwendung noch erreichbar ist. Erst gegen Mittag melden Kunden fehlende Daten.
Jetzt beginnt die eigentliche Prüfung.
Zuerst muss geklärt werden, welcher Wiederherstellungszeitpunkt der richtige ist. Wird auf 08:55 Uhr zurückgesetzt, fehlen alle legitimen Änderungen danach. Wird auf 11:45 Uhr zurückgesetzt, bleibt ein Teil des Schadens erhalten. Parallel muss entschieden werden, ob das gesamte System zurückgerollt wird oder nur eine Datenbank. Beides hat Folgen: Ein vollständiger Rollback ist sauberer, kann aber mehr Nutzerdaten verlieren. Ein selektiver Restore ist präziser, erfordert aber bessere technische Vorbereitung.
Dann kommen die Abhängigkeiten. Die Datenbank allein reicht nicht. Anwendungsversion, Hintergrundjobs, Dateiablage, Suchindex, Cache, Authentifizierung und Schnittstellen müssen zum gewählten Datenstand passen. Wenn die Anwendung inzwischen Migrationen ausgeführt hat, kann ein älteres Datenbankschema mit dem aktuellen Code unvereinbar sein. Wenn Datei-Uploads und Datenbankeinträge auseinanderlaufen, wirken Kundendatensätze nach dem Restore weiterhin beschädigt.
In einem getesteten Wiederherstellungsprozess läuft nun eine klare Kette ab:
- Vorfall einfrieren: Schreibzugriffe stoppen, Logs sichern, betroffene Systeme markieren.
- Wiederherstellungspunkt wählen: Datenverlustfenster und Geschäftsfolgen bewerten.
- Temporäre Umgebung starten: Backup nicht direkt in Produktion einspielen, sondern zuerst prüfen.
- Integrität testen: Anwendung booten, Stichproben ausführen, kritische Workflows prüfen.
- Entscheidung dokumentieren: Management, Support und Fachbereich verstehen, was zurückgesetzt wird.
- Produktions-Restore durchführen: Reihenfolge, Zugänge und Verantwortlichkeiten sind vorher festgelegt.
- Nachprüfung abschließen: Monitoring, Datenkonsistenz und Kundenkommunikation laufen nach Plan.
Ohne diesen Ablauf wird aus einem technischen Vorfall eine improvisierte Krisensitzung. Niemand weiß, welche Daten geopfert werden dürfen. Niemand kennt die Reihenfolge. Niemand möchte die Verantwortung für den finalen Restore übernehmen. Die Ausfallzeit wächst nicht, weil das Backup fehlt, sondern weil jede Entscheidung erst im Stress getroffen wird.
Genau das ist die Wiederherstellungslücke.
RTO und RPO: Die zwei Zahlen, die ein Backup ehrlich machen
Wer Backup-Qualität bewerten will, braucht zwei Begriffe: RTO und RPO.
RTO (Recovery Time Objective) beschreibt, wie lange ein System ausfallen darf, bevor der Schaden geschäftlich nicht mehr akzeptabel ist. Ein internes Archiv kann vielleicht 24 Stunden offline sein. Ein Buchungssystem oder Kundenportal braucht möglicherweise eine Wiederherstellung innerhalb von ein bis zwei Stunden.
RPO (Recovery Point Objective) beschreibt, wie viel Datenverlust akzeptabel ist. Bei erfolgreichen Sicherungen im Abstand von 24 Stunden können seit dem letzten nutzbaren Wiederherstellungspunkt fast 24 Stunden an Änderungen fehlen. Fehlgeschlagene oder unbrauchbare Sicherungen vergrößern dieses Fenster. Für manche Systeme ist das tolerierbar. Für Bestellungen, Support-Tickets, Produktionsdaten oder Buchungen ist es oft nicht akzeptabel.
Diese Zahlen zwingen zu Ehrlichkeit. "Wir haben ein Backup" klingt gut. "Unser RTO beträgt acht Stunden und unser RPO beträgt 15 Minuten, getestet am letzten Monatsende" ist belastbar. Erst dann kann das Management entscheiden, ob das Risiko zum Geschäftsmodell passt.
RTO und RPO sind keine rein technischen Kennzahlen. Sie sind Geschäftsentscheidungen. Wenn ein System 2.000 Euro Umsatz pro Stunde verarbeitet, hat eine achtstündige Wiederherstellung eine andere Bedeutung als bei einem internen Wiki. Wenn regulatorische oder vertragliche Pflichten gelten, muss das Datenverlustfenster entsprechend enger sein. Genau deshalb sollten Finance, Operations, Fachbereich und Technik diese Werte gemeinsam festlegen.
Der technische Deep-Dive: Was eine belastbare Backup-Architektur leisten muss
Die klassische 3-2-1-Regel bleibt ein sinnvoller Ausgangspunkt: drei Kopien der Daten, auf zwei unterschiedlichen Speichermedien oder Speicherarten, davon eine Kopie außerhalb des primären Standorts. In modernen Umgebungen muss diese Regel erweitert werden. Eine Kopie im selben Cloud-Konto ist kein unabhängiges Sicherheitsnetz, wenn kompromittierte Zugangsdaten alle Ebenen erreichen. Eine Offsite-Kopie ist nur dann wertvoll, wenn sie auch ohne den primären Anbieter nutzbar ist.
Deshalb gehört Immutable Storage in jede ernsthafte Wiederherstellungsstrategie. Unveränderliche Speichermechanismen verhindern, dass Backups innerhalb einer definierten Aufbewahrungsfrist gelöscht oder überschrieben werden. Das schützt nicht nur gegen Ransomware, sondern auch gegen fehlerhafte Automatisierung, interne Fehlbedienung und kompromittierte Administratorzugänge. Wichtig ist die technische Trennung: Wer Produktionssysteme verwaltet, sollte nicht ohne zusätzliche Hürden das letzte Sicherheitsnetz entfernen können.
Genauso wichtig ist die Wiederherstellung der Infrastruktur. Wenn Sie nur Daten sichern, aber Server, Netzwerke, DNS, Secrets, Berechtigungen und Deployment-Prozesse manuell rekonstruieren müssen, bleibt der Restore langsam und fehleranfällig. Infrastructure as Code, dokumentierte Runbooks und automatisierte Umgebungserstellung machen aus einem Backup erst eine reproduzierbare Wiederherstellung.
Automated Recovery Testing ist der entscheidende Qualitätsnachweis. Dabei wird nicht nur geprüft, ob eine Datei existiert. Das Backup wird regelmäßig in einer isolierten Umgebung wiederhergestellt, die Anwendung startet, Kernprozesse laufen durch, und das Ergebnis wird protokolliert. So entsteht ein auditierbarer Nachweis: Nicht "wir glauben, dass es funktioniert", sondern "wir haben es zuletzt am konkreten Datum erfolgreich getestet".
Eine robuste Architektur kombiniert deshalb mehrere Ebenen:
- 3-2-1-Backups mit logisch getrenntem Offsite-Ziel
- unveränderliche Aufbewahrung für kritische Sicherungen
- Point-in-Time-Recovery für Datenbanken mit engen RPO-Anforderungen
- Infrastrukturdefinitionen, Secrets-Prozesse und Runbooks für den Neuaufbau
- automatisierte Restore-Tests in isolierten Umgebungen
- klare Eskalations- und Kommunikationswege für den Ernstfall
Das ist keine übertriebene Enterprise-Komplexität. Es ist die technische Grundlage dafür, dass ein Unternehmen im Ernstfall handlungsfähig bleibt.
Warum Souveränität bei Backups entscheidend ist
Viele SaaS-Anbieter werben mit Backups. Das ist nützlich, aber nicht dasselbe wie Backup-Eigentum. Wenn Ihre Daten, Sicherungen, Exporte, Wiederherstellungslogik und Zugänge vollständig in einer Plattform liegen, hängt Ihre Krisenfähigkeit von den Regeln dieses Anbieters ab.
Was passiert, wenn Ihr Konto gesperrt wird? Wenn ein Support-Ticket auf Priorität "normal" steht, obwohl Ihr Betrieb stillsteht? Wenn der Export nur in einem proprietären Format möglich ist? Wenn die Plattform zwar einzelne Objekte wiederherstellen kann, aber keinen vollständigen, konsistenten Systemzustand? Wenn Preismodell oder Vertragsgrenzen genau dann zum Thema werden, wenn Sie unter Druck stehen?
Planfolds Souveränitätsansatz setzt an dieser Stelle an. Das Ziel ist nicht, jede Bequemlichkeit abzuschaffen. Ein Sorglospaket darf weiterhin Updates, Sicherheit, Monitoring, Backups und Routinebetrieb übernehmen. Entscheidend ist, dass Sie den Ausstiegsschlüssel behalten: verständliche Architektur, dokumentierte Datenflüsse, portable Komponenten, nachvollziehbare Zugänge und Wiederherstellungswege, die nicht vollständig an einen einzelnen SaaS-Anbieter gebunden sind.
In dieser Logik ist ein Backup kein fremdes Versprechen, sondern Teil Ihres digitalen Vermögenswerts. Sie besitzen nicht nur die Anwendung, sondern auch den Weg zurück in einen funktionsfähigen Zustand. Genau darin liegt der Unterschied zwischen gemieteter Bequemlichkeit und souveränem Betrieb.
Von Backup-Angst zu Wiederherstellungs-Gewissheit
Der praktische Weg beginnt nicht mit einem Großprojekt. Er beginnt mit einer ehrlichen Bestandsaufnahme.
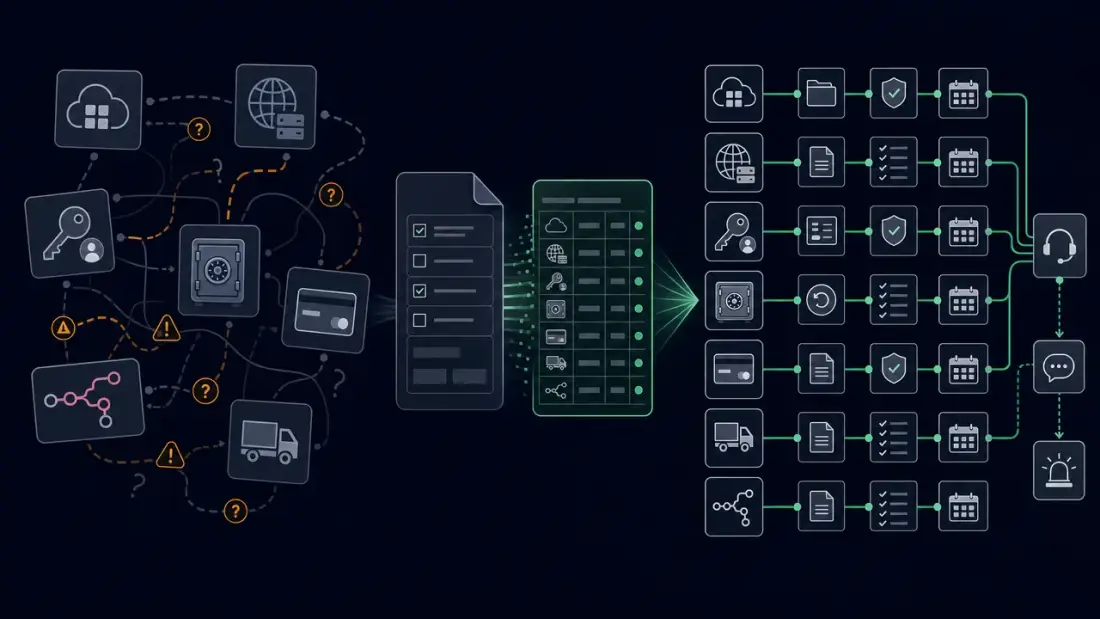
Welche Systeme sind geschäftskritisch? Welche RTO- und RPO-Werte gelten wirklich? Wo liegen die Backups? Wer kann sie wiederherstellen? Wurde der Restore in den letzten 90 Tagen getestet? Welche Abhängigkeiten müssten vorher online sein? Welche Kommunikationsvorlagen braucht Support, wenn Kundendaten betroffen sind? Welche Daten dürfen aus rechtlichen oder geschäftlichen Gründen nicht verloren gehen?
Aus diesen Antworten entsteht ein Wiederherstellungsplan. Er muss kurz genug sein, um im Notfall nutzbar zu bleiben, und präzise genug, um Entscheidungen aus dem Krisenmoment herauszunehmen. Gute Pläne enthalten Rollen, Reihenfolge, Zugangspfade, Testkriterien, RTO/RPO-Ziele und eine Nachbereitungsroutine.
Die wichtigste Veränderung ist kulturell: Backups werden nicht mehr als einmalige Einrichtung betrachtet, sondern als laufende Fähigkeit. Jede neue Anwendung, jede Integration und jede Datenbank muss die Frage beantworten: Wie stellen wir das wieder her, und wann haben wir es zuletzt bewiesen?
Dann verschwindet Backup-Angst nicht durch Optimismus, sondern durch Nachweis.
Warten Sie nicht auf die Krise, um Ihren Plan zu testen
Ihre digitale Infrastruktur sollte kein stiller Risikofaktor sein. Sie sollte eine verlässliche Maschine sein, deren Ausfallwege bekannt, getestet und dokumentiert sind.
Planfold entwirft und betreibt digitale Systeme als Vermögenswerte: mit Sorglospaket im Alltag und Ausstiegsschlüssel im Ernstfall. Dazu gehören Backup-Strategie, Wiederherstellungsarchitektur, Automatisierung, technische Dokumentation und ein klares Verständnis davon, wer im Notfall welche Entscheidung treffen kann.
Sichern Sie Ihre digitale Souveränität und prüfen Sie, ob Ihr Backup-Konzept wirklich wiederherstellungsfähig ist.